GEO数据挖掘
·
整理自生信技能树小洁老师授课内容
图表介绍
热图
- 输入数据输入数据是**数值型矩阵/数据框**
- 颜色的变化表示数值的大小
热图类别
- 相关性热图
- 差异基因热图
1. 散点图
2. 箱线图
- 输入数据是一个连续型向量和一个有重复值的离散型向量 即 分类变量
- 图解:包括 min max median 25% 75% 离群点
- 单个基因在两组之间的表达量差异
3. 火山图
-
横坐标:logFC,纵坐标:-log10(P.value)
FoldChange (FC):处理组平均值 对照组平均值 logFC:Foldchange 取 log2 -
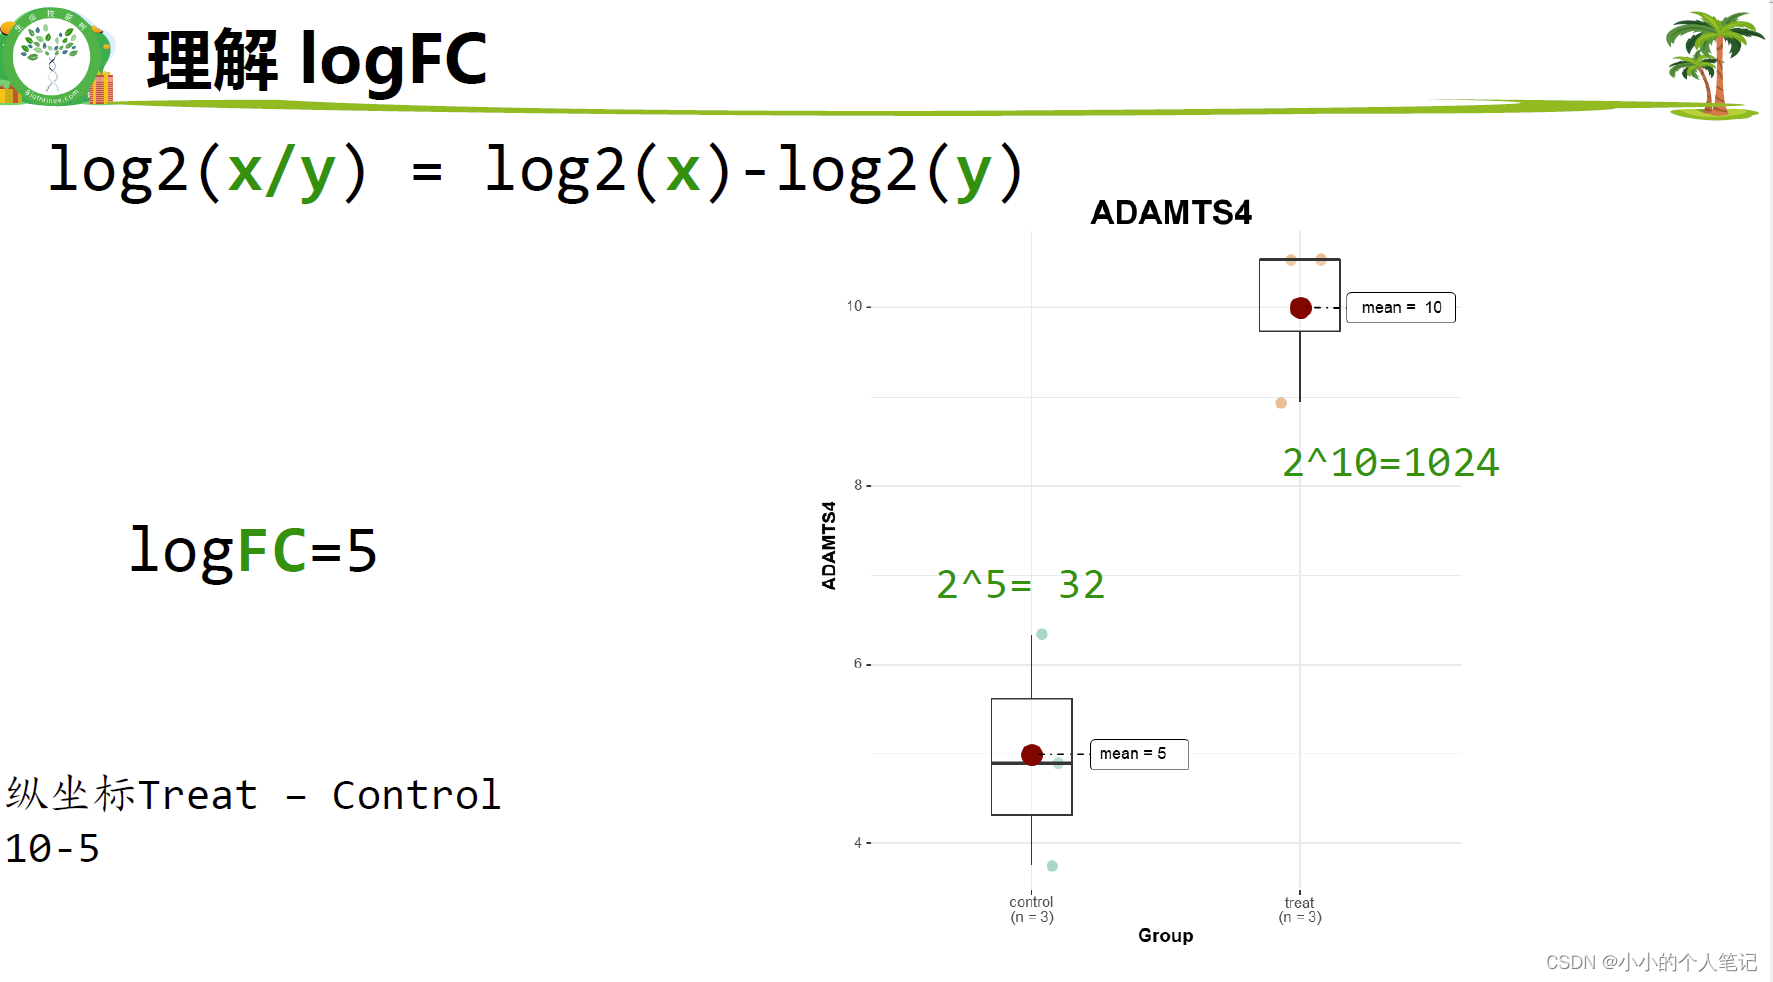
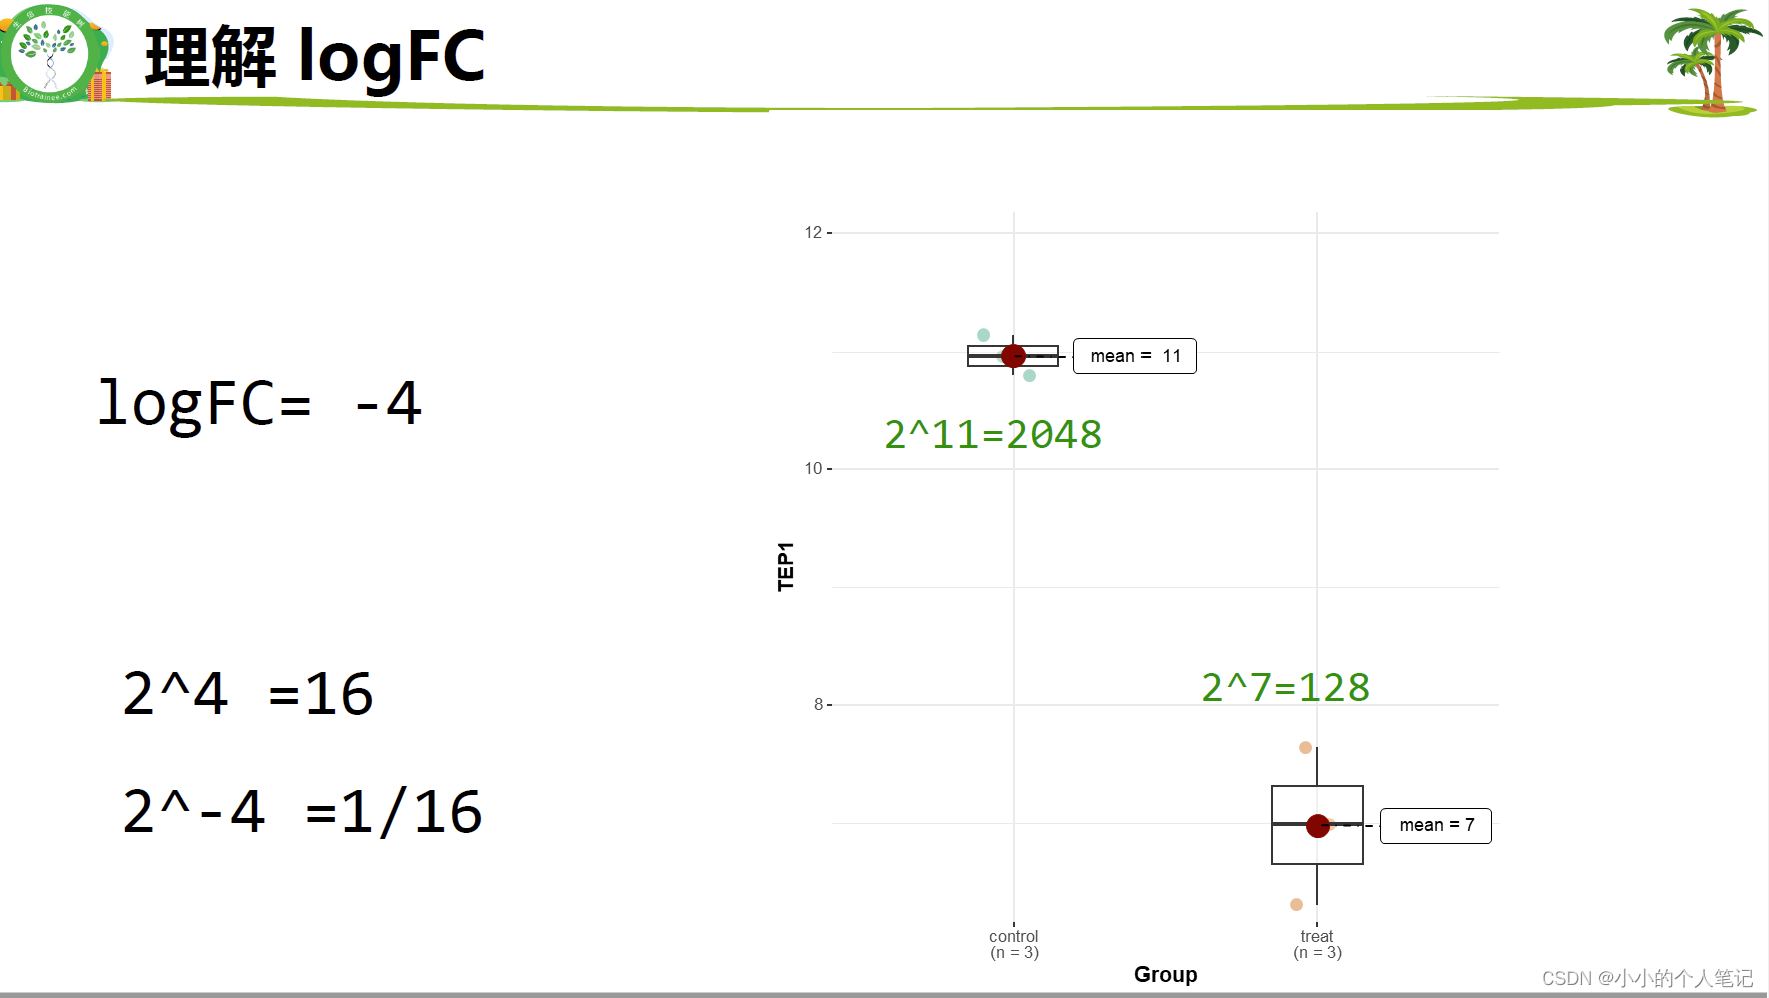
理解 logFC,一定是**处理组-对照组**
-
logFC 一般 <20 才正常
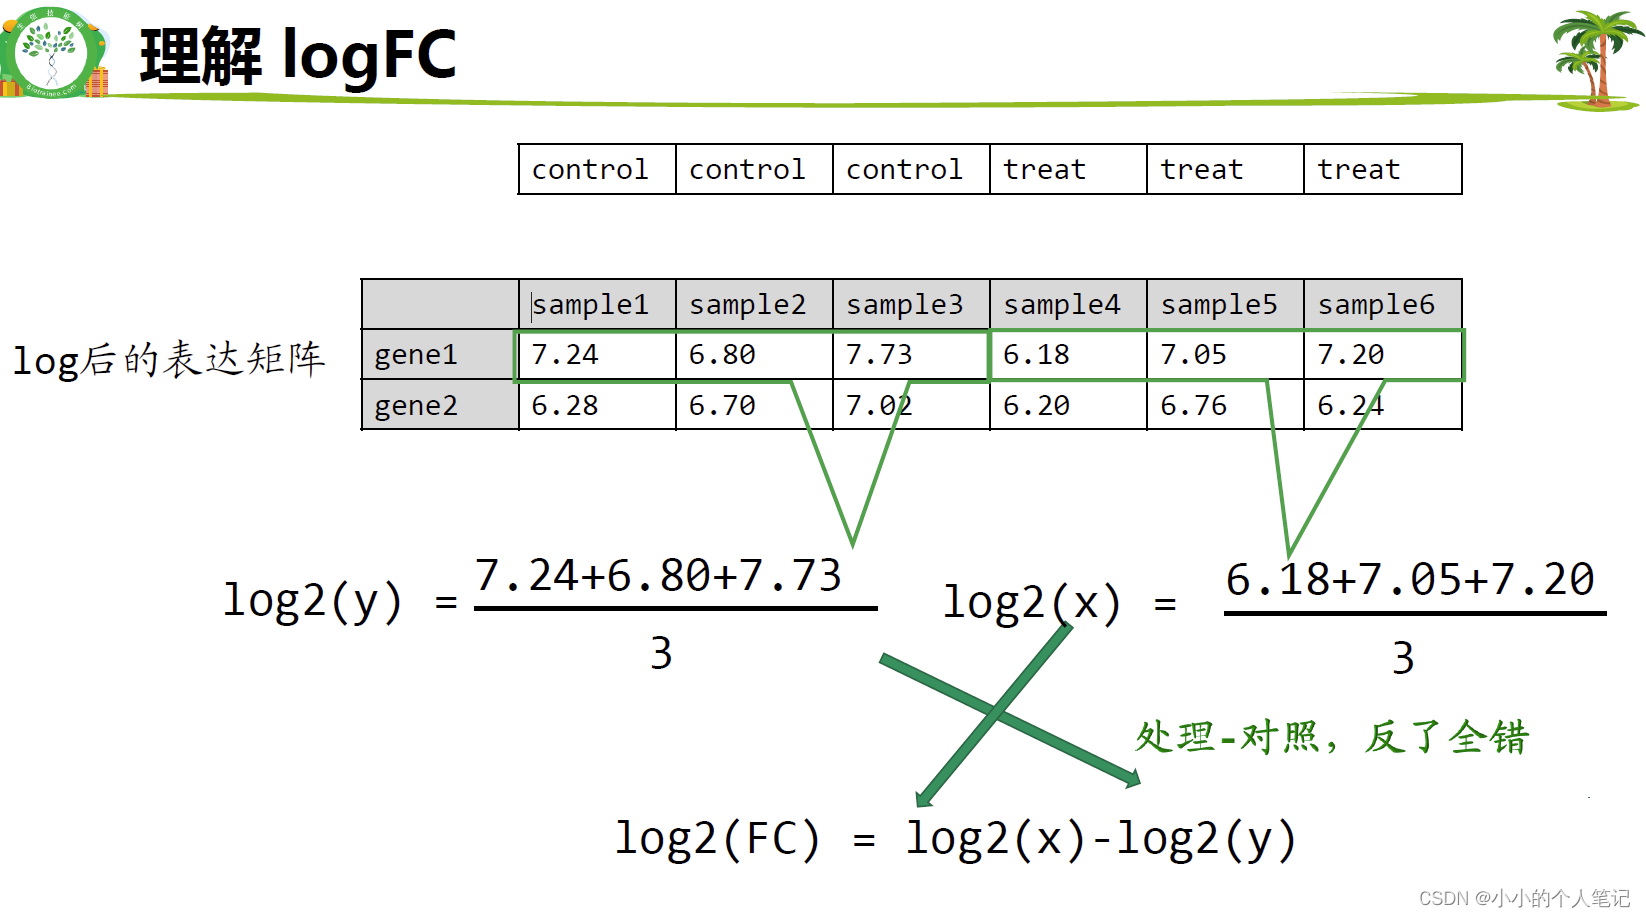
1)logFC>0,treat>control ,基因表达量上升
2)logFC<0,treat<control ,基因表达量下降
3)通常所说的上调、下调基因是指表达量显著 上升/下降的基因 (结合P值)
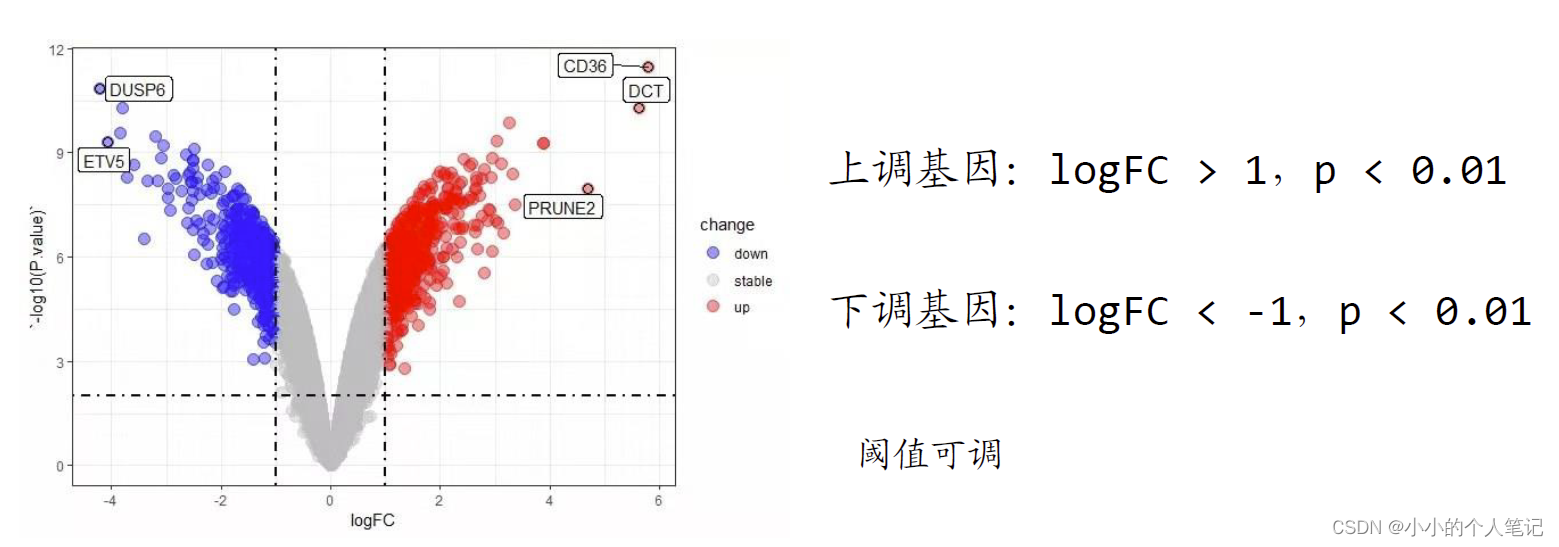
4)logFC的常见阈值,没有标准答案
1、2、1.2、1.5、2.2、0.585(=log2(1.5))
-
差异分析结果 limma
P值越小,越有信心认为差异显著,-log10( P-value)越大
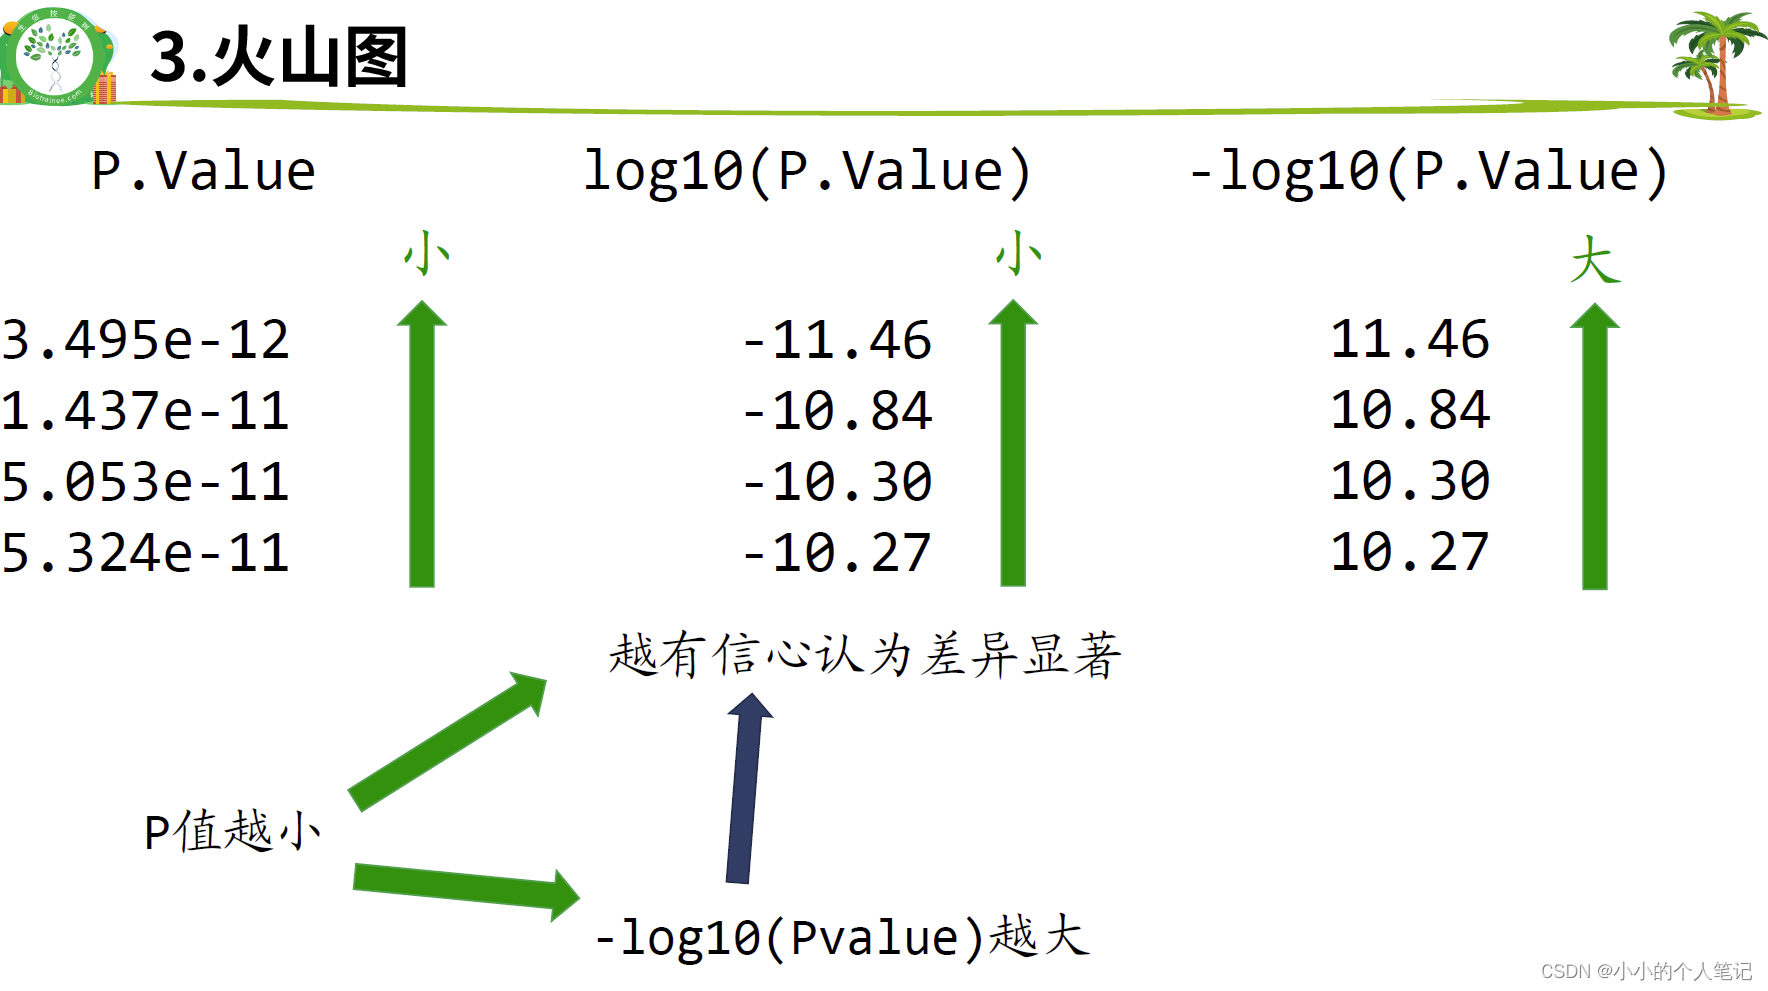
以上图片来自生信技能树小洁老师
4. 主成分分析(PCA)
- 主成分分析,旨在利用降维的思想,把多指标转化为少数几个综合指标(即主成分)
- 根据这些主成分对样本进行聚类,代表样本的点在坐标轴上距离越远,说明样本差异越大。
- PCA样本聚类图
1)图上的点代表样本(中心点除外)
2)点与点之间的距离代表样本与样本之间的差异 - 用于“预实验”,简单查看组间是否有差别
1)同一分组是否聚成一簇(组内重复好)
2)中心点之间是否有距离(组间差别大)
2. GEO背景介绍及分析思路
1. 表达数据实验设计
- 实验目的:实验目的:通过基因表达量数据的差异分析和富集分析来解释生物学现象
- 组别设计
- 流程:不同处理 – 差异基因 – 找功能、找关联、找机制、同一通路有多个基因表达变化 – 解释差异,缩小基因范围
2. 数据库介绍
-
NCBI:Gene Expression Omnibus – Browse Content
-
流程:
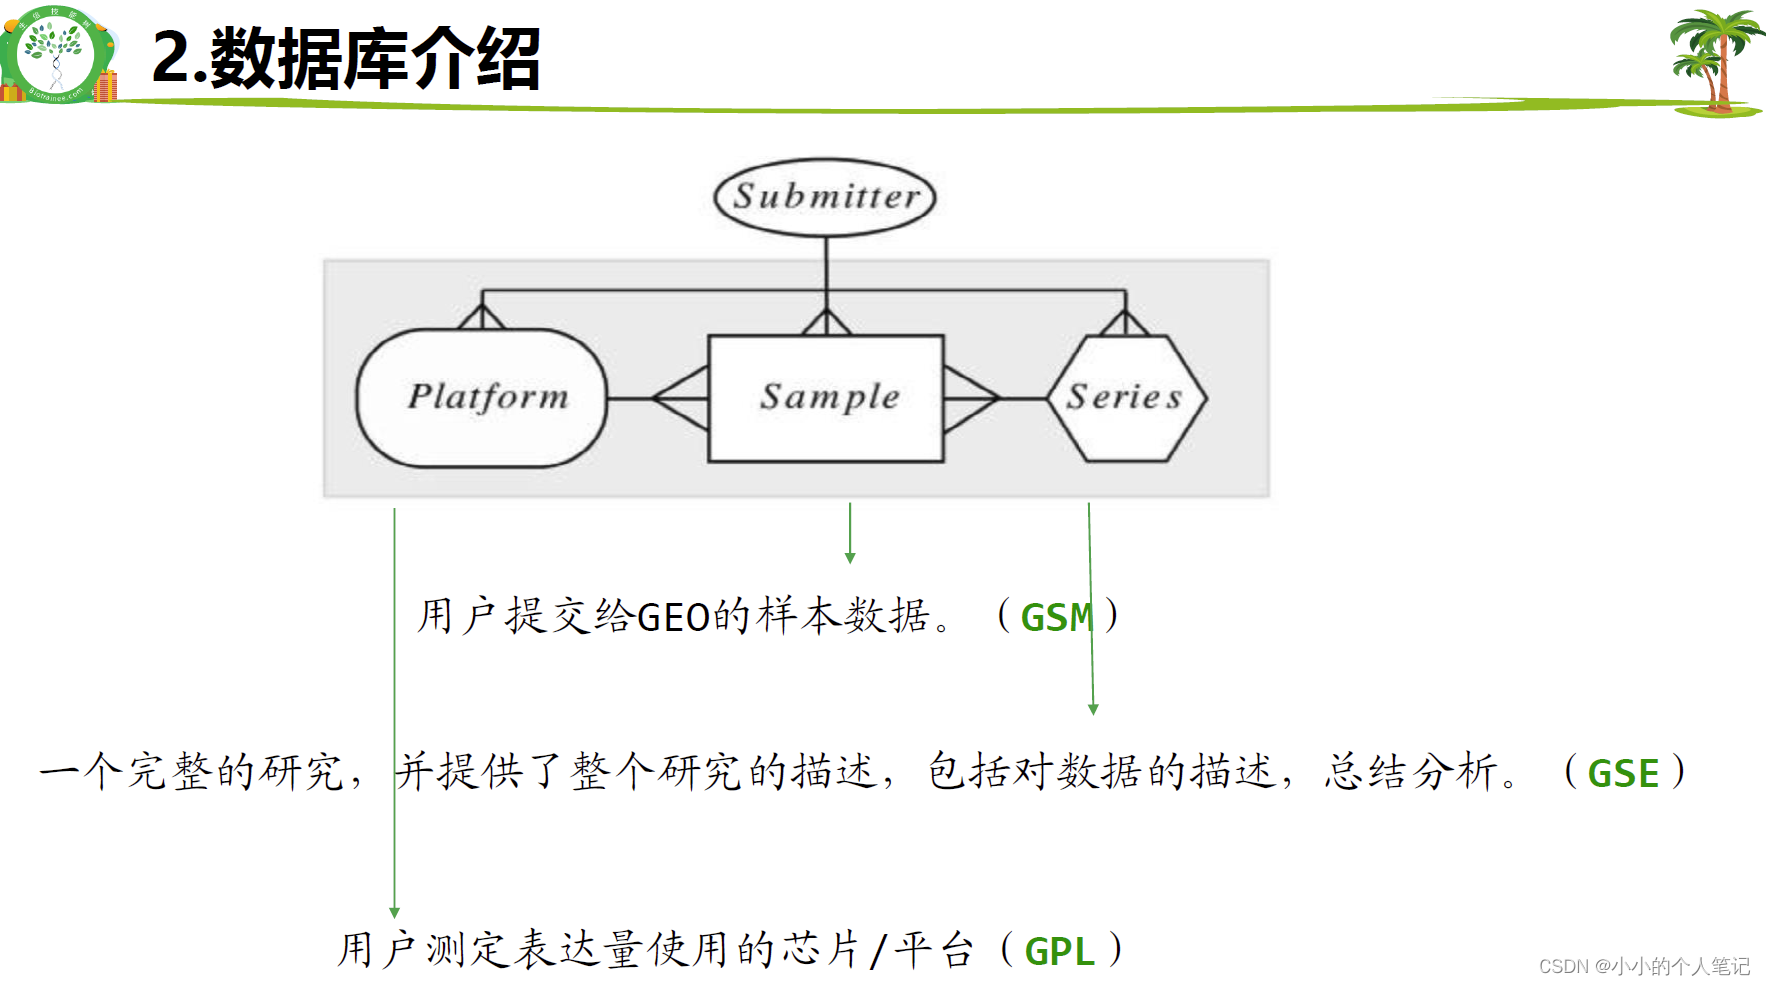
-
基因表达芯片的原理
探针的表达量代表基因的表达量 -
分析思路
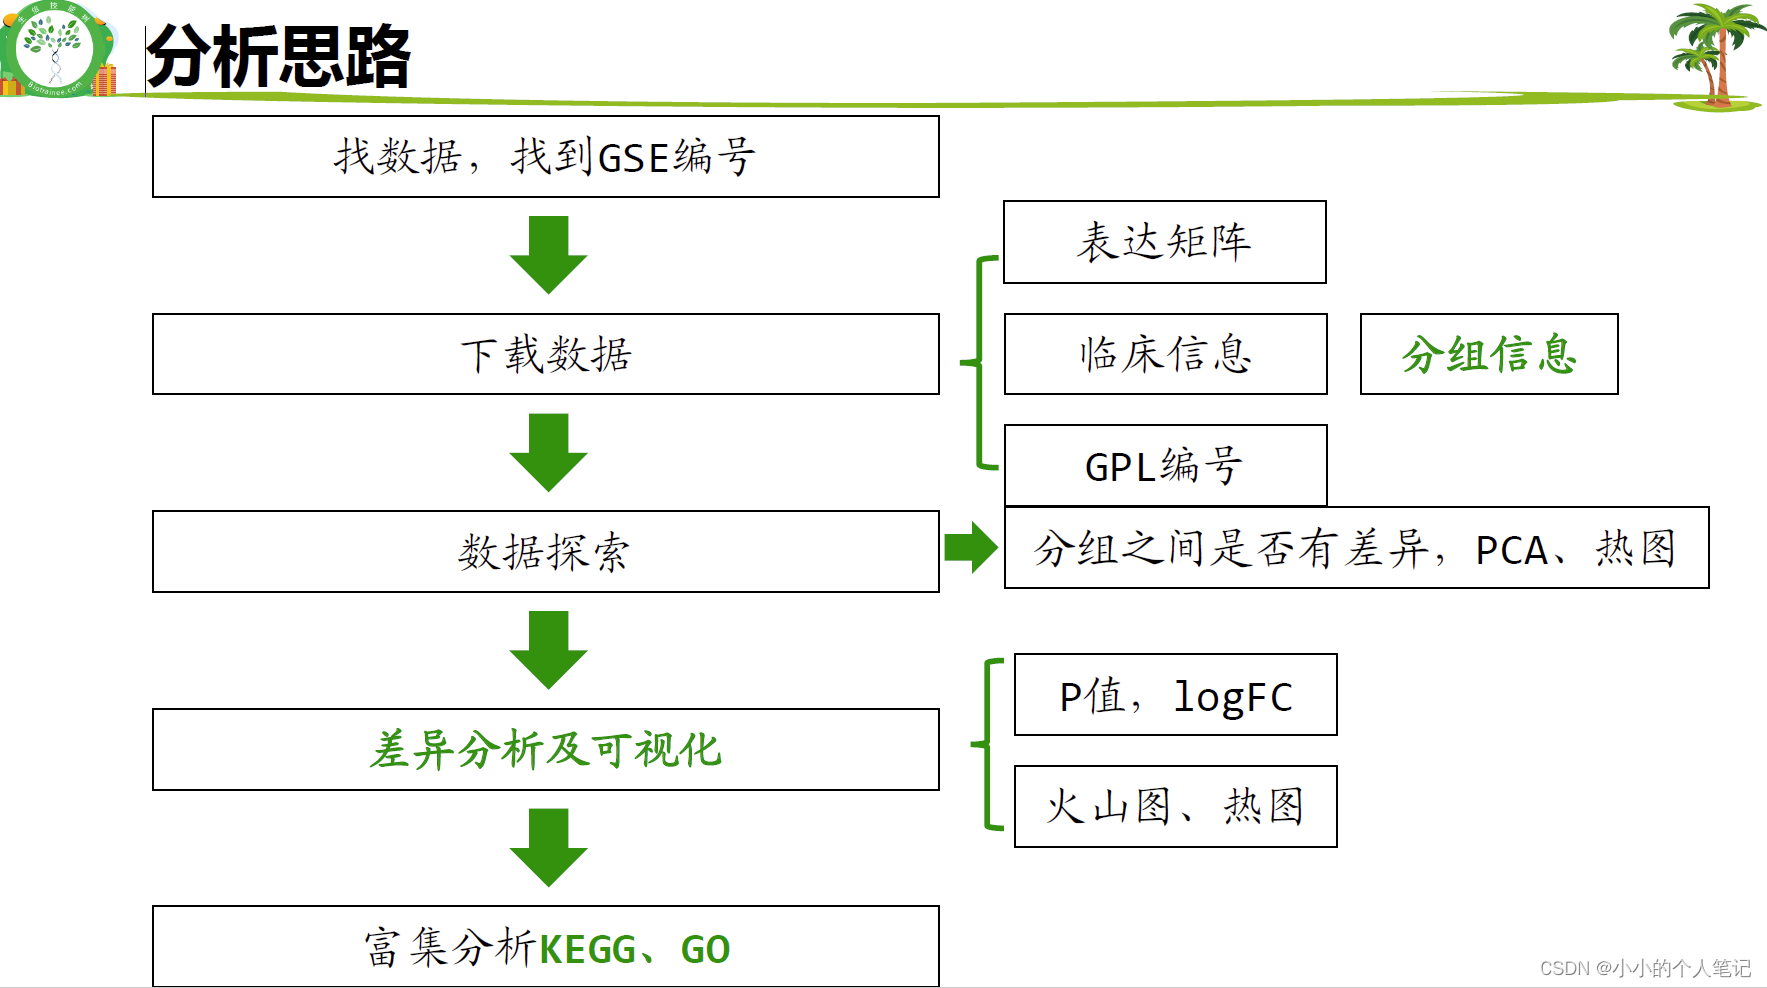
3. 表达矩阵
GSM,样本编号
需要分组信息
需要转换为 gene symbol
4. 富集分析
代码分析流程
复杂数据分析

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)