机器学习-(手推)线性回归3-正则化-岭回归(Ridge)-频率角度&贝叶斯角度
·
一、正则化-岭回归-频率角度
回顾:
Loss Function:
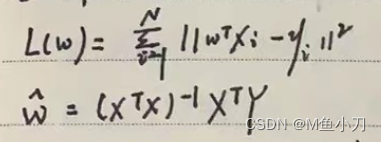
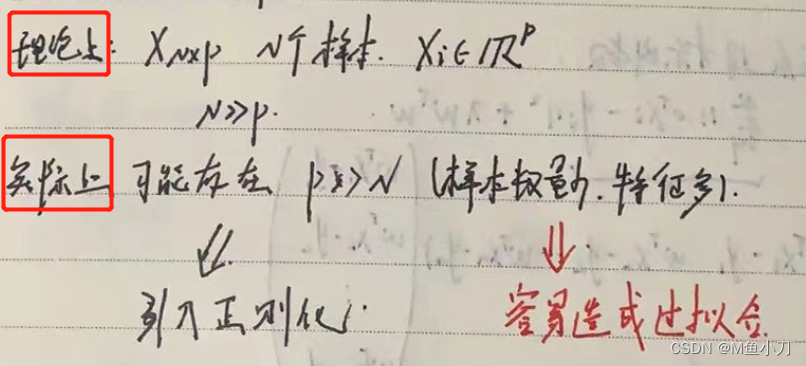
过拟合的解决方法:
①最直接:加数据
②降维(特征选择/特征提取(PCA))
③正则化(对参数空间,例如w的约束)
正则化的框架:
(L(w):Loss Function λ:惩罚系数 P(w):penalty(惩罚项))
即优化的目标为:
若为正则化:Lasso回归 P(w) =
若为正则化:岭回归 P(w) =
=
(备注正则化又叫权重衰减)
优化目标函数:
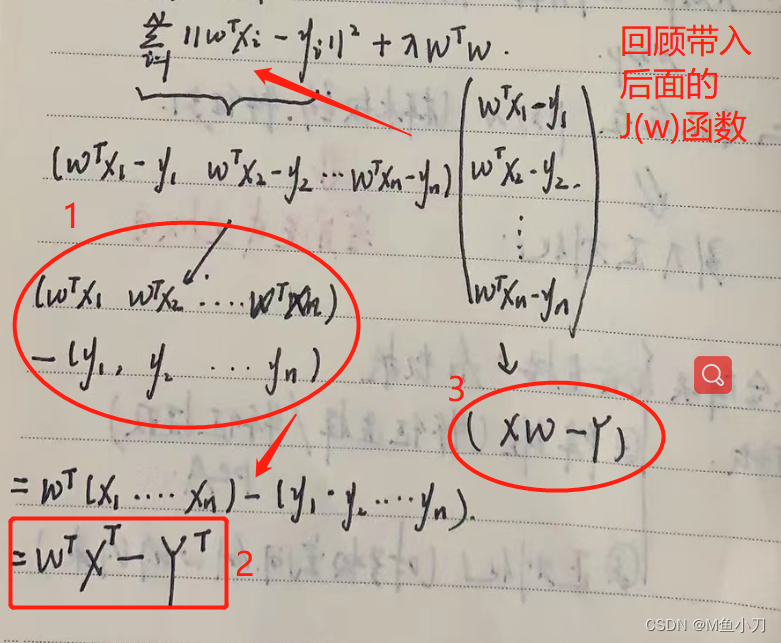
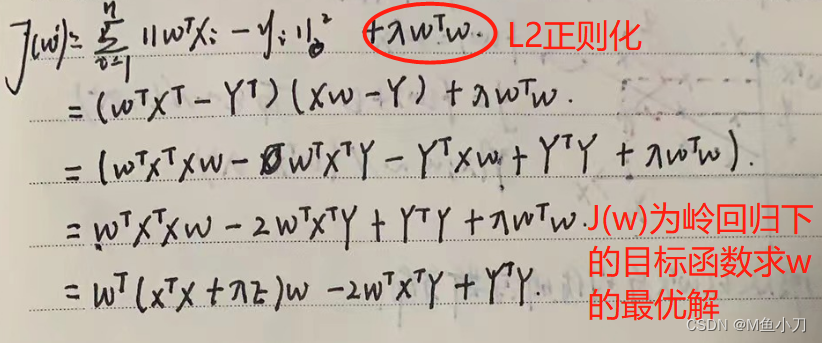
接下来就对J(w)求极值计算w的最优值:
目标:
过程:
(岭回归下得到的解析解)
二、正则化-岭回归-贝叶斯角度
回顾:
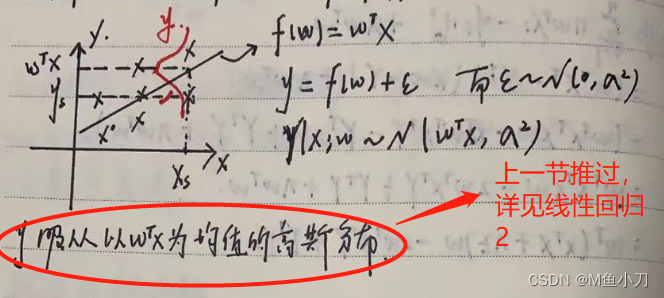
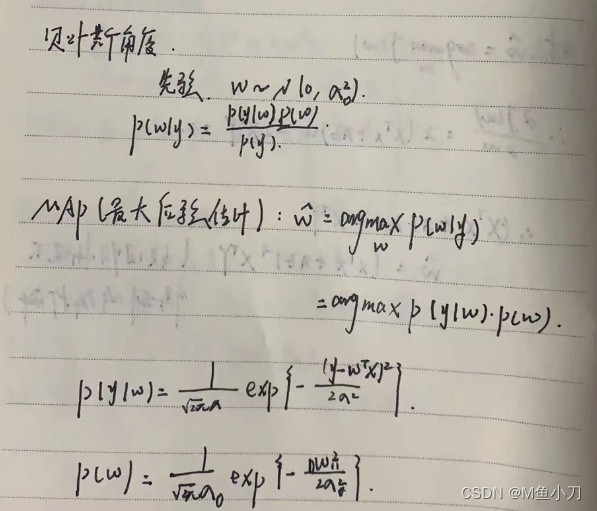
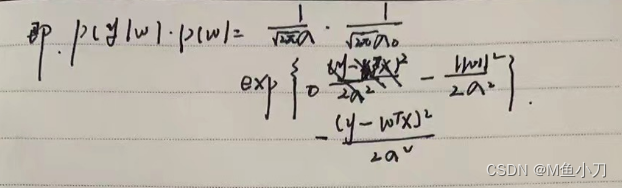
目标:
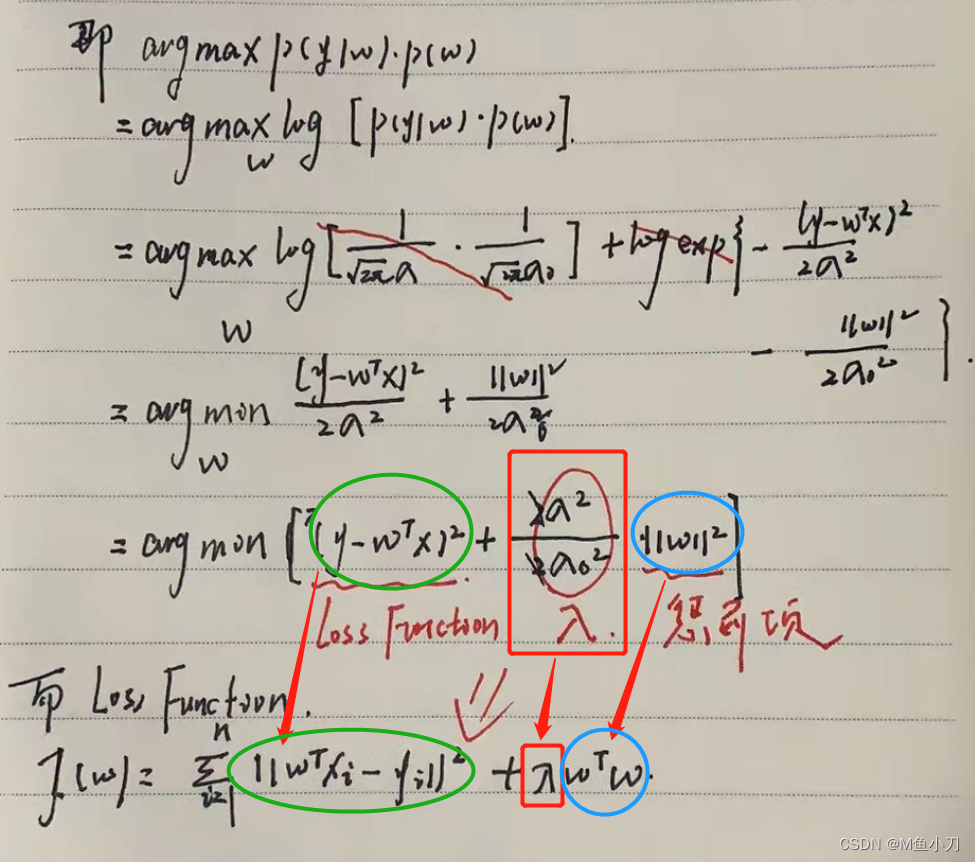
结论:
①无正则化:最小二乘法(LSE) 等价于 最大似然估计(MLE)-(noise服从高斯分布)
②正则化:Regularized LSE 等价于 最大后验估计(MAP)-(noise服从高斯分布)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)