基于sklearn进行蝴蝶花分类案例(Python机器学习笔记)
·
本文背景
原有在网易云课堂学习课程Python机器学习简介,只不过好久没看。现想回顾一下,巩固所学内容。
数据集简介
Iris数据集是常用的分类实验数据集,由Fisher, 1936收集整理。Iris也称鸢尾花卉数据集,是一类多重变量分析的数据集。数据集包含150个数据样本,分为3类,每类50个数据,每个数据包含4个属性。可通过花萼长度,花萼宽度,花瓣长度,花瓣宽度4个属性预测鸢尾花卉属于(Setosa,Versicolour,Virginica)三个种类中的哪一类。
iris以鸢尾花的特征作为数据来源,常用在分类操作中。该数据集由3种不同类型的鸢尾花的各50个样本数据构成。其中的一个种类与另外两个种类是线性可分离的,后两个种类是非线性可分离的。
该数据集包含了4个属性:
Sepal.Length(花萼长度),单位是cm;
Sepal.Width(花萼宽度),单位是cm;
Petal.Length(花瓣长度),单位是cm;
Petal.Width(花瓣宽度),单位是cm;
种类:
Iris Setosa(山鸢尾)、Iris Versicolour(杂色鸢尾),以及Iris Virginica(维吉尼亚鸢尾)。
数据检查
忽略报错
import warnings
warnings.filterwarnings("ignore",category=DeprecationWarning)
warnings.filterwarnings("ignore",category=RuntimeWarning)
数据导入
import pandas as pd
iris_data=pd.read_csv('iris.csv')
iris_data.head()
| sepal_length | sepal_width | petal_length | petal_width | species | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | setosa |
#判断是否缺失数据
iris_data.isnull().values.any()
True
#统计缺失数据的行数
iris_data.isnull().sum()
sepal_length    0
sepal_width     0
petal_length    0
petal_width     6
species         0
dtype: int64
对数据文件的大体描述
iris_data.describe()
| sepal_length | sepal_width | petal_length | petal_width | |
|---|---|---|---|---|
| count | 150.000000 | 150.000000 | 150.000000 | 144.000000 |
| mean | 5.843333 | 3.054000 | 3.758667 | 1.240278 |
| std | 0.828066 | 0.433594 | 1.764420 | 0.750414 |
| min | 4.300000 | 2.000000 | 1.000000 | 0.100000 |
| 25% | 5.100000 | 2.800000 | 1.600000 | 0.400000 |
| 50% | 5.800000 | 3.000000 | 4.350000 | 1.350000 |
| 75% | 6.400000 | 3.300000 | 5.100000 | 1.800000 |
| max | 7.900000 | 4.400000 | 6.900000 | 2.500000 |
数据可视化实现
%matplotlib inline
import matplotlib.pyplot as plt
import seaborn as sb

sb.pairplot(iris_data.dropna(),hue="species")
<seaborn.axisgrid.PairGrid at 0x21cbc043388>
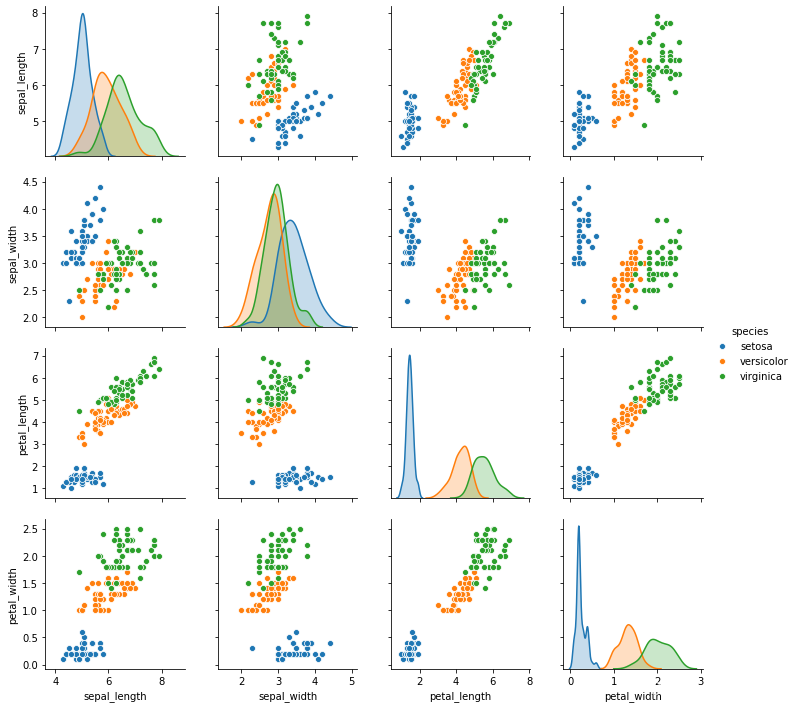
数据整理
显示蝴蝶花类别
iris_data['species'].unique()
array(['setosa', 'versicolor', 'virginica'], dtype=object)
sepal_width的数值分布
iris_data.loc[iris_data['species']=='setosa','sepal_width'].describe()
count    50.000000
mean      3.418000
std       0.381024
min       2.300000
25%       3.125000
50%       3.400000
75%       3.675000
max       4.400000
Name: sepal_width, dtype: float64
过滤孤立点
iris_data=iris_data.loc[(iris_data['species']!='setosa')|(iris_data['sepal_width']>=2.5)]
iris_data.loc[(iris_data['species']=='setosa','sepal_width')].hist()
<matplotlib.axes._subplots.AxesSubplot at 0x21cbd341548>
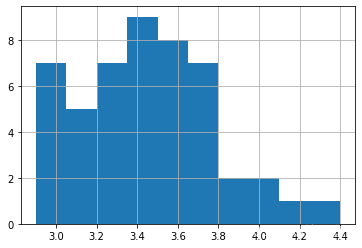
过滤缺失数据
iris_data.loc[(iris_data['sepal_length'].isnull())|
              (iris_data['sepal_width'].isnull())|
              (iris_data['petal_length'].isnull())|
              (iris_data['petal_width'].isnull())]
| sepal_length | sepal_width | petal_length | petal_width | species | |
|---|---|---|---|---|---|
| 6 | 4.6 | 3.4 | 1.4 | NaN | setosa |
| 7 | 5.0 | 3.4 | 1.5 | NaN | setosa |
| 8 | 4.4 | 2.9 | 1.4 | NaN | setosa |
| 9 | 4.9 | 3.1 | 1.5 | NaN | setosa |
| 10 | 5.4 | 3.7 | 1.5 | NaN | setosa |
| 11 | 4.8 | 3.4 | 1.6 | NaN | setosa |
计算平均值
average_petal_width=iris_data.loc[iris_data['species']=='setosa','petal_width'].mean()
将平均值赋予空值
iris_data.loc[(iris_data['species']=='setosa' )&
              (iris_data['petal_width'].isnull()),'petal_width']=average_petal_width

iris_data.loc[(iris_data['species']=='setosa' )&
              (iris_data['petal_width']==average_petal_width)]
| sepal_length | sepal_width | petal_length | petal_width | species | |
|---|---|---|---|---|---|
| 6 | 4.6 | 3.4 | 1.4 | 0.248837 | setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.248837 | setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.248837 | setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.248837 | setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.248837 | setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.248837 | setosa |
判断空值是否存在
iris_data.loc[(iris_data['sepal_length'].isnull())|
              (iris_data['sepal_width'].isnull())|
              (iris_data['petal_length'].isnull())|
              (iris_data['petal_width'].isnull())]
| sepal_length | sepal_width | petal_length | petal_width | species |
|---|

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)