深度学习在计算机视觉领域(图像,视频,3-D点云,深度图)的应用一览 语义分割/CNN/RNN
接上篇
核心部分是计算机视觉的高层:环境理解。
这部分是深度学习在计算机视觉最先触及,并展示强大实力的部分。出色的工作太多,是大家关注和追捧的,而且有不少分析和总结文章,所以这里不会重复过多,只简单回顾一下。
我整理了一份关于pytorch、python基础,图像处理opencv\自然语言处理、机器学习、数学基础等资源库,想学习人工智能或者转行到高薪资行业的,大学生都非常实用,无任何套路免费提供,,加我裙:361598961
也可以领取的内部资源,人工智能题库,大厂面试题 学习大纲 自学课程大纲还有200G人工智能资料大礼包免费送哦~
人工智能精品课程资料扫码加微领取
1 语义分割/实例分割(Semantic/Instance Segmentation);
语义分割最早成功应用CNN的模型应该是FCN(Fully Convolution Network),由Berkeley分校的研究人员提出。它是一种pixel2pixel的学习方法,之后各种演变模型,现在都可以把它们归类于Encoder-Decoder Network。
深度学习在计算机视觉领域(图像,视频,3-D点云,深度图)的应用一览 计算机视觉图像处理
这里是去年CVPR的一片论文在总结自动驾驶的实时语义分割算法时给出的框图:
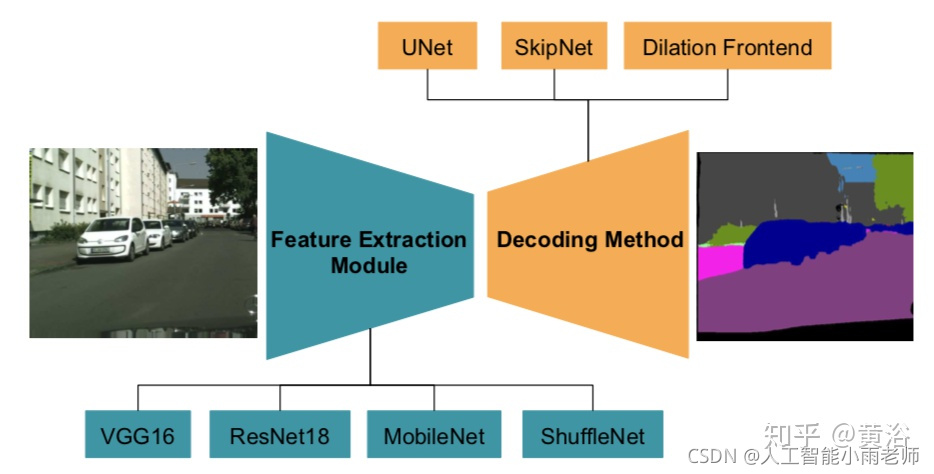
其中Encoder部分特别采用了MobileNet和ShuffleNet。
实例分割是特殊的语义分割,结合了目标检测,可以说是带有明确轮廓的目标检测,其代表作就是Mask R-CNN,应该是何凯明去FB之后的第一个杰作。
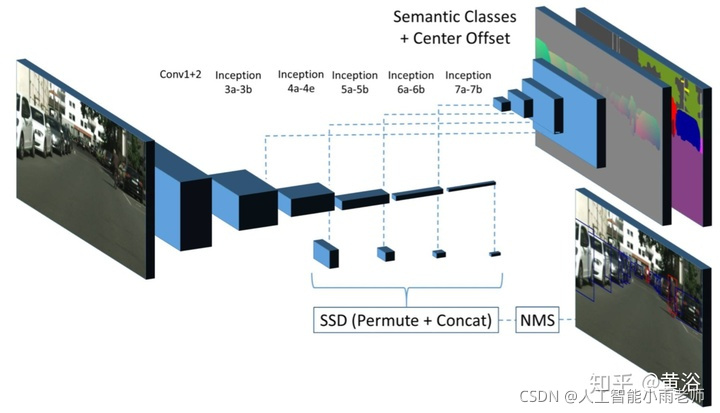
这是一个借鉴目标检测算法SSD的实例分割模型:
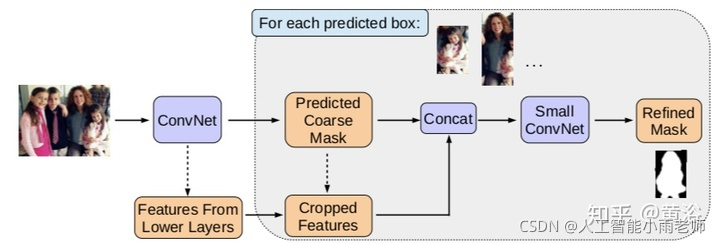
而下面这个是从目标检测算法Faster-RCNN演变的实例分割模型MaskLab,论文发表在去年CVPR‘18:
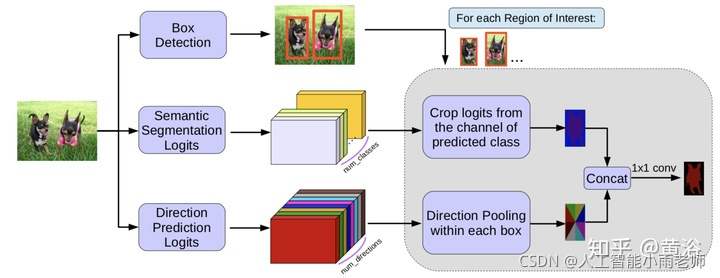
这是它修正Mask的方法示意图:
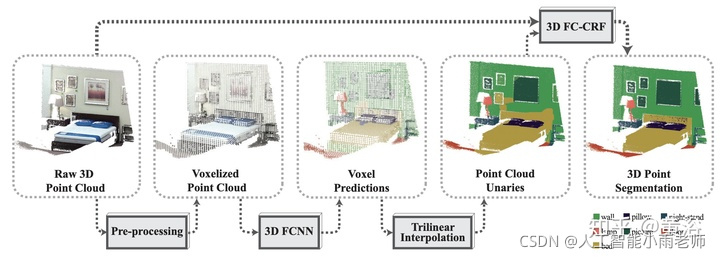
这是一个基于3-D点云的语义分割NN模型:
2 检测/识别(特别例子:人脸);
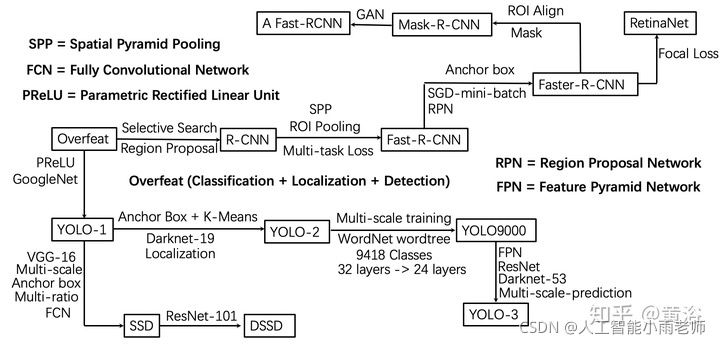
目标检测的开拓性工作应该是Berkeley分校Malik组出来的,即两步法的R-CNN(Region-based CNN),借用了传统方法中的Region Proposal。之后不断改进的有fast RCNN和faster RCNN,每次都有新点子,真是“群星闪耀”的感觉。
一步法的工作,有名的就是SSD(Single Shot Detection)和YOLO(You Only Look Once),期间何凯明针对one-stage和two-stage方法的各自优缺点引进一个Focal Loss,构建的新方法叫RetinaNet,而后来YOLO3基本也解决了精度低的弱点。
这里我画了一个算法发展草图(其实还有一些方法没有包括在里面,比如densebox,deepbox,R-FCN,FPN等等)。
ImageNet本身就是一个1000多种物体识别比赛,一般公布的是top 5的结果(可见最早精度有多低(:)。CNN在ImageNet的发展史,就是它在图像识别的一段近5年的历史了:)。
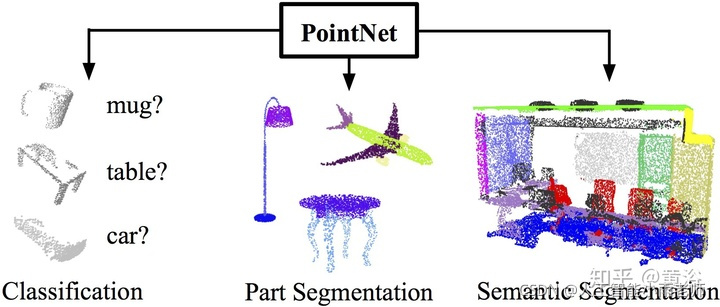
激光雷达点云数据的处理,无论识别还是分割,有PointNet以及改进的CNN模型:
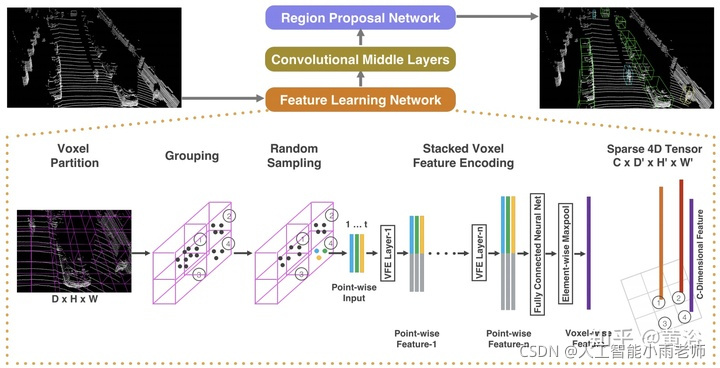
基于点云做目标识别的例子有Apple公司研究人员发表的VoxelNet模型:
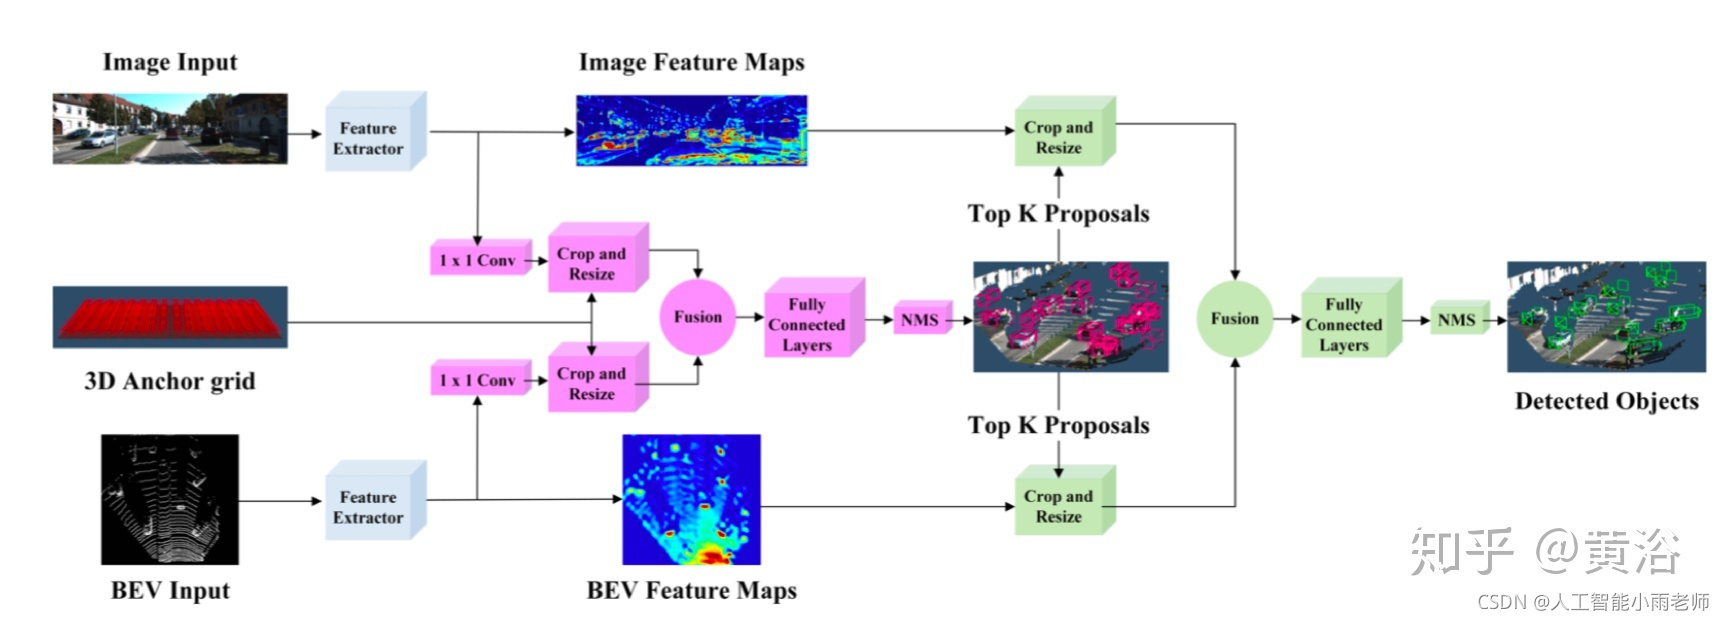
将点云和RGB图像结合的目标检测CNN模型例子如下:
这里顺便提一下人脸识别,因为是对人脸的个体属性判别,所以这个课题应该算fine grained recognition。就好像对狗或者马这种动物继续判别它的品种,都是细分的。
请注意,人脸识别分人脸验证(face verification)和人脸确认(face identification);前者是指两个人是不是同一个人,1-to-1 mapping,而后者是确定一个人是一群人中的某个,1-to-many ampping。以前经常有报道机器的人脸识别比人强了,都是指前者,假如后者的话,那谁能像机器一样识别上万人的人脸数据库呢?何况中国公安部的数据高达亿的数量级。
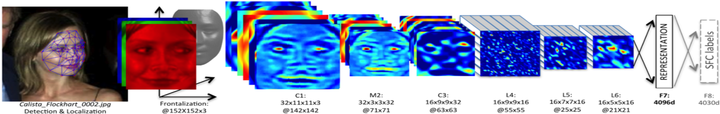
一个完整的人脸识别系统,需要完成人脸检测和人脸校准(face alignment),而后者是需要人脸关键点(facial landmarks)的检测,也是可以基于CNN模型来做。这里以FB的DeepFace模型为例吧,给出一个人脸识别的系统框图:
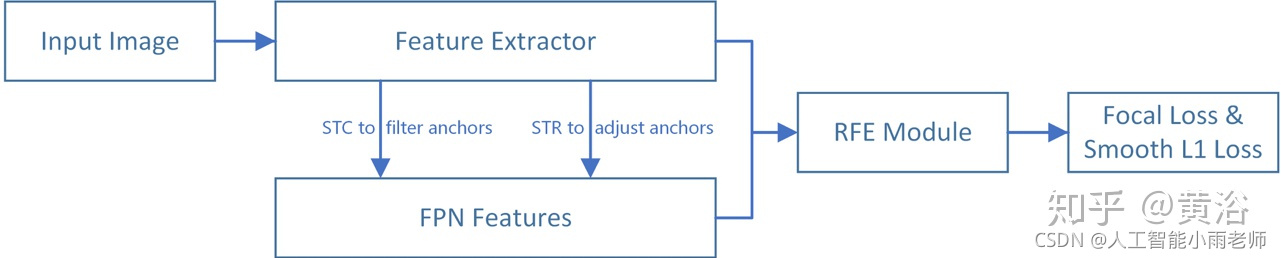
这是不久前刚刚提出的人脸检测模型: Selective Refinement Network
而这里给出一个基于facial landmarks做校准的模型:
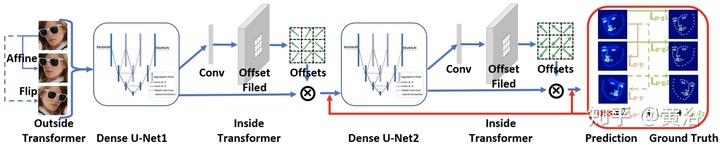
顺便提一下旷世科技的Pyramid CNN模型和商汤科技的DeepID2模型(一共发布过4个DeepID版本)依次如图:
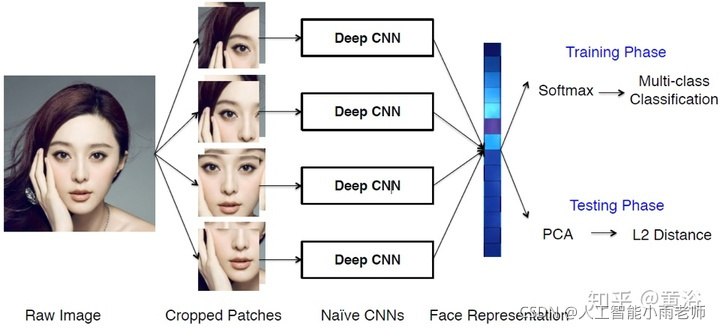
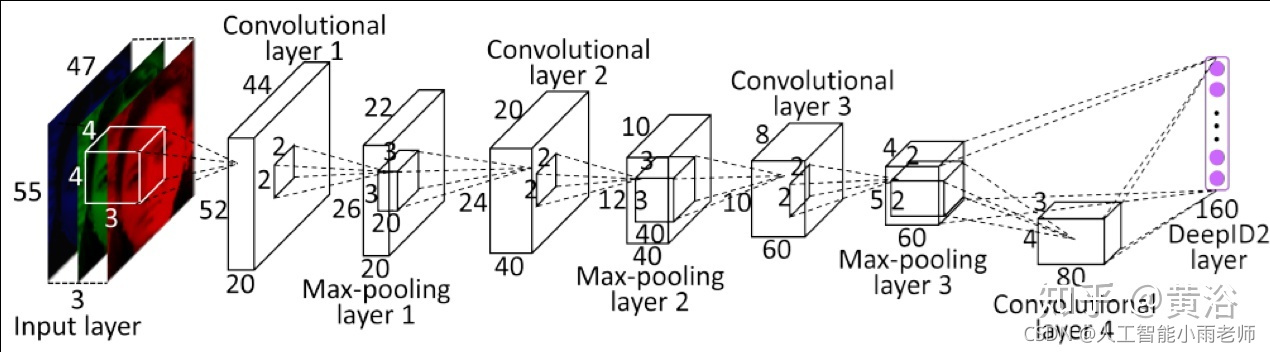
3 跟踪(特别例子:人体姿态/骨架);
目标跟踪是一个递推估计问题,根据以前的图像帧目标的信息推算当前目标的位置甚至大小/姿态。有一阵子,跟踪和检测变得浑为一体,即所谓tracking by detection,跟踪也可以看出一个目标分割(前后景而言)/识别问题。
跟踪是短时(short term)邻域的检测,而一般的检测是长时(long term)大范围的检测。跟踪的困难在于目标的遮挡(分部分还是全部),背景复杂(相似目标存在),快速(fast)以及突变(agile)运动等等。比如,跟踪人脸,当转90度成侧脸时就会有以上这些问题。
跟踪方法有一个需要区分的点,多目标(MOT)还是单目标(SOT)跟踪器。单目标不会考虑目标之间的干扰和耦合,而多目标跟踪会考虑目标的出现,消失以及相互交互和制约,保证跟踪各个目标的唯一性是算法设计的前提。
跟踪目标是多样的,一般是考虑刚体还是柔体,是考虑单刚体还是铰接式(articulated),比如人体或者手指运动,需要确定skeleton模型。跟踪可以是基于图像的,或者激光雷达点云的,前者还要考虑目标在图像中大小的变化,姿态的变化,难度更大。
基于以上特点,跟踪可以用CNN或者RNN模型求解,跟踪目标的描述本身就是NN模型的优势,检测也罢,分割或者识别也罢,都不是问题。运动特性的描述也可以借鉴RNN模型,不过目前看到的结果这部分不比传统方法好多少。
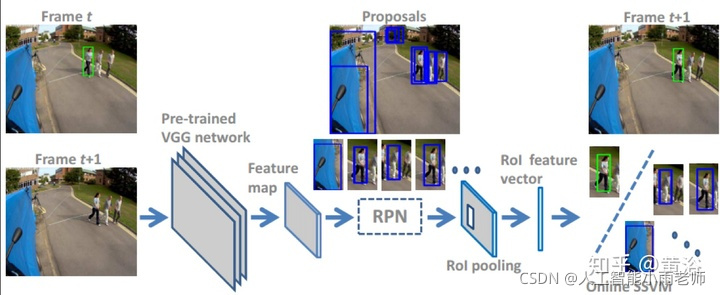
先看一个单目标跟踪的CNN模型:
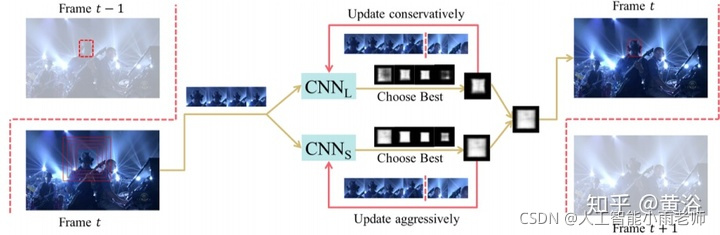
这个展示的模型是一个基于R-CNN检测模型扩展的单目标跟踪方法:
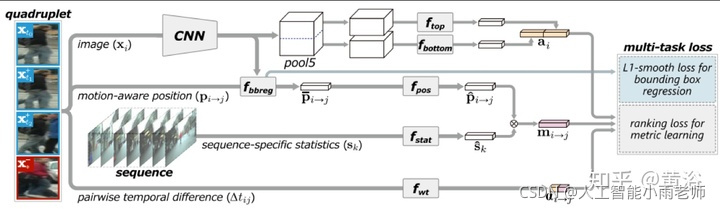
多目标跟踪模型有这么一个例子:
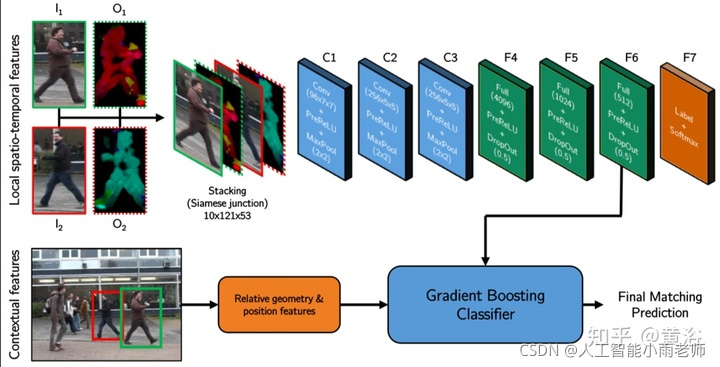
下面是一个基于RNN的多目标跟踪模型:
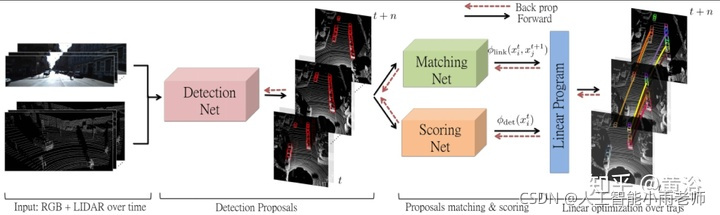
补充一个基于RGB图像和3-D点云的目标跟踪NN模型:
顺便谈一下人体姿态和骨架跟踪问题。以前传统方法在人体姿态估计花了很大力气但效果不好,提出了part-based目标模型,比如constellation model, pictorial structure, implicit shape model, deformable model等等。
最近CMU提出一个方法,基于Part Affinity Fields(PAF)来估计人体姿态和骨架,速度非常快。PAF是一个非参数描述模型,用来将图像像素和人体各肢体相关起来,看它的架构如图,采用的是two branch CNN结构,联合学习各肢体的相关性和位置。
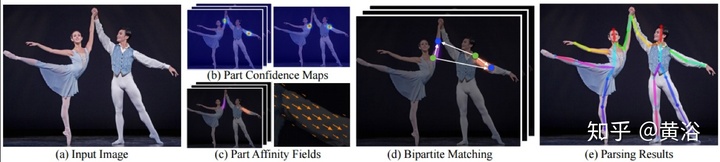
下面这个是其中双部图形匹配(Bipartie matching)算法的示意图。
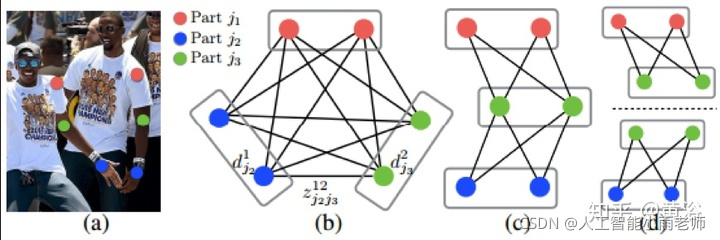
这种多目标快速姿态跟踪的实现对人体行为的理解是非常重要的工具。最后讲一下计算机视觉的推广领域。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)