百度飞桨 PaddlePaddle 深度学习打卡7日营 -DAY6 开源社区与模型部署
#########################
开源社区讲解
雨哥讲解
什么是开源社区?
就是指以开源的概念来运作的内容,如开源项目、开源产品等,特点是公开透明。
是一种互利共赢的合作形式
开源社区的好处?
- 协作 接受所有人的修改
- 采用和重组 人们可以利用开源项目创建其他东西
- 透明度 任何人都可以对于开源项目进行监督和检查,可以进行纠错,促进更好发展
开源软件指南-如何从零玩转开源?
开源社区玩法
建立项目-代码托管-
-
自己lead一个项目
构思;创建项目;组建团队;发展社区等 -
参与他人的项目
bug反馈;文档个贡献;代码贡献;PR Review等
代码托管的软件平台
常用的为 github 和 gitee ,都是git内核的共享平台,github好处是全球最大,通用,gitee的好处是汉化比较好,而且是国内的,网络问题较少。
创建项目的基本文件(四大必备要素)
1.许可证 :保证在其他人可以使用的同时,不会产生不良后果,也不会被盗用等产生恶性影响及后续纠纷 如:阿巴齐 apache license 2.0
2. README:是项目的介绍;项目如何快速使用,和一些关键及重要用法的信息和索引
3. 贡献指南: 告诉开发者如何参与到自己的项目中
4. 行为准则: 参与到自己的项目中的开发者需要遵守什么行为规范,(有现成的内容)
示例:paddlepaddle的github
https://github.com/PaddlePaddle/paddle
(前一个paddlepaddle相当于是组织名,后一个paddle 是项目名)
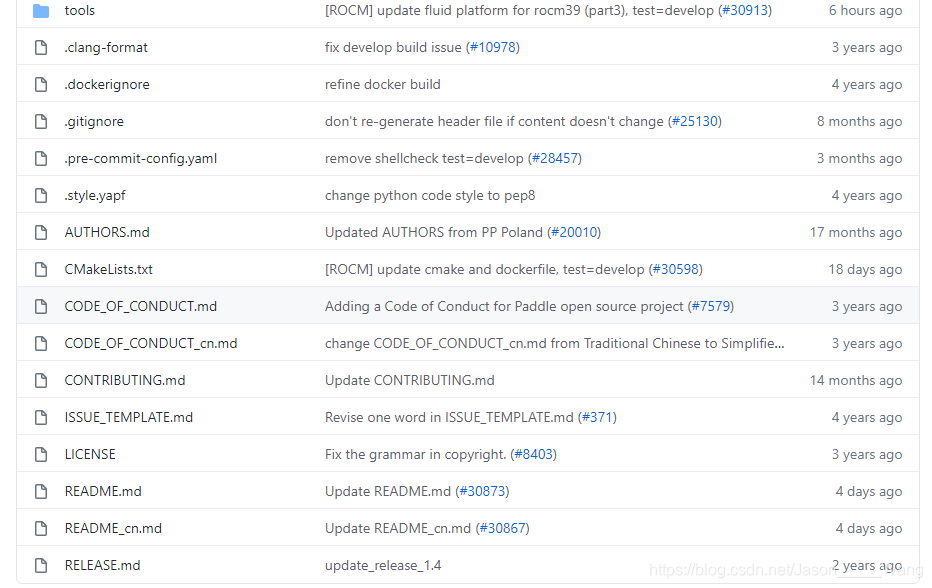
paddlepaddle 的基本要素文件
参与别人项目 开源贡献
步骤:
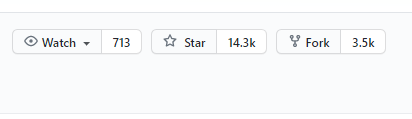
- srar :对感兴趣或者喜欢的代码仓库点击star,可以将该仓库收藏到个人页面
- issue: 提交issue,反馈问题或者需求,或参与issue讨论
- Pull request:Fork项目,新增自己的逻辑和改进,并且提交PR/Review PR/Merge PR
最终
4. 独立发展生态Repo: 以来原有Repo,创建自己的,并且增强 (相当于自己出来单干)
以github为例 讲解开源平台使用
-
注册
按照步骤来就行 问题不大 -
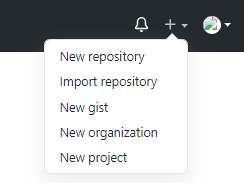
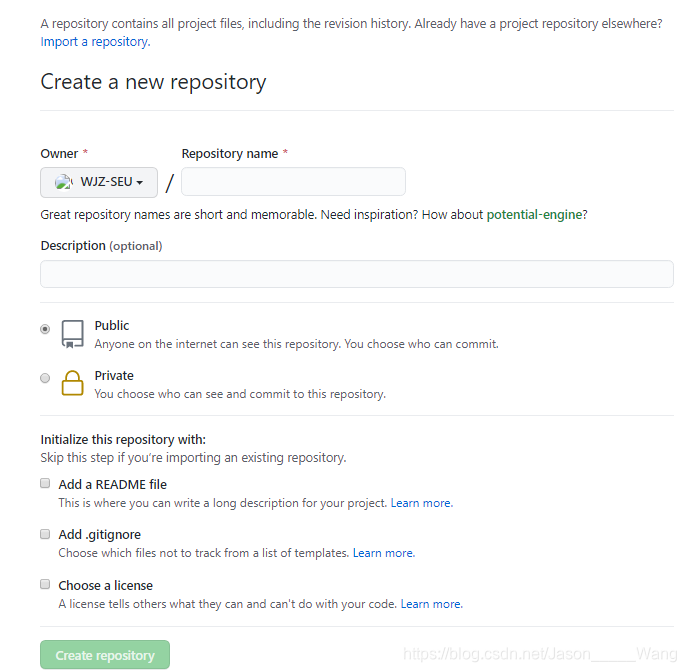
创建一个开源项目
右上角加号 New repo
填入内容&关键词以及信息
3.参与别人项目:
进入项目主页 查看别人的项目,并且点击三连

issue (开源贡献 最简单的途径)
可以在功能栏的ISSUEs中提交问题、意见和想法,并且进行交流,如paddlepaddle的:
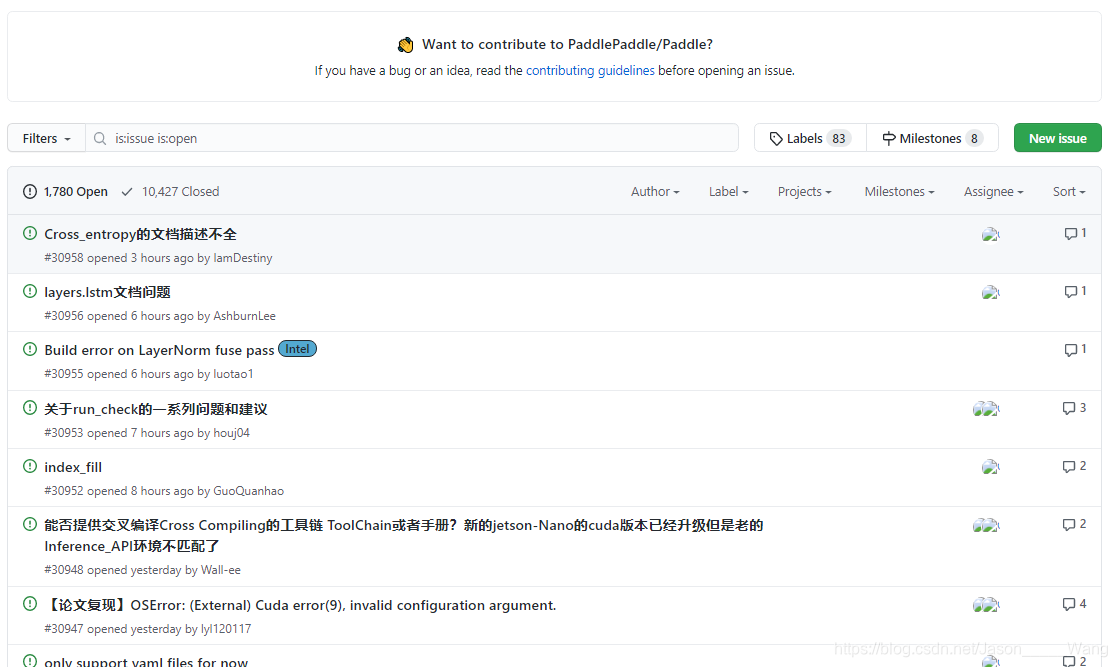
下载&提交&上传 pull requests
可以将自己进行修改过的版本进行提交,在与原有代码的比较后进行上传与评价,如果得到项目管理员的许可,会进行更换和优化迭代 或被补充为项目代码的一部分(merge操作)
paddlepaddle的项目体系
paddle:主框架的代码库
models:官方所做的模型复现 代码库
paddleOCR: OCR领域的领域特有库
paddle lite: 预测引擎
paddledetection:
community:社区代码库
…
等等等等
#########################################################################
部署环节讲解
灰酱 老师
于航 PPDE 飞桨产品运营
小度熊二分类部署实践
跟硬件有一些相关。
在实地过程中 可以通过硬件输入在部署端对小度熊或者扬子鳄进行识别
课程目标
- 万能公式回顾——深度学习开发关键流程
- 概念明确 ——什么是训练?模型?部署?
- 武功秘籍——了解飞桨轻量级推理部署框架——paddle lite
- 轻松实践——自己学会并开发炮筒一个部署深度学习任务
课程重点:
1.任务解读 理解什么是训练 模型 部署
2.了解部署方案
3.实践 在armlinux进行小度熊的部署
万能公式回顾
今天主要讲的是部署上线:第六步
深度学习的关键环节:数据、模型、训练、预测
在训练完成后,会生成一个模型文件(类似于一个黑箱文件)
训练:从现有数据中学习经验
模型:训练好的神经网络
在paddlepaddle中,模型结构与模型网络,被抽象为了两个文件存储,作为模型的保存方式
部署即为将所生成好的模型文件,导入终端设备,进行实际应用的准备
常见的部署场景
- 服务器端高性能部署 ——侧重延迟,吞吐,资源消耗
- 模型服务化部署——侧重线上模型管理,弹性服务等
- Mobile&loT小型移动设备部署(一般性能较低)——侧重性能,资源使用,部署体积,多硬件
- web端部署 ——浏览器部署场景
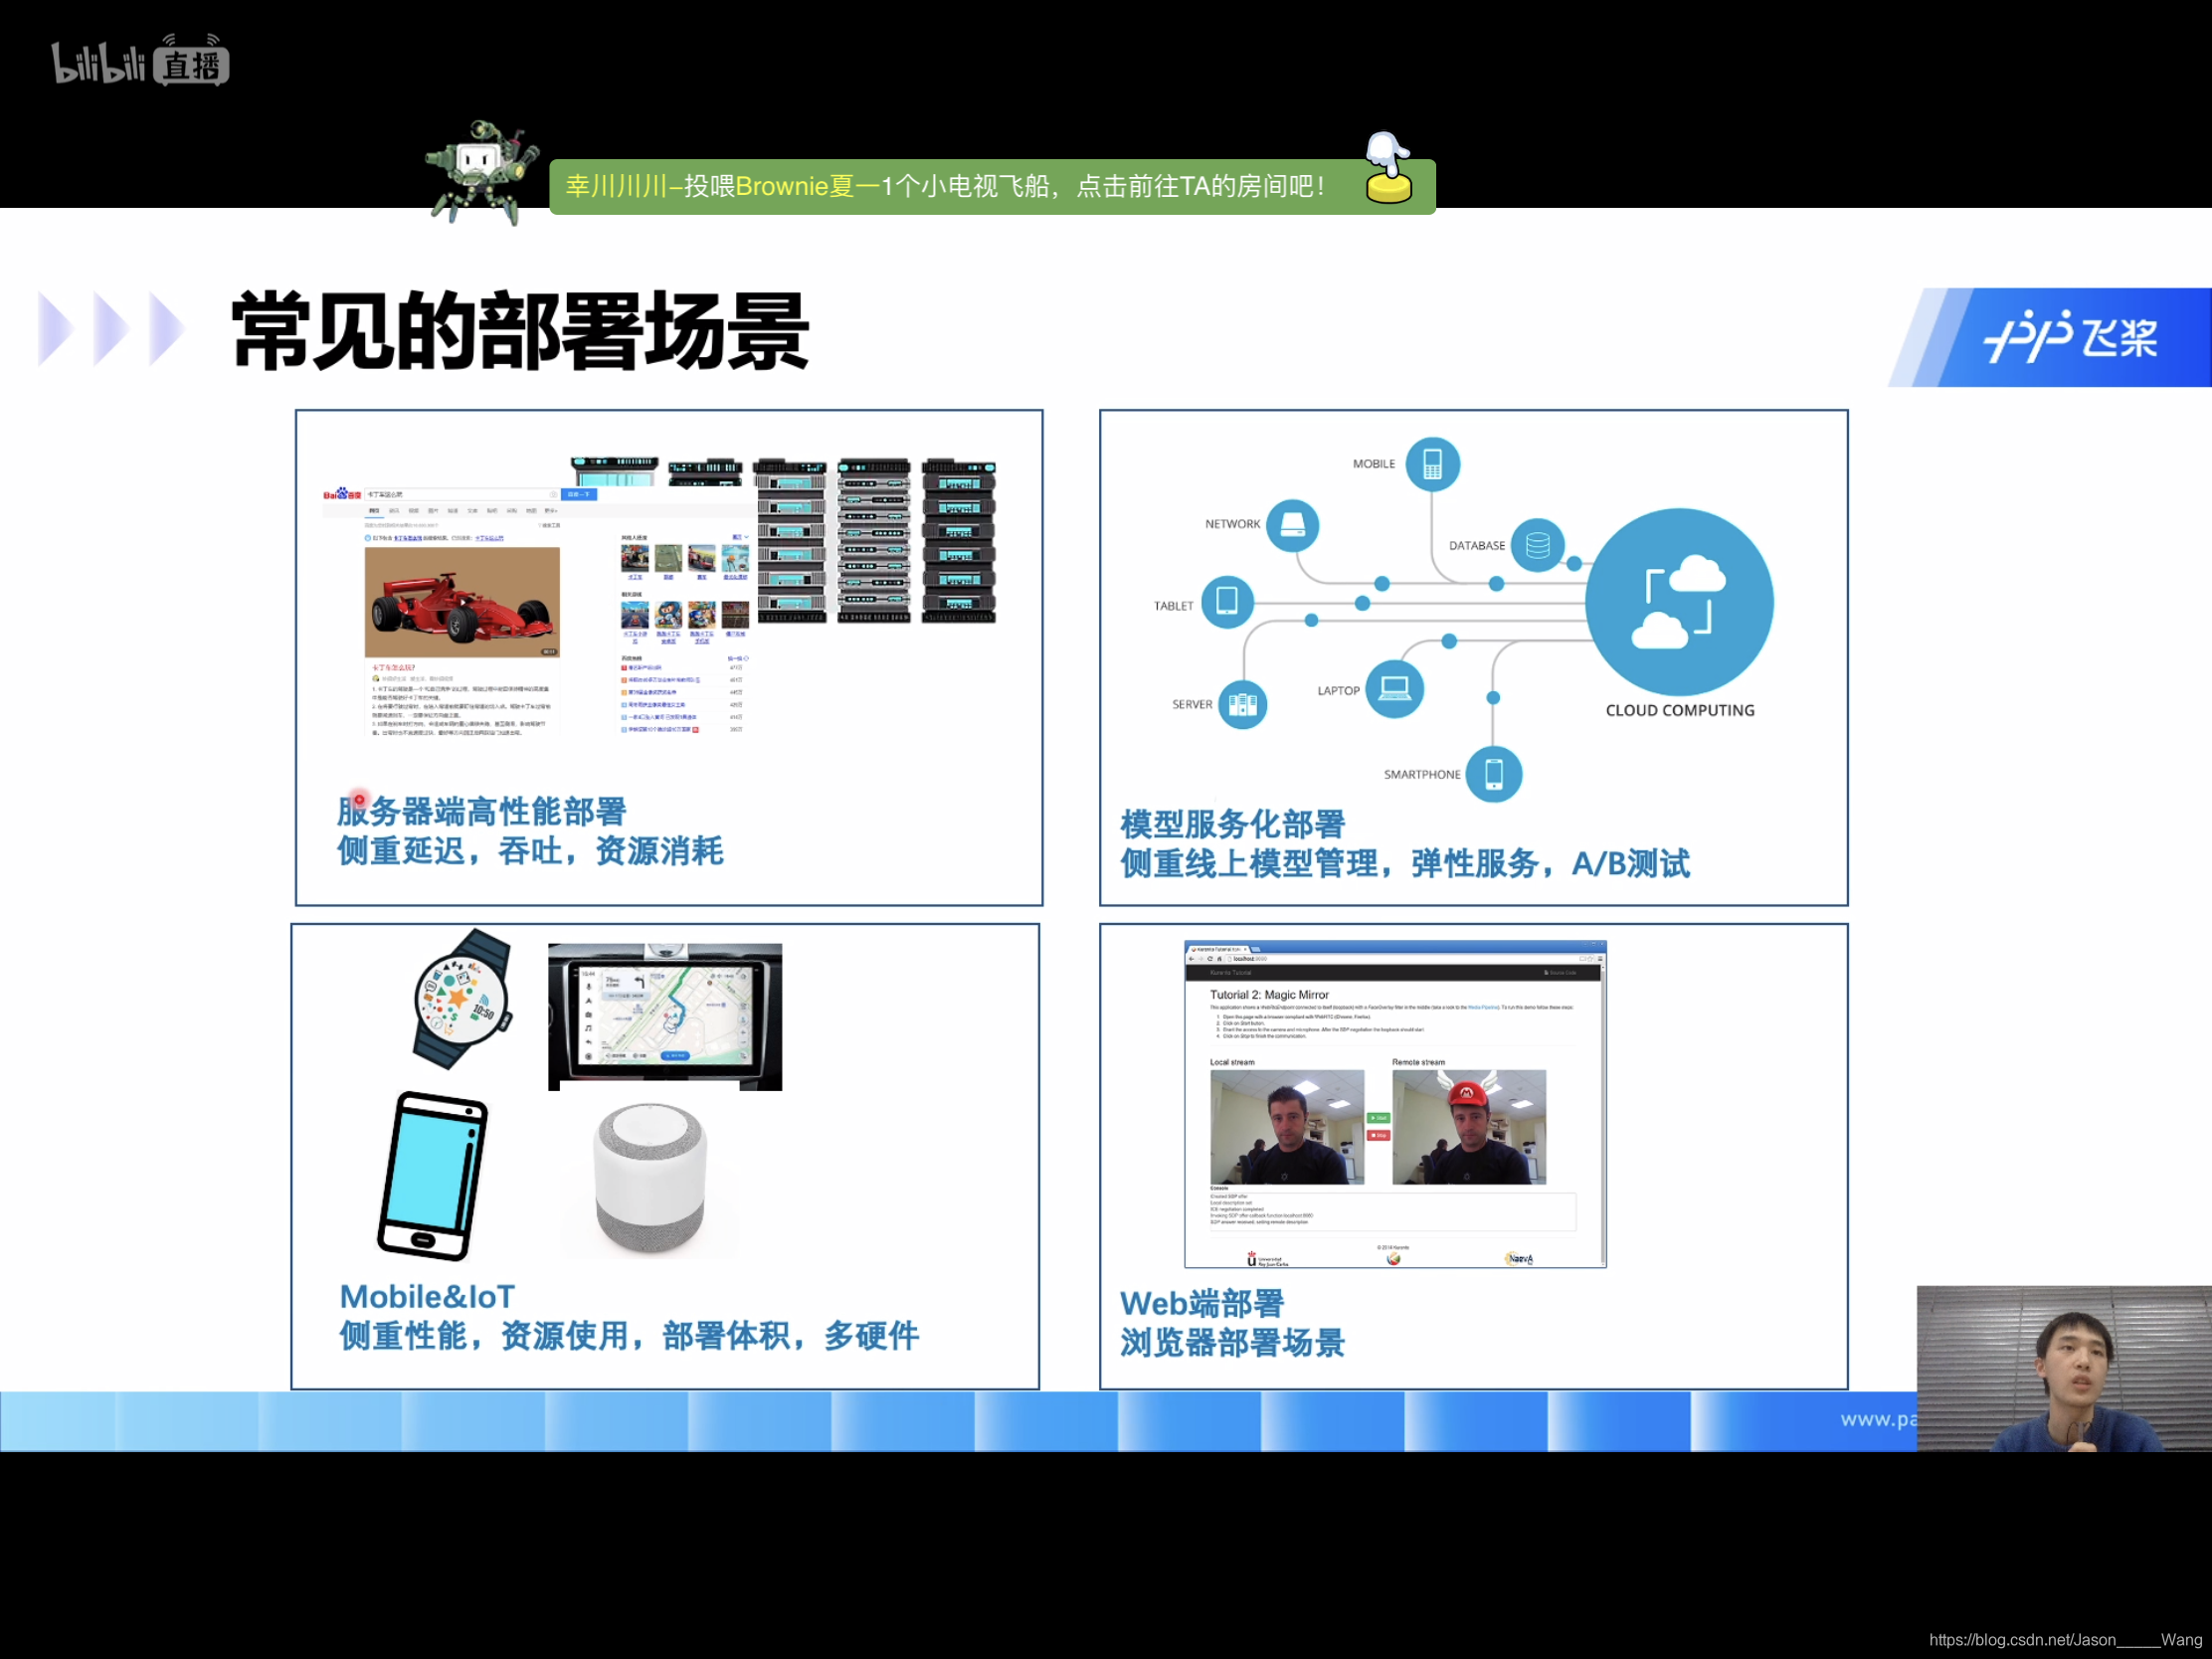
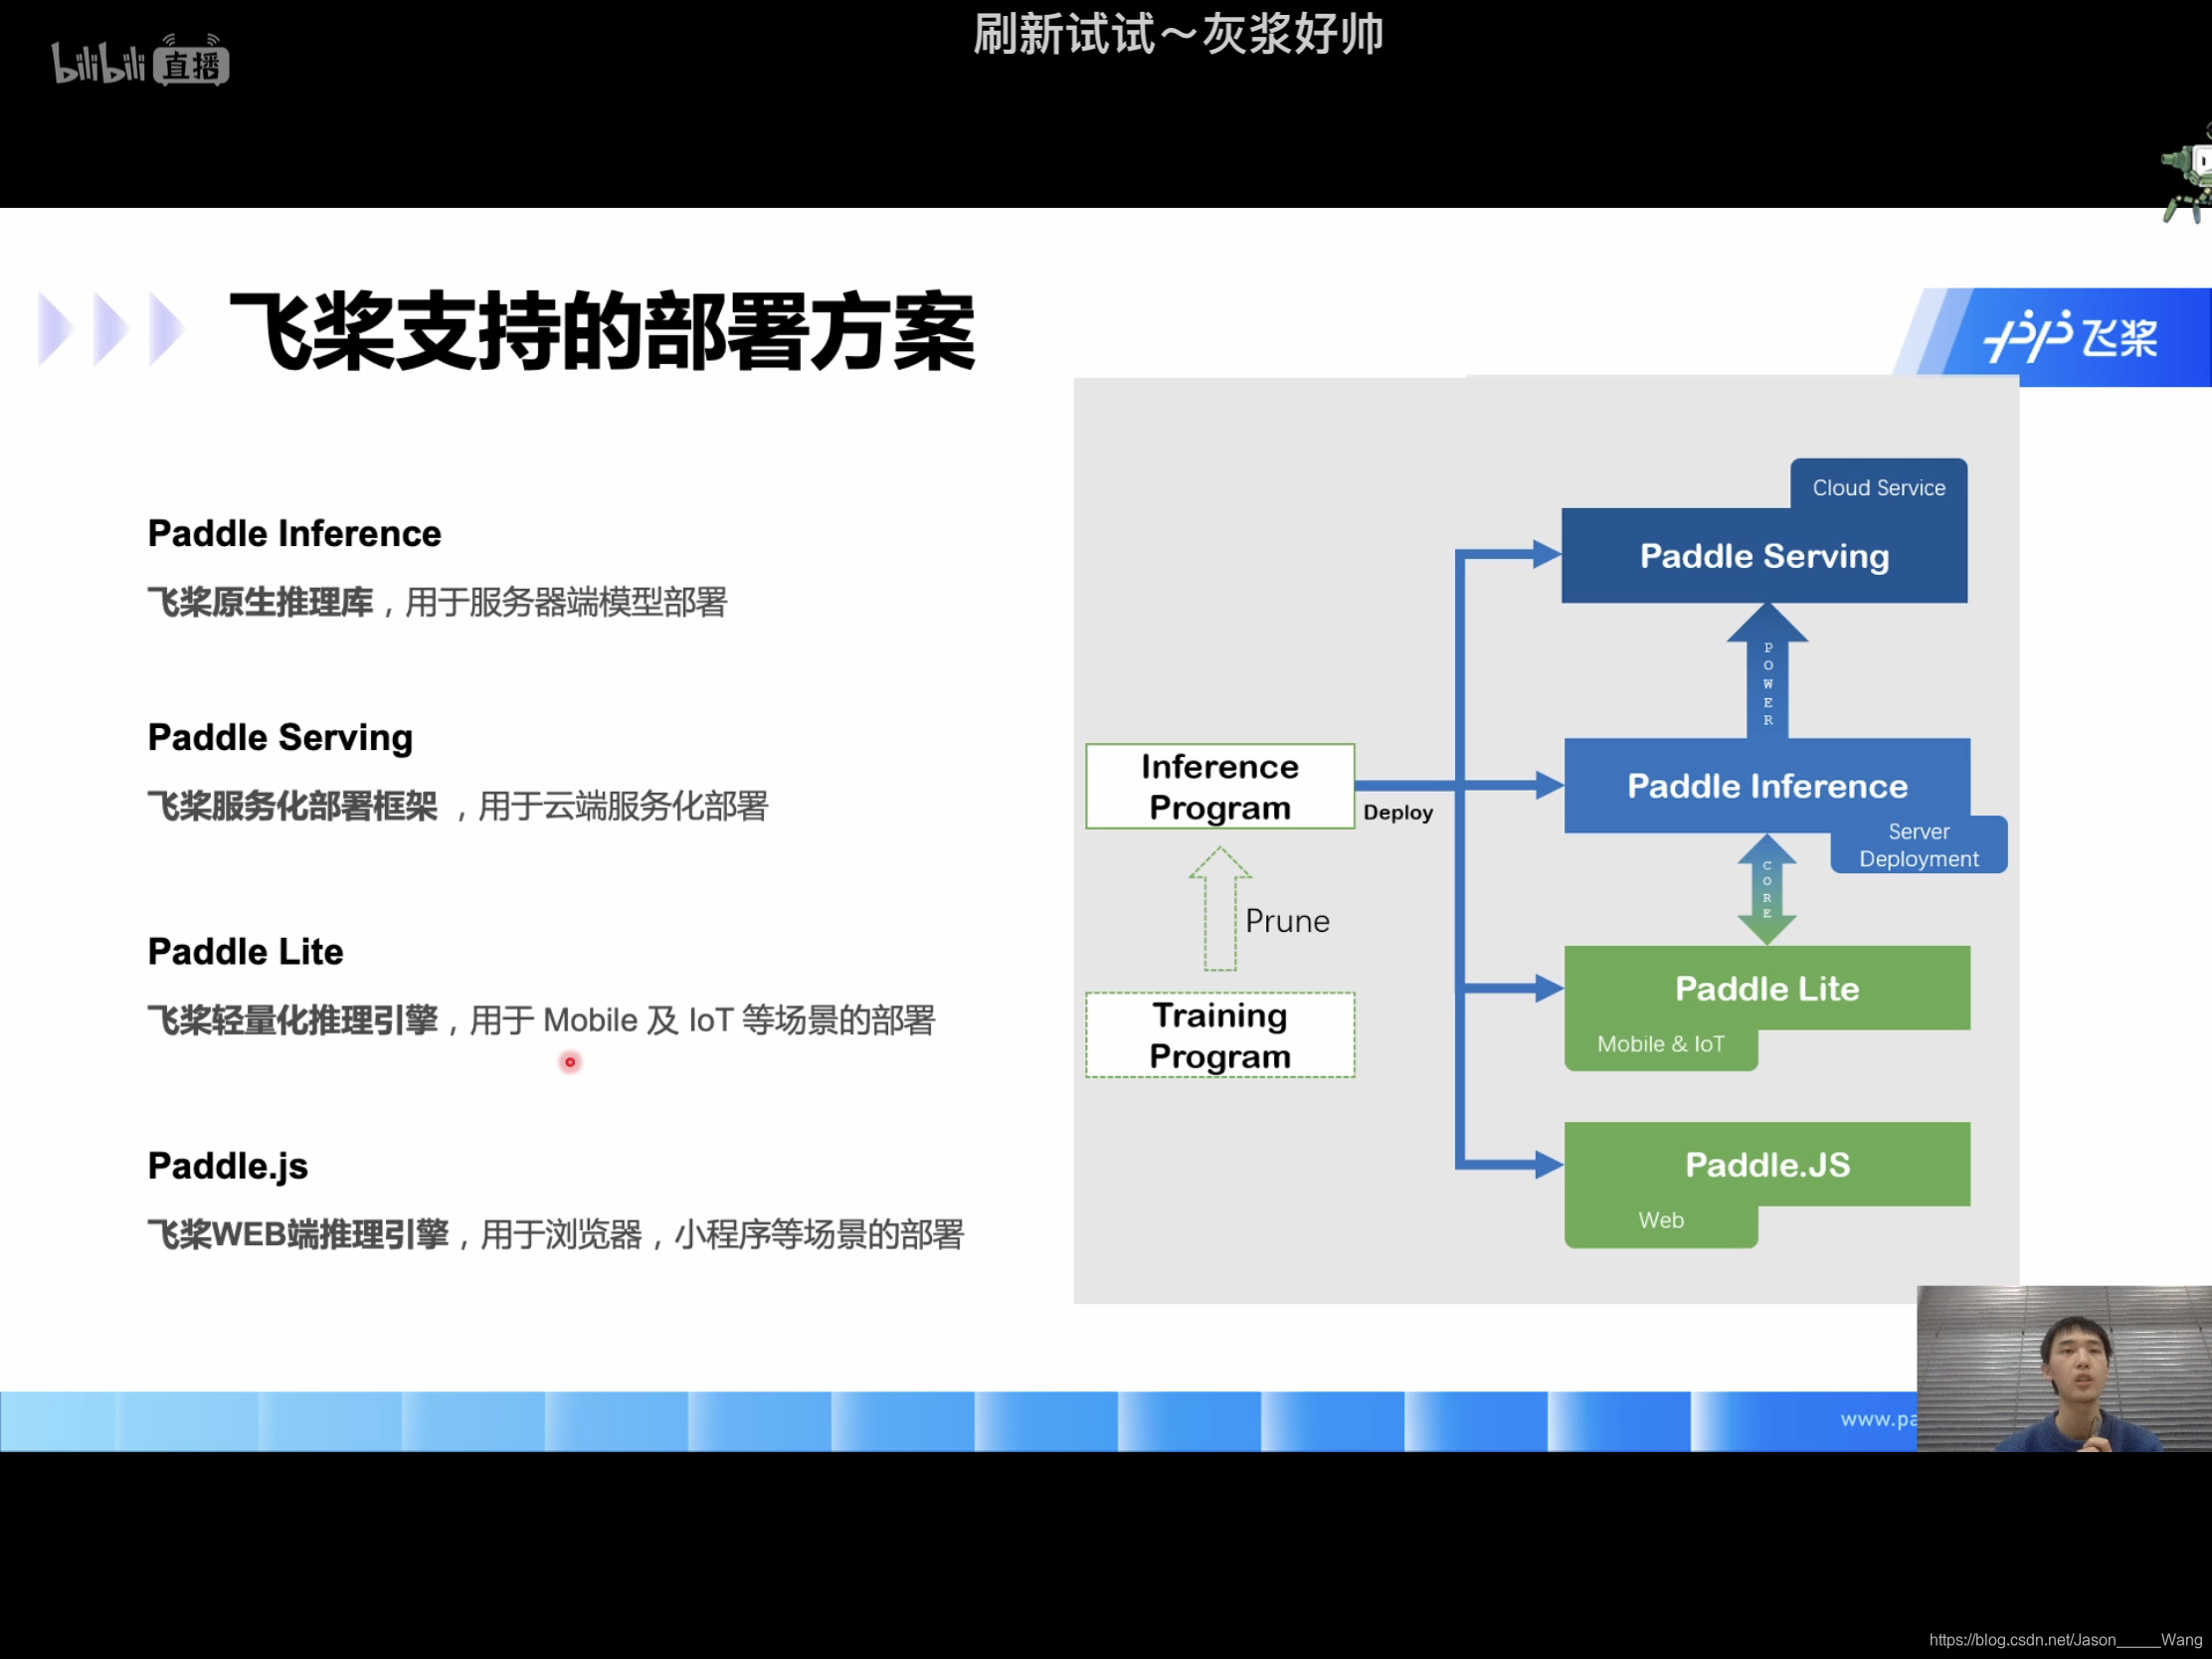
针对以上的部署场景,飞桨分别准备了相应的部署支持方案库
paddle inference
paddle serving
paddle lite 轻量级推理化引擎
paddle
从训练到部署
模型准备–》模型优化–》推理部署
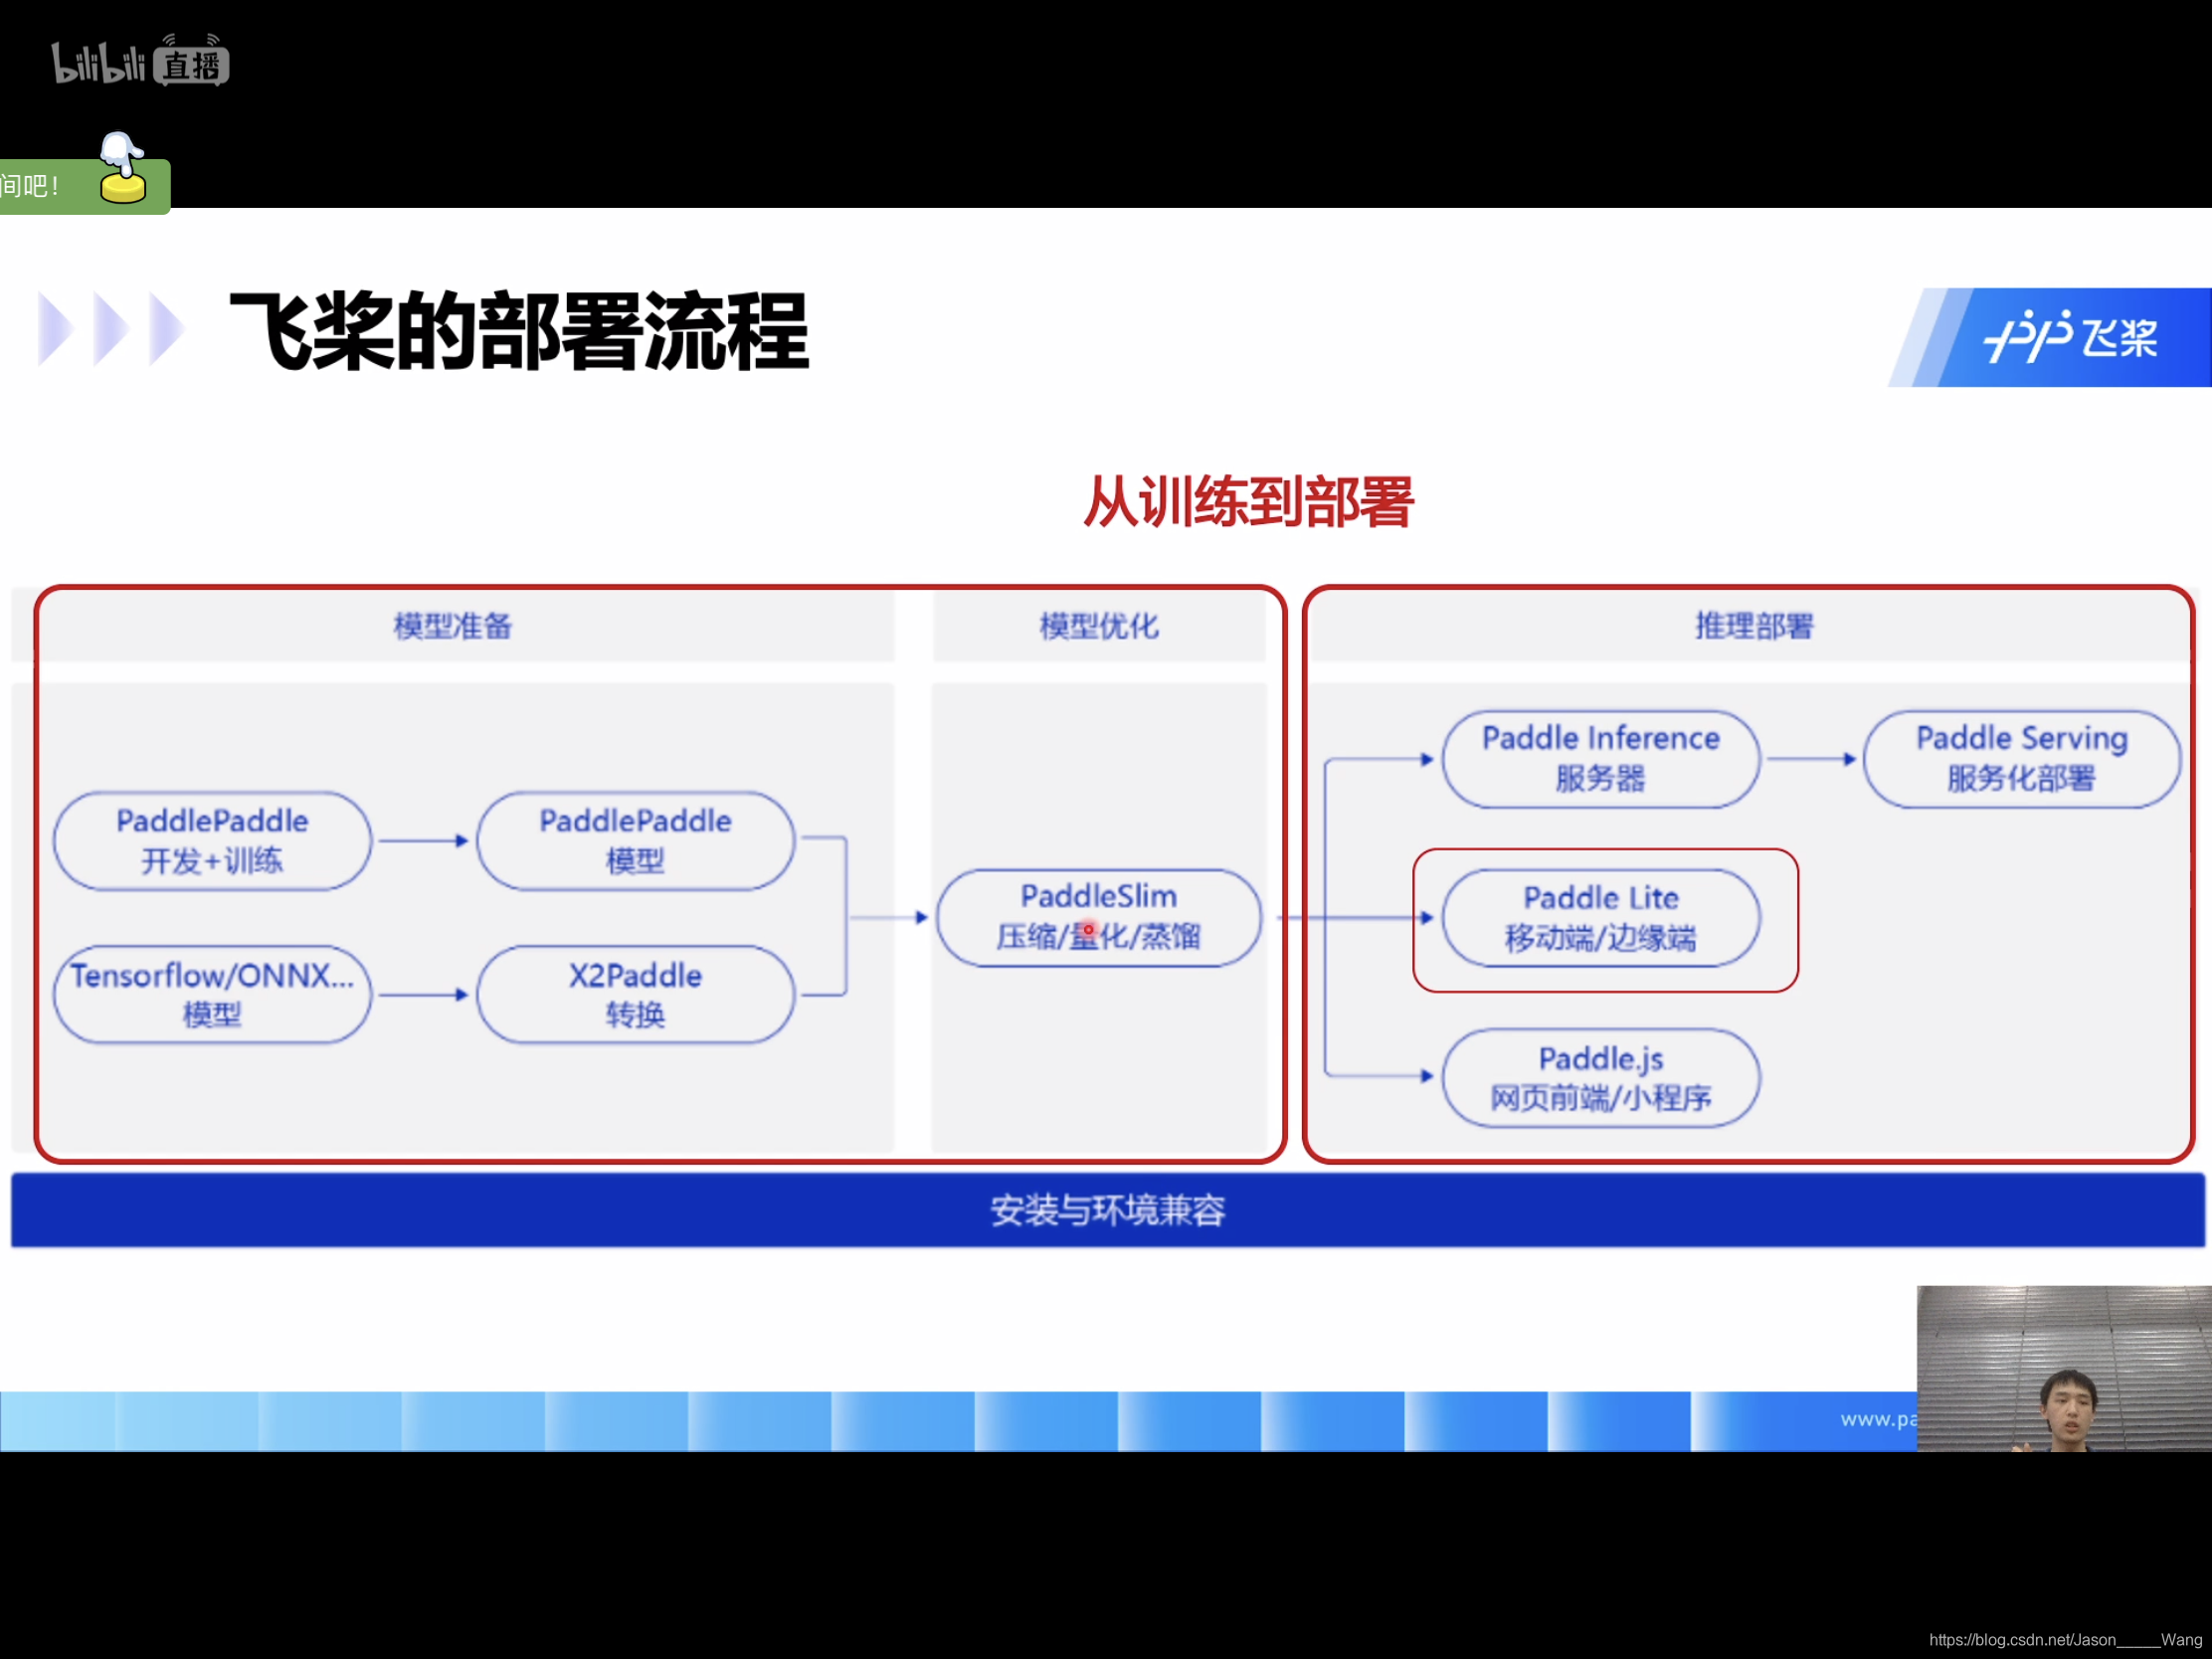
paddle lite 轻量化部署平台
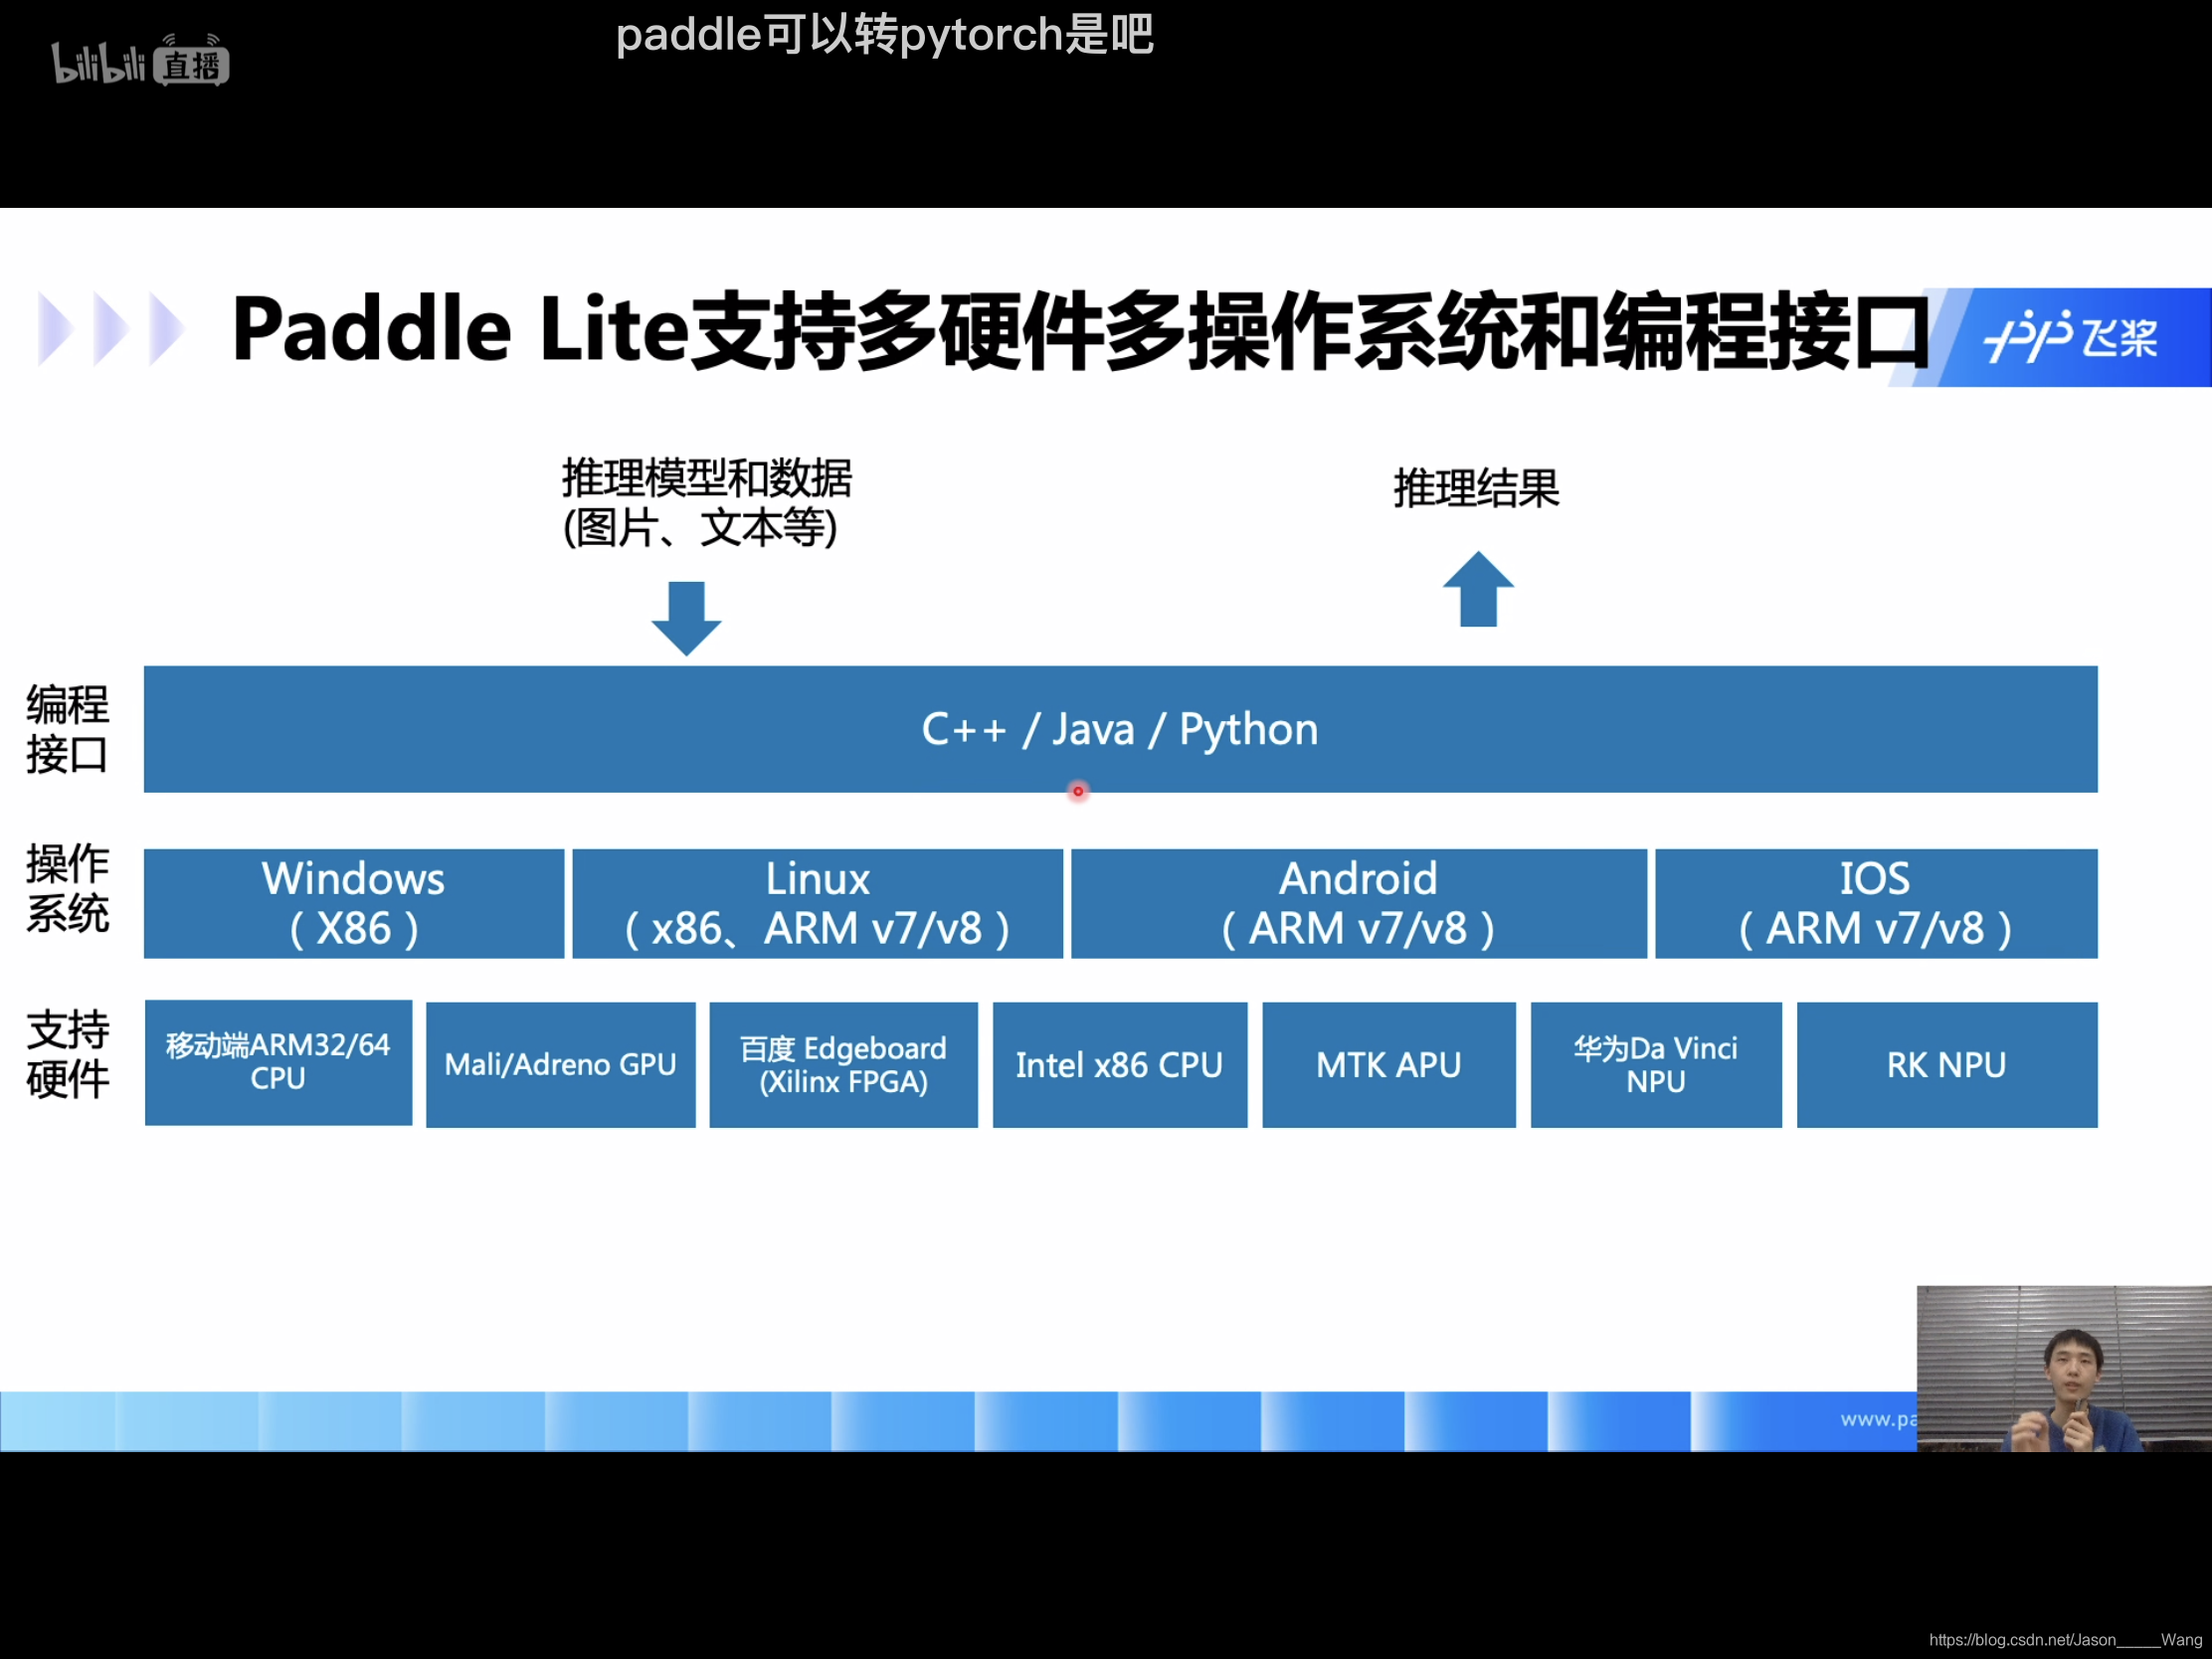
项目实践
参考链接:
https://aistudio.baidu.com/aistudio/projectdetail/1480672
保存模型参数时:
model.save(‘Hapi_MyCNN’) # save for training (动态图模型) 一般用于调优
model2.save(‘Hapi_MyCNN’, False) # save for inference (静态图模型) 一般用于部署
二者在部署时有一些区别
部署步骤:
使用OPT工具生成paddle lite 的.nb模型
对照paddle lite 预测库
对照paddle lite
笔记发布
多写笔记
投稿 投完了以后找灰酱 和paddlepaddle 相关的, 可以领奖励
抽奖
恭喜这些b
大作业讲解
明天再开一场直播 专门讲作业,今天快速过一下 明晚8点
cifar100 是一个100分类的数据集 是一个CV方向的图像分类题目
具体要求 见题目要求和参考

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)