stm32机器学习_嵌入式机器学习系列01:STM32图像分类背后的秘密
STM32运算速度提升从何而来?
没错!加速STM32图像分类处理速度的就是数字信号处理器(DSP)。
目前Arm的Cortex-M4, Cortex-M7, Cortex-M33和Cortex-M35P微控制器内核均带有DSP。
相对CPU(擅长调度)来说,DSP非常擅长做运算,神经网络中的卷积、池化等复杂的运算操作都可以交由DSP来处理,从而加快处理速度。
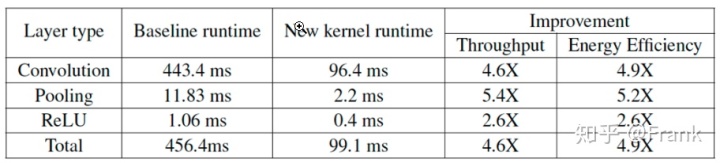
在Thumb指令集和可选浮点单元(FPU)上增加了DSP扩展,提高数值运算的性能。不仅使得在Cortex-M4、Cortex-M7、Cortex-M33和Cortex-M35P处理器上能够直接执行信号处理操作,而且还保持了Cortex-M编程模型的易用性。
查看项目源码中的arm_convolve_HWC_q7_RGB.c文件,你就会发现,STM32使用__SIMD32和__SXTB16等DSP指令以提高运算速度。
arm_status
arm_convolve_HWC_q7_RGB(const q7_t * Im_in,
const uint16_t dim_im_in,
...
q7_t * Im_out, const uint16_t dim_im_out, q15_t * bufferA, q7_t * bufferB)
{
#if defined (ARM_MATH_DSP)
/* Run the following code for Cortex-M4 and Cortex-M7 */
// 源码省略...
const q7_t *pPixel = Im_in + (i_ker_y * dim_im_in + i_ker_x) * 3;
q31_t buf = *__SIMD32(pPixel);
union arm_nnword top;
union arm_nnword bottom;
top.word = __SXTB16(buf);
bottom.word = __SXTB16(__ROR(buf, 8));
// 源码省略...
#else
/* Run the following code as reference implementation
for Cortex-M0 and Cortex-M3 */
// 源码省略...
#endif /* ARM_MATH_DSP */
/* Return to application */
return (ARM_MATH_SUCCESS);
}你也可以在Keil模拟器中体验一下在有无DSP的情况下,图像分类应用的执行速度。
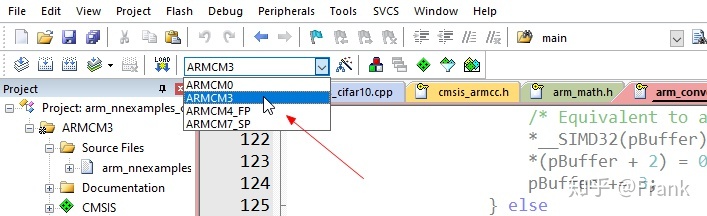
选择ARMCM3执行的时候将不会有DSP参与运算。
处理内存约束
STM32的内存是非常有限的,比如STM32F427AG只有256KB内存,在项目源文件arm_nnexamples_cifar10.cpp中,创建了col_buffer和scratch_buffer两个缓冲区,在神经网络的各层之间重用,从而实现减少内存用量。
- col_buffer 中存储的是卷积层的输出
- scratch_buffer 中存储的是中间层输出
// typedef int8_t q7_t;
// typedef int16_t q15_t;
q7_t col_buffer[2 * 5 * 5 * 32 * 2];
q7_t scratch_buffer[32 * 32 * 10 * 4];
// Cut the scratch buffer to two buffers.
q7_t *img_buffer1 = scratch_buffer;
q7_t *img_buffer2 = img_buffer1 + 32 * 32 * 32;
// conv2 img_buffer2 -> img_buffer1
arm_convolve_HWC_q7_fast(img_buffer2, CONV2_IM_DIM, CONV2_IM_CH, conv2_wt, CONV2_OUT_CH, CONV2_KER_DIM,
CONV2_PADDING, CONV2_STRIDE, conv2_bias, CONV2_BIAS_LSHIFT, CONV2_OUT_RSHIFT, img_buffer1,
CONV2_OUT_DIM, (q15_t *) col_buffer, NULL);
arm_relu_q7(img_buffer1, CONV2_OUT_DIM * CONV2_OUT_DIM * CONV2_OUT_CH);
// pool2 img_buffer1 -> img_buffer2
arm_maxpool_q7_HWC(img_buffer1, CONV2_OUT_DIM, CONV2_OUT_CH, POOL2_KER_DIM,
POOL2_PADDING, POOL2_STRIDE, POOL2_OUT_DIM, col_buffer, img_buffer2);arm_convolve_HWC_q7_fast函数创建了一个卷积层,在本例中卷积层以img_buffer2作为输入,以img_buffer1作为输出,以col_buffer作为内部卷积运算过程中的数据存储区。
然后激活函数层(arm_relu_q7函数)直接在img_buffer1 上进行ReLu操作,处理后数据依然放在 img_buffer1中。
再然后img_buffer1将作为最大池化层(arm_maxpool_q7_HWC函数)的输入,进行池化操作后,将数据输出到img_buffer2,如此反复的使用这2个内存区域,直到网络计算完成。
由于STM32上 内存非常有限,我们不能随意的给这2个内存区域分配很大的空间,我们需要精打细算。
其中col_buffer的大小的计算方法如下:
# 2*2*过滤器(卷积核)数量*卷积核宽度*卷积核高度
2*2*(conv # of filters)*(kernel width)*(kernel height)
这些参数可以在Caffe模型中查看到,如下图所示:
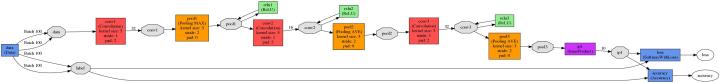
在本例中,我们一共有3个卷积层,其中一个卷积层(conv1)所需的内存空间最大(2*2*32*5*5=3200字节),所以col_buffer的大小就是3200字节。col_buffer将在所有的卷积层中使用。
scratch_buffer 分为两个部分img_buffer1和img_buffer2,对于某个特定的层来说,一个作为输入,则另一个作为输出。其大小可通过遍历各层的使用情况来确定。
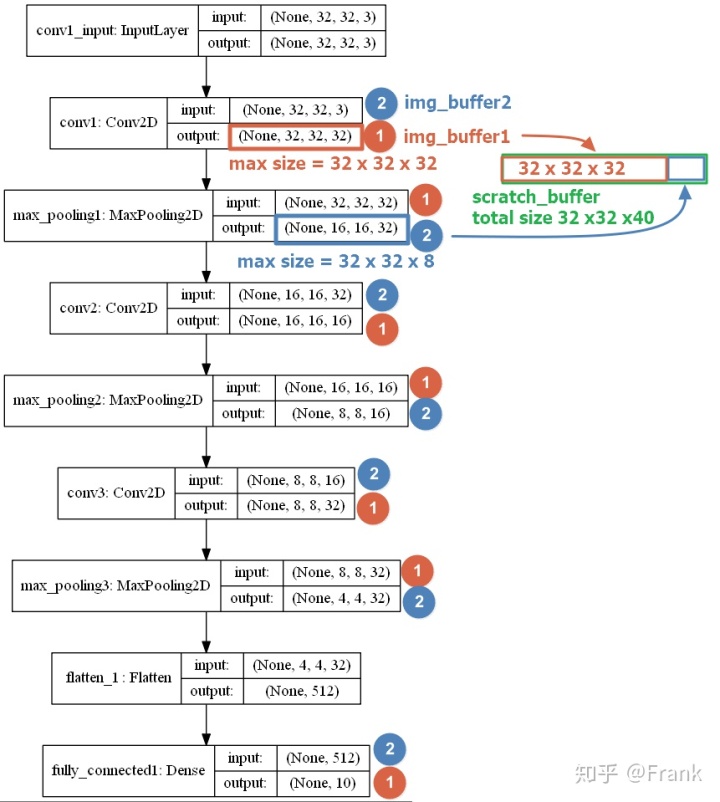
从上图可以看出scratch_buffer的大小为:
max(img_buffer1)+max(img_buffer2) = 32*32*40选择合适的卷积层函数
在CMSIS-NN库中,有多个卷积层函数:
- arm_convolve_HWC_q7_basic
- arm_convolve_HWC_q7_fast
- arm_convolve_HWC_q7_RGB
- arm_convolve_HWC_q7_fast_nonsquare
它们中的每一个都在不同程度上针对速度和大小进行了优化,但也有不同的针对性。
arm_ve_HWC_q7_basic函数是最基本的版本,设计用于任何二阶张量和任何维度的权重。
arm_ve_HWC_q7_fast函数正如它的名字所暗示的那样,运行速度比前一个函数快,但是要求输入张量通道是4的倍数,而输出张量通道(过滤器的数量)是2的倍数。
arm_ve_HWC_q7_rgb是专门为输入张量通道数等于3的卷积而构建的,它通常应用于第一个卷积层以RGB图像数据为输入的网络。
arm_convolve_HWC_q7_fast_nonsquare类似于arm_convolve_HWC_q7_fast,但是可以取非二阶的输入张量。
对于全连接层,两个最不同的选项是:
- arm_fully_connected_q7
- arm_fully_connected_q7_opt
第一个使用常规的权值矩阵,另一个使用后缀"_opt"来优化速度,但是层的权值矩阵必须预先以交错的方式排序。
总结
本期我们对STM32图像分类应用内部的3个关键点:DSP加速、内存使用和卷积层函数的选择进行了说明。希望对你的CMSISI-NN应用开发能够有所帮助。
可能有些同学对卷积、ReLu激活函数、最大池化等机器学习概念不熟悉,没关系,下期我们将着重介绍这些内容,欢迎持续关注!
更多精彩资讯,请扫码关注!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)