统计学习方法——(第二章)感知机及其收敛性、梯度下降
一、知识梳理
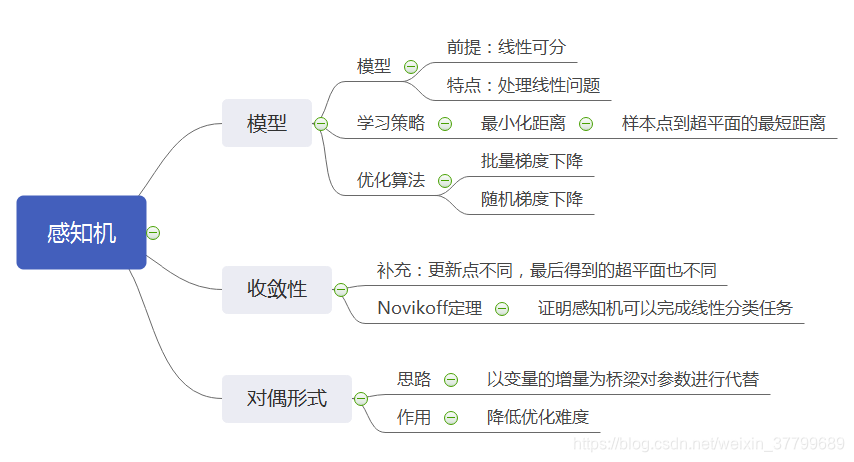
二、感知机
1、感知模型
1)概念
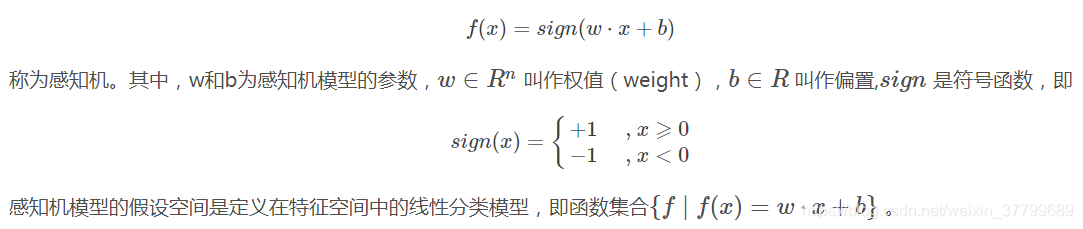
所谓感知机,就是二类分类的线性分类模型,其输入为样本的特征向量,输出为样本的类别,取+1和-1二值,即通过某样本的特征,就可以准确判断该样本属于哪一类。顾名思义,感知机能够解决的问题首先要求特征空间是线性可分的,再者是二类分类,即将样本分为{+1, -1}两类。具体模型如下:
2)学习策略
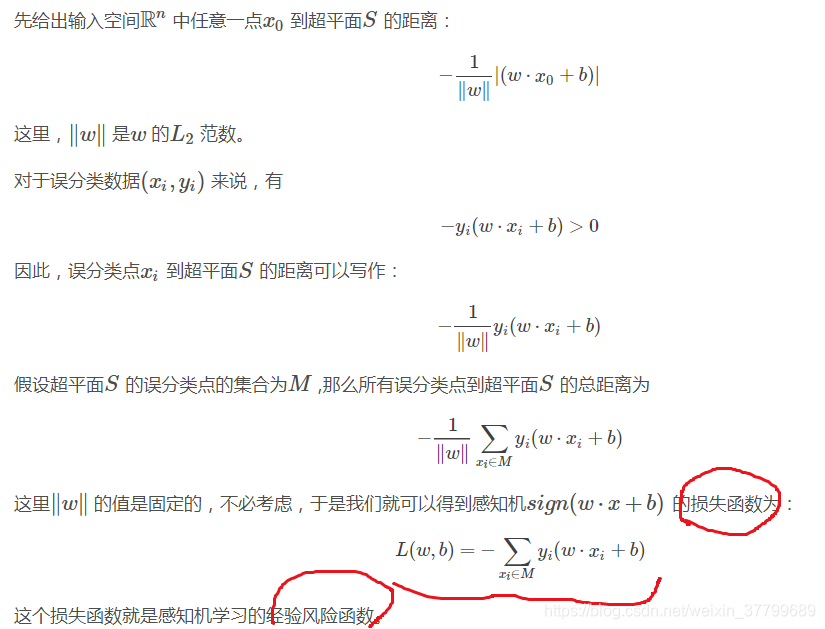
给定一个数据集T={(x1,y1),(x2,y2),...,(xN,yN)},T={(x1,y1),(x2,y2),...,(xN,yN)} ,其中,xi∈X=Rn,yi∈Y={+1,−1},yi∈Y={+1,−1} ,i=1,2,...,N。我们假定数据集中所有yi=+1的实例xi,有w⋅x+b>0,对所有yi=−1的实例xi,有w⋅x+b<0。
3)学习算法(梯度下降)
首先,通过上面的损失函数,我们很容易得到目标函数;再求解目标函数的最优参数(参考本人博客似然估计链接),即可完成参数的学习。感知机学习算法是误分类驱动的,具体采用随机梯度下降法( stochastic gradient descent )。目标函数如下:
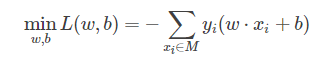
(1)批量梯度下降(随机梯度下降法的原始形式)
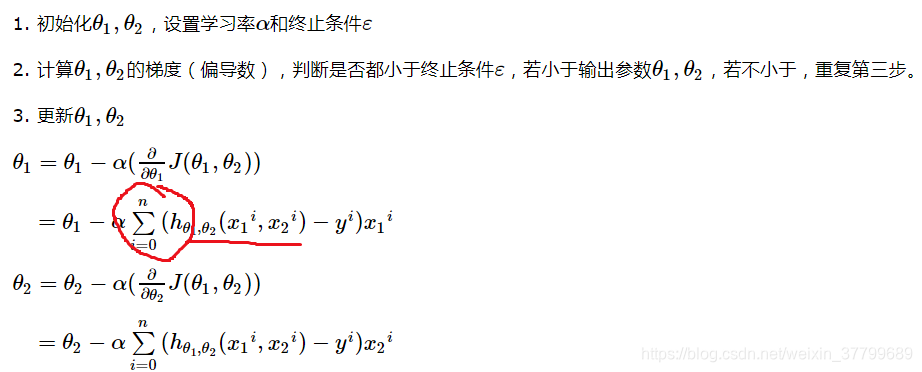
批量梯度下降法每次更新参数θ都要计算所有的样本数,求全局最优,所以训练开销很大。因此,它与随机梯度下降最大区别就是在求解梯度时,使用了所有误差的和。算法描述如下(下述公式中少个1/n,因为其目标函数中应该也有1/n,这与单样本的随机梯度下降的目标函数略有不同):
(2)随机梯度下降法
随机梯度下降(SGD)是一种简单但非常有效的方法,多用用于支持向量机、逻辑回归等凸损失函数下的线性分类器的学习。并且SGD已成功应用于文本分类和自然语言处理中经常遇到的大规模和稀疏机器学习问题。
假设误分类点集合M是固定的,那么损失函数L(w,b)的梯度为如下左式。其更新参数的方式为随机选取一个误分类点(xi,yi),对w,b进行更新如右式:
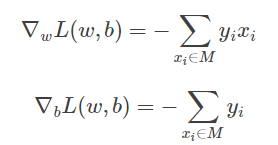
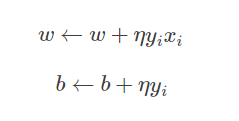
其中η(0<η⩽1)η(0<η⩽1) 为步长,也称学习率(learning rate)。步长越长,下降越快,如果步长过长,会跨过极小点导致发散;如果步长过小,消耗时间会很长。通过迭代,我们的损失函数就不断减小,直到为0。
补充:为什么使用随机梯度,而不是批量梯度?因为为SGD收敛速度比BGD要快
这里我们假设有30W个样本,对于BGD,每次迭代需要计算30W个样本才能对参数进行一次更新,需要求得最小值可能需要多次迭代(假设这里是10);而对于SGD,每次更新参数只需要一个样本,因此若使用这30W个样本进行参数更新,则参数会被更新(迭代)30W次,而这期间,SGD就能保证能够收敛到一个合适的最小值上。也就是说,在收敛时,BGD计算 10×30W次,而SGD只计算30W次.。
4)算法流程

#举例
train = [[(3, 3), 1], [(4, 3), 1], [(1, 1), -1]]

w = [0, 0]
b = 0

# 使用梯度下降法更新权重
def update(data):
    global w, b
    w[0] = w[0] + 1 * data[1] * data[0][0]
    w[1] = w[1] + 1 * data[1] * data[0][1]
    b = b + 1 * data[1]
    print(w, b)

# 计算到超平面的距离
def cal(data):
    global w, b
    res = 0
    for i in range(len(data[0])):
        res += data[0][i] * w[i]
    res += b
    res *= data[1]
    return res

# 检查是否可以正确分类
def check():
    flag = False
    for data in train:
        if cal(data) <= 0:
            flag = True
            update(data)
    if not flag:
        print("The result: w: " + str(w) + ", b: "+ str(b))
        return False
    flag = False

for i in range(1000):
    check()
    if check() == False:
        break
2、算法收敛性
1)证明要说明的问题:参考《Convergence Proof for the Perceptron Algorithm》
现已知有一个线性可分的数据集,即存在一个超平面,能将其中所有的数据点都正确地分类。现要证明这个算法是收敛的,即能通过有限次的迭代将这个超平面求出来(对参数的扩展比较好理解,本文不再赘述,看书即可)。
2)Novikoff定理(1)前半段:
对于该超平面,通过对系数的适当放缩,可使得权值向量的模为1。如,若已知该超平面为x+y+1=0,两边同时除以根号2,此时权值向量的模为1,得出的超平面与原超平面是同一个。这样做是为了后续简化操作。
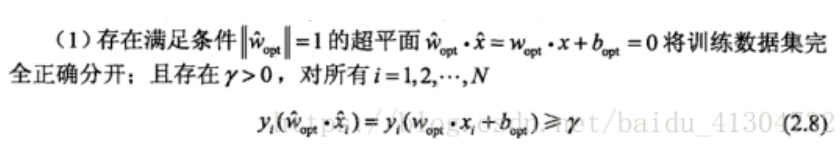
3)Novikoff定理(1)后半段:
后半段是为了找到下界,因此需要找到一个小于关系。这个超平面能将所有数据点正确分类(双正双负大于0),那么对于任意有限的样本xi,必有
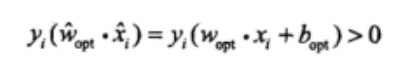
故存在(下界这不就有了)
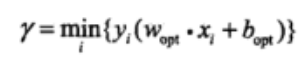
使得
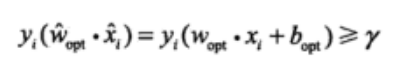
4) Novikoff定理(2)
定理2,所要说明的是寻找超平面的迭代次数总是有限的,即这个次数有一个上界:
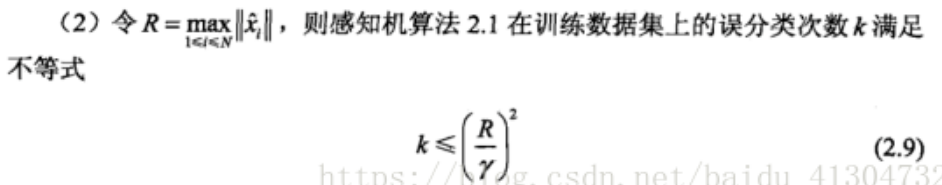
通过定理(1)已知:
第k个误分类的实例条件(下标0到k-1,k-1代表第k次误分类):
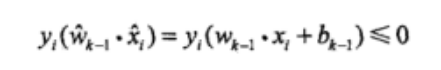
因为还有错误,还需要进行参数更新:
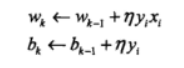
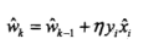
因此,代入定理1可得:
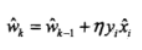
反复递推,直至下标k=0:
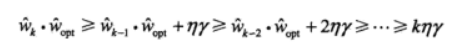
两边去取两边平方,再放缩得:
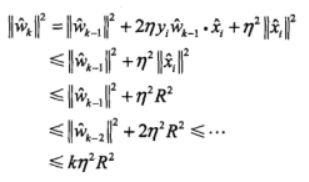
因此,得证,即误分类的次数k是有上界的,通过有限次的搜索一定可以求得这个分离超平面。同时,若数据集线性不可分,则算法不收敛,迭代结果发生震荡。
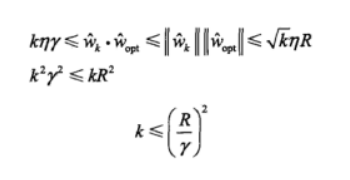
3、对偶形式
1)概念
对偶形式的基本思想是,将w和b表示为实例xi和标记yi的线性组合形式,通过求解其系数而求得w和b。这可以降低参数的求解难度,是算法可以更有效的优化目标函数的解。
2)感知机中的对偶
假设初始值w0,b0均为0,并对误分类点(xi,yi)进行更新,假设更新次数为n次,则w,b关于(xi,yi)的增量分别为αi*yi*xi和αi*yi,这里αi=ni*η,可以得到
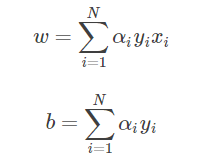
这里,α⩾0,i=1,2,...,N,当η=1时,表示第i个样本由于被误实例而进行的更新次数。某实例更新次数越多,表示它距离超平面S越近,也就越难正确分类。换句话说,这样的实例对学习结果影响最大。
3)算法流程

#举例
import numpy as np

train = np.array([[[3, 3], 1], [[4, 3], 1], [[1, 1], -1]])

a = np.array([0, 0, 0])
b = 0
Gram = np.array([])
y = np.array(range(len(train))).reshape(1, 3)# 标签
x = np.array(range(len(train) * 2)).reshape(3, 2)# 特征

# 计算Gram矩阵
def gram():
    g = np.array([[0, 0, 0], [0, 0, 0], [0, 0, 0]])
    for i in range(len(train)):
        for j in range(len(train)):
            g[i][j] = np.dot(train[i][0], train[j][0])
    return g

# 更新权重
def update(i):
    global a, b
    a[i] = a[i] + 1
    b = b + train[i][1]
    print(a, b)

# 计算到超平面的距离
def cal(key):
    global a, b, x, y
    i = 0
    for data in train:
        y[0][i] = data[1]
        i = i + 1
    temp = a * y
    res = np.dot(temp, Gram[key])
    res = (res + b) * train[key][1]
    return res[0]

# 检查是否可以正确分类
def check():
    global a, b, x, y
    flag = False
    for i in range(len(train)):
        if cal(i) <= 0:
            flag = True
            update(i)
    if not flag:
        i = 0
        for data in train:
            y[0][i] = data[1]
            x[i] = data[0]
            i = i + 1
        temp = a * y
        w = np.dot(temp, x)
        print("The result: w: " + str(w) + ", b: "+ str(b))
        return False
    flag = False


Gram = gram()# 初始化Gram矩阵
for i in range(1000):
    check()
    if check() == False:
        break

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)