python数据分析之参数估计实践
·
文章目录
1、加载相关库和数据集
- 使用的库主要有:pandas、numpy、sklearn、matplotlib、seaborn
- 使用的数据集:sklearn库中的鸢尾花数据集
import pandas as pd
import numpy as np
from sklearn.datasets import load_iris
import matplotlib.pyplot as plt
import seaborn as sns
import warnings

plt.rcParams["font.family"] = "SimHei"          # 设置可以显示中文字体
plt.rcParams["axes.unicode_minus"] = False
warnings.filterwarnings("ignore")             # 忽略警告信息
2、使用主要信息构造DataFrame
iris = load_iris()     # 加载鸢尾花数据集
# 拼接data信息和target信息,用于构造DataFrame
data = np.concatenate([iris.data,iris.target.reshape(-1,1)],axis=1)
feature_names = iris.feature_names    # 特征名列,包含花萼和花瓣的长度和宽度
feature_names.append("target")        # 将"target"添加至特征名列表,作为拼接数据的列名
df = pd.DataFrame(data,columns=feature_names)
3、点估计
- 使用样本的统计量去代替总体参数
- 能够给出具体的估计值
- 实现简单,但是容易受到随机抽样的影响,可能无法保证结论的准确性。
sepal_length = df["sepal length (cm)"]
sepal_length.mean()      				# 鸢尾花数据集花萼长度(包含150条数据)的均值,即总体均值

sepal_length.sample(100).mean()         # 随机抽样100条数据求均值,估算总体的均值,即点估计
4、中心极限定理
4.1 中心极限定理特征
-
如果总体(分布不重要)的均值为μ、方差为δ^2,我们进行随机抽样,样本容量为n,当n增大时,则样本均值逐渐趋近服从均值 为μ、方差为 δ^2/n 的正态分布。
-
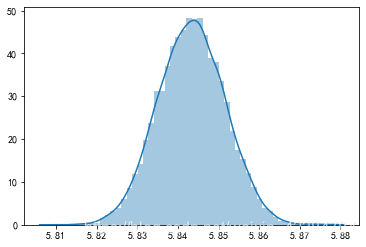
进行多次抽样,则每次抽样会得到一个均值,这些均值会围绕在总体均值左右,呈正态分布。
-
样本均值构成的正态分布,其均值等于总体均值μ,其标准差等于总体标准差除以根号n。
-
样本均值分布的标准差,我们称为标准误差,简称标准误。
4.2 中心极限定理的验证
- 使用鸢尾花花萼长度数据集验证
# 将鸢尾花花萼长度数据集数量增加100倍,即总数为150*100
sepal_length = df["sepal length (cm)"]
len(sepal_length)
total_sepal = np.concatenate([sepal_length for _ in range(100)], axis=0)
print(total_sepal.mean())       #  总体均值
print(total_sepal.std())        #  总体标准差

# 创建均值数组,用来存放每次抽样的均值。
mean_arr = np.zeros(10000)
# 循环10000次,使用 np.random.choice() 随机抽样,样本容量 size = 10000
for i in range(len(mean_arr)):
    mean_arr[i] = np.random.choice(total_sepal, size=10000).mean()

print(mean_arr.mean())    		#  样本均值构成的正态分布的均值
print(mean_arr.std())     		#  样本均值构成的正态分布的标准差
print(pd.Series(mean_arr).skew())    # 样本均值构成的正态分布的偏度
sns.distplot(mean_arr)         # 显示样本均值构成的正态分布
5、正太分布
5.1 正态分布的特性
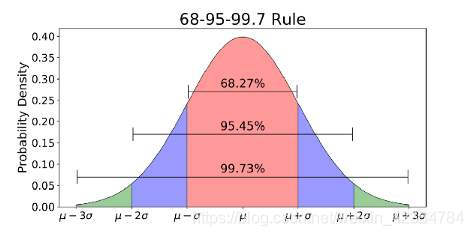
在正态分布中,数据的分布比例如下:
- 以均值为中心,在1倍标准差内,包含约68%的样本数据。
- 以均值为中心,在2倍标准差内,包含约95%的样本数据。
- 以均值为中心,在3倍标准差内,包含约99.7%的样本数据。
5.2 正太分布的验证
- 使用鸢尾花花萼长度数据集验证
# 将鸢尾花花萼长度数据集数量增加100倍,即总数为150*100
sepal_length = df["sepal length (cm)"]
total_sepal = np.concatenate([sepal_length for _ in range(100)], axis=0)

# 创建均值数组,用来存放每次抽样的均值。
mean_arr = np.zeros(10000)
# 循环10000次,使用 np.random.choice() 随机抽样,样本容量 size = 10000
for i in range(len(mean_arr)):
    mean_arr[i] = np.random.choice(total_sepal, size=10000).mean()

x = mean_arr
mean = mean_arr.mean()       #  样本均值构成的正态分布的均值
std = mean_arr.std()				#  样本均值构成的正态分布的标准差
for times in range(1, 4):
    y = x[(x > mean -times * std) & (x < mean + times * std)]
    print("{}倍标准差:{}%".format(times, len(y) * 100 / len(x)))
6、区间估计
6.1 区间估计
- 根据样本的统计量,计算出一个可能的区间和概率,表示总体的参数会有多少概率位于该区间中。
- 置信区间:区间估计指定的区间
- 置信度:区间估计指定的概率
- 能够给出合理的范围以及信心指数,但是不能给出具体的估计值。
6.2 置信区间
- 根据中心极限定理,如果多次抽样(总体的均值为μ、方差为δ^2),则样本的均值构成正态分布。如果我们对总体进行一次抽样,则该样本的均值有95%的概率会在以均值μ为中心的2倍标准差(样本均值构成的正态分布的标准差,即标准误)的范围内,仅有5%的概率在2倍标准差的范围外。
- 根据小概率事件,如果样本的均值在2倍标准差的范围外,我们可以认为,本次抽样来自的总体,该总体的均值并非是我们所期望的均值。
- 通常,我们以2倍标准差作为判定依据。以样本均值为中心,正负2倍标准差构成的区间,就是置信区间,此时的置信度为95%。
以下例子求出鸢尾花花萼长度均值的置信区间:
# 将鸢尾花花萼长度数据集数量增加100倍,即总数为150*100
sepal_length = df["sepal length (cm)"]
len(sepal_length)
total_sepal = np.concatenate([sepal_length for _ in range(100)], axis=0)

sample_mean = np.random.choice(total_sepal, size=10000).mean()
print("总体的均值:", total_sepal.mean())       #  总体均值
print("一次抽样的样本均值:", sample_mean)      # 一次抽样的均值

se = total_sepal.std() / np.sqrt(10000)     # 计算标准误差
min_ = sample_mean - 2 * se
max_ = sample_mean + 2 * se
print("置信区间(95%置信度):", (min_, max_))

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献5条内容

所有评论(0)