从零实现机器学习算法(二) 决策树(Decision Tree)
目录
1. 决策树算法简介
决策树原理比较简单,从决策树根节点开始,对待检测样本的某一个特征进行测试,根据测试结果转向左子树或者右子树,如此递归达到停止条件,叶节点所表示的类别,就是决策树对该样本的预测结果。
举个例子描述决策树决策过程,如下图所示:特征为 {饥饿状态, 经济情况},类别标签为{go to restaurant, buy a hamburger, go to sleep}。首先判断饥饿状态,如果饿了就转向左子树,进而判断经济情况,如果大于$125就去餐厅; 如果不饿则直接去睡觉。
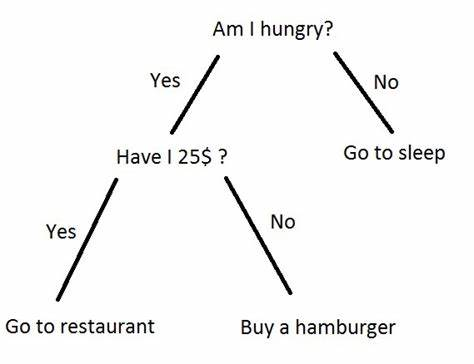
2. 决策树模型
构建决策树算法模型分为特征选择、决策树生成算法和分类规则,下面分别介绍
2.1 特征选择
特征选择的目的是选取对数据具有分类能力的特征,从而提高学习效率。特征选择包含两部分,第一部分是特征的选择,第二部分是特征值的选择。被选择的{特征,特征值}将作为决策树的结点,对待检测样本进行分类。
特征选择的准则为信息增益或者信息增益比。信息增益的定义为集合D的经验熵 与特征
给定条件下的经验条件熵
之差,即
特别的,根据特征 将
划分为两个子集时,信息增益计算公式为:
其中 为第一个子集的比例,即
\alpha=\frac{\left|D_{1}\right|}{\left|D\right|}
D1 与 D2是根据特征 A 将 D 划分的两个子集, 满足 ,其代码如下,当
等于0或1时单独计算是为了计算熵值时不报错。
 left_set, right_set = self.divideData(data, i, value)
 # calcuate information gain
 ratio = float(len(left_set)/sample_num)
 if ratio == 0.0:
     info_gain = init_entropy - (1 - ratio) * self.getEntropy(right_set[:, -1])
 elif ratio == 1.0:
     info_gain = init_entropy - ratio*self.getEntropy(left_set[:, -1])
 else:
     info_gain = init_entropy - ratio * self.getEntropy(left_set[:, -1]) - (1 - ratio) * self.getEntropy(right_set[:, -1])
信息增益比是特征 A对数据 D 的信息增益与数据集 D的经验熵之比,即
至此,我们已经知道了特征选择的方法,但是经验熵怎么计算呢?首先看下经验熵的公式
看起来很复杂的样子,其实就是计算样本标签中的熵,其代码如下,其中 uniqueCount()函数的功能是统计输入参数中不同类别标签的数目
    def getEntropy(self, labels):
        labels_num = len(labels)
        label_count = self.uniqueCount(labels)

        entropy = 0.0
        for j in label_count:
            prop = label_count[j]/labels_num
            entropy = entropy + (-prop*math.log(prop, 2))

        return entropy
2.2 决策树生成算法
知道如何划分的特征之后,就可以据此来生成决策树了。生成决策树的算法有很多,如ID3,C4.5等,其中ID3以信息增益为特征选择规则,C4.5以信息增益比为特性选择规则,本文以ID3为例。
首先了解下特征选择之后的划分过程,我们知道特征选择是为了选择对数据具有很好区分能力的特征,那么划分过程就是根据该特征的值对数据集进行划分,其代码如下。根据给定特征的索引index和给定的特征值value对数据集进行划分。首先变量数据集比较每个样本中对应index的特征的值和给定的特征值,如果该样本的特征值大于value值则将其放入右子树,并删除index对应的特征,反之放如左子树,并删除index对应的特征。(实际情况决策树可以处理非数值类型的特征,这里做了简化)
    def divideData(self, data, index, value):
        left_set = []
        right_set = []
        # select feature in index with value
        for temp in data:
            if temp[index] >= value:
                # delete this feature
                new_feature = np.delete(temp, index)
                right_set.append(new_feature)
            else:
                new_feature = np.delete(temp, index)
                left_set.append(new_feature)
        return np.array(left_set), np.array(right_set)
在构建决策树之前我们还需要简历相应的数据结构来存储决策树,定义一个决策树结点:
class DecisionNode:
    def __init__(self, index=-1, value=None, results=None, right_tree=None, left_tree=None):
        self.index = index                    # the index of feature
        self.value = value                    # the value of the feature with index
        self.results = results                # current decision result
        self.right_tree = right_tree
        self.left_tree = left_tree
接下来就可以递归的构造决策树了,如果数据集中没有特征了那么就停止构造决策树;如果信息增益小于给定的阈值,那么将其现存结果存入结点,停止构造决策树。反之,根据最优划分特征得到的左右子树分别构造决策树,直到满足停止条件。
    def createDecisionTree(self, data):
        # if there is no feature in data, stop division
        if len(data) == 0:
            self.tree_node = DecisionNode()
            return self.tree_node

        best_gain = 0.0
        best_criteria = None
        best_set = None

        feature_num = len(data[0]) - 1
        sample_num = len(data[:, -1])
        init_entropy = self.getEntropy(data[:, -1])

        # get the best division
        for i in range(feature_num):
            uniques = np.unique(data[:, i])
            for value in uniques:
                left_set, right_set = self.divideData(data, i, value)
                # calcuate information gain
                ratio = float(len(left_set)/sample_num)
                if ratio == 0.0:
                    info_gain = init_entropy - (1 - ratio) * self.getEntropy(right_set[:, -1])
                elif ratio == 1.0:
                    info_gain = init_entropy - ratio*self.getEntropy(left_set[:, -1])
                else:
                    info_gain = init_entropy - ratio * self.getEntropy(left_set[:, -1]) - (1 - ratio) * self.getEntropy(right_set[:, -1])
                if info_gain > best_gain:
                    best_gain = info_gain
                    best_criteria = (i, value)
                    best_set = (left_set, right_set)

        # create the decision tree
        if best_gain < self.t:
            self.tree_node = DecisionNode(results=self.uniqueCount(data[:, -1]))
            return self.tree_node
        else:
            ltree = self.createDecisionTree(best_set[0])
            rtree = self.createDecisionTree(best_set[1])
            self.tree_node = DecisionNode(index=best_criteria[0], value=best_criteria[1], left_tree=ltree, right_tree=rtree)
            return self.tree_node
2.3 分类规则
分类规则和二叉排序树类似,根据待检测样本的指定特征和其特征值与决策树结点存储的特征值进行比较,根据结果将其送入左子树或者右子树,其代码如下:
    def classify(self, sample, tree):
        if tree.results != None:
            return tree.results
        else:
            value = sample[tree.index]
            branch = None
            if value >= tree.value:
                branch = tree.right_tree
            else:
                branch = tree.left_tree
            return self.classify(sample, branch)
3. 总结与分析
在决策树生成后其实还有使用动态规划的剪枝处理旨在构建最优的决策树。还有一类分类与回归树(Classification and Regression Tree, CART),其由特征算则树的生成和剪枝组成,CART既能用于分类也能用于回归。最后贴一下本文实现的决策树与Sklearn检测性能的比较:
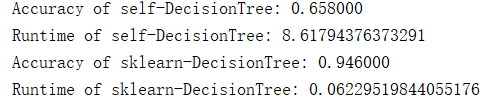
发现无论是时间和正确率都没有Sklearn的好,分析了下原因,可能是构建决策树的算法不够好,因为没有进行剪枝处理,其次是最优化划分的标准和递归停止条件的选择,这些以后会进行完善。
本文相关代码和数据集:https://github.com/Ryuk17/MachineLearning
参考文献:
[1] 李航, 统计学习方法
[2] Peter Harrington, Machine Learning IN ACTION
[3] 黄耀鹏,决策树算法的Python实现

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)