七周成为数据分析师 第七周:Python
1.Python基本功能
- 利用Python写脚本
- excel可视化有性能瓶颈,需要Python来实现。
- 安装(建议Anaconda)
2.Numpy和pandas
(1)numpy
(2)pandas
- 数据读取:pd.read_csv(默认utf-8)、info、head、tail、top、astype、query、
- 数据筛选:sort_values、rank、cut、qcut(分位法)、
pandas以类似字典的方式来获取某一列的值,比如df['A'],这会得到df的A列。
如果我们对某一行感兴趣呢?这个时候有两种方法,一种是iloc方法,另一种方法是loc方法。loc是指location的意思,iloc中的i是指integer。这两者的区别如下:
locworks on labels in the index.ilocworks on the positions in the index (so it only takes integers).
也就是说loc是根据index来索引,那么loc就根据这个index来索引对应的行。iloc并不是根据index来索引,而是根据行号来索引,行号从0开始,逐次加1。
- Python groupby :mysql不支持分组排序
- 关联:concat和merge:concat是强行耦合,merge,是有共同名,优先表进行耦合
查看:http://blog.csdn.net/zutsoft/article/details/51498026
- merge函数功能:将两组列数据拼接到一起
一般的简单调用模式:merge(left, right, how='inner', on=None)
参数说明:
- left与right:两个不同的DataFrame。
- how:指的是合并(连接)的方式有inner(内连接),left(左外连接),right(右外连接),outer(全外连接);默认为inner。
- on : 指的是用于连接的列索引名称。必须存在右右两个DataFrame对象中,如果没有指定且其他参数也未指定则以两个DataFrame的列名交集做为连接键。
数据库连接方式说明参考: SQL的四种连接-左外连接、右外连接、内连接、全连接
举例说明:
举例一(说明:使用重叠列key作为连接键。使用内连接:新的key列中的元素是df2和df1的key列中元素的交集,所以其中没有c键)
df1=DataFrame({'key':['a','b','b'],'data1':range(3)})
df2=DataFrame({'key':['a','b','c'],'data2':range(3)})
pd.merge(df1,df2) #没有指定连接键,默认用重叠列名,没有指定连接方式,data1和data2都是 0 1 2
#输出结果是:
data1 key data2
0 0 a 0
1 1 b 1
2 2 b 1举例二(说明:使用左外连接方式:包括df2和df1的连接键的交集和左表(df2)中的所有连接键,右表(df1)中中没有键值用NaN补充)
pd.merge(df2,df1,how='left') #通过how,指定连接方式
输出结果是:
data2 key data1
0 0 a 0
1 1 b 1
2 1 b 2
3 2 c NaN
同理可得右外连接方法;另外全外连接取得是两个表中的所有键值,也就是键值元素的并集。
举例三:(说明:多键连接时用on参数指定连接键。下面的一行代码指定key1和key2列为连接键。)pd.merge(df1,df2,on=['key1','key2']
- 多重索引

- 文本函数:
pandas的DataFrame,有时需要处理一些字符串类型列,运用Series.str列内置方法很方便。
1.one hot 独热编码,get_dummies
series=data['列名'].str.get_dummies(sep=',')
实现DataFrame中列有多值,且想把这列one hot下
2.切分字符串,split()
series=data['列名'].str.split(',')
把DataFrame列中字符串以','分隔开,每个元素分开后存入一个列表里
series=data['列名'].str.split(',',expand=True)
参数expand,这个参数取True时,会把切割出来的内容当做一列,产生多列。
series=data['列名'].str.split(',',expand=True)[0]
可以只要第一列。
3.替换,replace()
series=data['列名'].str.replace(',','-')
用‘-’代替‘,’
4.是否包含表达式,contains()
series=data['列名'].str.contains('we')
返回的是布尔值series
5.查找所有符合正则表达式的字符findall()
series=data['列名'].str.findall("[a-z]")
以数组的形式返回
6.计算字符串的长度,len()
series=data['列名'].str.len()
7.去除前后的空白字符,strip()
series=data['列名'].str.strip()
rstrip() 去除后面的空白字符
lstrip() 去除前面的空白字符
8.isalnum() 是否全部是数字和字母组成
isalpha() 是否全部是字母
isdigit() 是否全部都是数字
isspace() 是否空格
islower() 是否全部小写
isupper() 是否全部大写
istitle() 是否只有首字母为大写,其他字母为小写
- 去重:
(1)pd.dropna()去除所有还有空值的行
(2)fillna() 填充
(3)填充空值,None需要用np.nan,c语言形式的控制;
(4)数据去重可以使用duplicated()和drop_duplicates()两个方法。
DataFrame.duplicated(subset = None,keep =‘first’ )返回boolean Series表示重复行
参数:
subset:列标签或标签序列,可选,仅考虑用于标识重复项的某些列,默认情况下使用所有列
keep:{‘first’,‘last’,False},默认’first’。
first:标记重复,True除了第一次出现。
last:标记重复,True除了最后一次出现。
错误:将所有重复项标记为True。
# 删除 dataframe 重复数据
DataFrame.drop_duplicates(subset=None, keep='first', inplace=False)
subset : 用来指定特定的列,默认所有列;
keep : {‘first’, ‘last’, False}, 删除重复项并保留第一次出现的项;
inplace : boolean, 是直接在原来数据上修改还是保留一个副本,默认为False ;
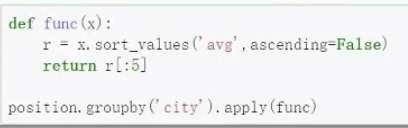
- 聚合 apply

apply函数是`pandas`里面所有函数中自由度最高的函数,将func里面的函数运用到daraframe,速度很快。
该函数如下:
DataFrame.apply(func, axis=0, broadcast=False, raw=False, reduce=None, args=(), **kwds)| 参数: | 函数 : 要应用于每个列或行的函数。 axis : {0或'index',1或'columns'},默认为0 应用函数的轴:
广播 : 布尔,可选 仅与聚合函数相关:
自版本0.23.0后不推荐使用:此参数将在将来的版本中删除,替换为result_type ='broadcast'。 raw : bool,默认为False
reduce : bool或None,默认为None 尝试应用减少程序。如果DataFrame为空,则apply将使用reduce来确定结果应该是Series还是DataFrame。如果 自版本0.23.0后不推荐使用:此参数将在将来的版本中删除,替换为 result_type : {'expand','reduce','broadcast',None},默认无 这些只在
默认行为(无)取决于应用函数的返回值:类似列表的结果将作为一系列结果返回。但是,如果apply函数返回一个Series,则它们将扩展为列。 版本0.23.0中的新功能。 args : 元组 除了数组/系列之外,传递给func的位置参数。 ** kwds 其他关键字参数作为关键字参数传递给 func。 |
|---|
该函数最有用的是第一个参数,这个参数是函数,相当于C/C++的函数指针。传入参数根据axis来定,比如axis = 1,就会把一行数据作为Series的数据结构传入给自己实现的函数中,我们在函数中实现对Series不同属性之间的计算,返回一个结果,则apply函数会自动遍历每一行DataFrame的数据,最后将所有结果组合成一个Series数据结构并返回。
- 聚合运算agg
- pandas数据透视
DataFrame.pivot_table(values = None,index = None,columns = None,aggfunc ='mean',fill_value = None,margin = False,dropna = True,margins_name ='All' )[source]
创建一个电子表格样式的数据透视表作为DataFrame。数据透视表中的级别将存储在结果DataFrame的索引和列上的MultiIndex对象(层次索引)中。
| 参数: | values : 要聚合的列,可选 index : 列,Grouper,数组或前一个列表 如果传递数组,则它必须与数据的长度相同。该列表可以包含任何其他类型(列表除外)。在数据透视表索引上分组的键。如果传递数组,则它的使用方式与列值相同。 columns : 列,Grouper,数组或前一个列表 如果传递数组,则它必须与数据的长度相同。该列表可以包含任何其他类型(列表除外)。在数据透视表列上分组的键。如果传递数组,则它的使用方式与列值相同。 aggfunc : function,function of list,dict,default numpy.mean 如果传递的函数列表,生成的数据透视表将具有分层列,其顶层是函数名称(从函数对象本身推断)如果传递dict,则键是要聚合的列,值是函数或函数列表 fill_value : 标量,默认无 用于替换缺失值的值 margin : boolean,默认为False 添加所有行/列(例如,对于小计/总计),汇总项; dropna : 布尔值,默认为True 不包括条目全部为NaN的列 margins_name : string,默认为'All' 当margin为True时,将包含总计的行/列的名称。 |
|---|---|
| 返回: | table : DataFrame |
- python连接数据库:(略)可以看看我的全栈工程师笔记
3.数据可视化
matplotlib : import matplot.pyplt as plt
一层一层添加
概率:
- distplot 概率分布图
- kdeplot 概率密度图
- jointplot 联合密度图
- pairplot 多变量图
分类:
boxplot箱线图violinplot提琴图barplot柱形图factorplot因子图线性:
- Implot 回归图
- heatmap 热图
4.案例实战分析
一份有关销售数据的简单数据分析报告 :https://www.kesci.com/apps/home/project/5aa687afcbc87e3f21332885
5.数据分析平台
本次使用的是Python中的superset库,基于web的数据分析平台。
严重提示:安装这个库一定要新建一个虚拟环境后再进行pip安装,不然会使得依赖库和Anaconda中的部分库冲突,使得原环境的库无法正常调用
使用逻辑:
- 先加载数据库或者数据文件
- 写好sql语法,进行一定编辑数据集。
- 在silces里面对于数据集,进行一个个图的绘画与调整
- Dashboard里进行最后图表的汇合。
注:个人觉得如果不是专业的数据分析师比如我是PM,还是不建议看这么深,到4就可以了!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 5
 0
- 0


 已为社区贡献20条内容

所有评论(0)