自进化AI/Agent
AI Agent的发展
这两年,世界上变化最剧烈的,可能除了半导体的价格和美伊的战与和外,就是人形机器人和Agent了。相比于人形机器人主要还是技术进步,离产品成熟、大规模落地还有距离,Agent则是已经在改造各行各业,已经改变了很多人的行为习惯。曾经,我们以为智能手机、移动支付、外卖滴滴的技术普及速度已经够快了,可大模型和智能体,让我们对速度又有了新的概念。一年前似乎还存在于媒体文稿中的概念,一年后却成为了自己每天习以为常的东西,甚至不会想到它一年前还不存在......
2016年,AlphaGo击败李世石,从此彻底改变了围棋,也加速了人类历史进程。作为一个围棋Agent,AlphaGo不仅仅是依靠CNN和强化学习,同时也是包括蒙特卡洛树的一整套系统设计。可作为一个仅用于围棋、或者说用于完全信息博弈游戏的Agent,当时人们还对Agent这个词不太在意,更多记住的是CNN和深度强化学习的强大。
2020年,跨时代的GPT-3出现了,它证明了LLM的Zero-shot能力,各类任务,似乎有可能都统一在基于字符系统的自回归范式下。它提出的In-Context Learning,也开启了prompt工程时代。一夜之间,似乎语文能力竟成了大模型时代的核心竞争力之一。
InstructGPT和ChatGPT之后,LLM的聊天能力很快受到认可。与此同时,LangChain框架出现了,LLM和Agent被紧密联系起来。2023年,OpenAI又提出革命性的Function Calling,让人们意识到LLM不仅仅是聊天工具,它可以成为“真正的大脑”。2022年,CoT证明逐步推理能显著提升复杂任务表现;之后o1和DeepSeek-R1通过更多的逻辑思考、更多的输出tokens,进一步强化了LLM的能力。
AutoGPT基于ReAct范式,自造JSON协议,让Agent基于LLM可以循环思考、观察、行动,开启了智能体框架进化之路。但由于成功率低、容易陷入大量循环,以及受限于当时的LLM能力,这套范式并没有改变业界。而后续框架如LangGraph、Dify,也更多强调可控性,通过先计划后执行,并在执行中调整计划,Agent任务的成功率显著提升。
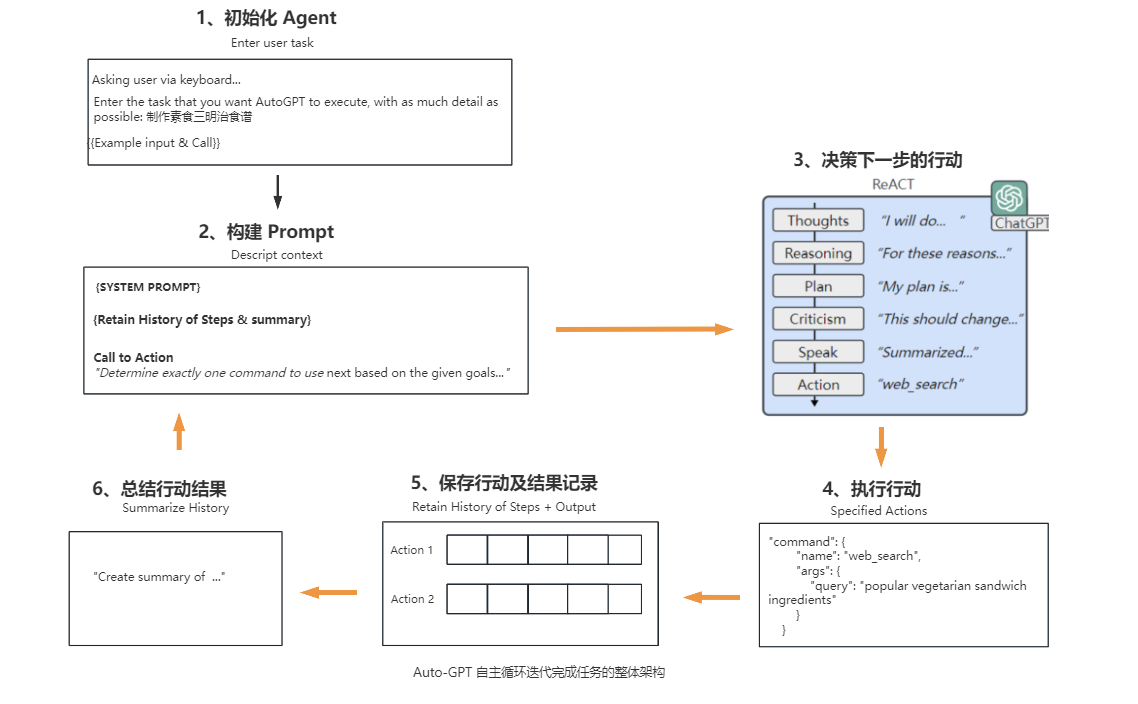
上下文越来越多,Prompt开始变得越来越长,LLM也继续往更长的输入窗口发展,Kimi当时就以超长上下文而著称。同时RAG火热了起来,通过对外置数据库进行检索,可以有效减少LLM的天马行空,成为了各行业LLM落地的必配技能。可人们和LLM聊的越来越多,上下文终究不能无限制增长下去。为此,MemGPT提出分层记忆管理,Zep做了长期记忆的自动摘要与时序管理。
开源社区里飞速更新的Agent框架和方案,逐渐补全了各维度能力:BabyAGI把“任务循环”剥成独立范式,HuggingGPT调度视觉等专业模型,Generative Agents通过记忆流+重要性评分+反思解决“记不住事”问题,MetaGPT和CrewAI让人们看到了多Agent协作的效益,SWE-agent集成完整linux沙箱得到了真实可操作的计算机环境,FrugalGPT提出成本感知路由实现“能省则省”,Claude通过Computer Use让LLM直接看屏幕、点鼠标,Google提出A2A协议解决Agent间对话。
有了基础的Agent框架,能用什么工具就成了瓶颈了。Anthropic提出MCP,将各种通过Function Calling调用的接口标准化,对Agent在全行业落地有着巨大意义。一时间,MCP又成了国内各大公司里的流行词,似乎什么业务都得用MCP封装下。
在这些地基之上,Manus在2025上半年横空出世,能力传得玄乎其神,同时邀请码一码难求,又创造了一个个速度记录。它综合了上述各大成果,通过云端虚拟机多Agent协作和Claude 3.5/3.7 Sonnet的强大性能,确实能实现很多以前做不了的复杂任务。同期Claude Code和Codex也先后发布,编程也因此成为第一个真正跑通的垂直场景:代码有编译器和测试当裁判,动作对不对,环境立刻给硬反馈;它们至今仍是最流行的Agent。2026年初OpenClaw爆火,形成了“龙虾热”;和Manus相反,OpenClaw是部署在本地的开源框架,还能通过网关接入各主流聊天平台。
另外,Reflexion将失败的任务生成文字反思并写入记忆。Voyager将Minecraft里验证过的技能自动存库复用,让Agent的经验得以沉淀,成为了Skill和自进化的开端。2025年10月Anthropic发布Agent Skills,通过渐进式披露和柔性剧本的巧妙设计,使得Skills迅速成为了跨平台标准。这一点又打开了大家对于Agent自进化的想象力,国内的EvoMap和国外的Hermes,都开始在Skill进化上继续创新。
自进化的基本范式
控制论里,Wiener的反馈回路把“感知自身状态并据此调整自己”抽象成普适框架。冯·诺依曼则再进一步问到:机器能不能复制、并改进自身?图灵在《Intelligent Machinery》里也设想过一台能通过学习变聪明的机器。还有Good在1965年提出“超智能机器”——足够强的系统能改进自己,进而更快地改进自己。
时至今日,这些古老的设想通过自进化Agent,终于有了实现的可能。我将自进化Agent定义为:长期运行于开放环境、能持续交互并累积改进自身状态、策略、技能或结构,乃至改进方式本身亦可被自我改进的计算系统。
与学界的定义相比,如Gao等人那篇自进化综述(arXiv:2507.21046),是把进化拆成“改什么、何时改、靠什么信号”横向分类,本文跟它们同谱系——都把进化理解为“系统在交互闭环里持续改自己”——但进一步把这些维度排成了阶梯。谱系另一头是哥德尔机(Schmidhuber, 2003):一个理论上能改写自己全部代码、且只在可证明会变好时才动手的构造,代表“改进方式被改进”的终点。
学术定位上,这个定义与强化学习任务非常类似:“在未知环境中,通过试错交互,学到一个策略π,使长期累积奖励的期望最大”。只不过,这里的定义更强调“开放环境”,以及不一定有什么固定的“奖励”,进化的对象也不止是策略。除此之外,进化计算给出“怎么改”的机制,遗传算法把变异、选择、遗传搬进程序,是“累积改进”最原始的操作。元学习对应的是最后那句“改进方式本身亦可被自我改进”——学的不再是任务,而是“怎么学任务”。AutoML则把“改结构”工程化,自动搜网络结构、调超参,是这套思想在工业界的落地形态。
一个自进化系统要跑起来,闭环里离不开六个问题:谁判定该进化了(触发)、改什么(对象)、怎么改(方式)、靠什么数据改(数据来源)、怎么算改好(评价)、各环节如何相互影响(耦合)。基于对这六部分的分析,我们可以得到自进化Agent的分级:
|
维度 |
L0 |
L1 |
L2 |
L3 |
L4 |
L5 |
|
①触发 |
人工 |
系统检测·人审核 |
自主触发 |
自主触发 |
触发条件可进化 |
触发条件可进化 |
|
②对象 |
代码/权重 |
记忆 |
资产(记忆/技能/策略/结构) |
资产动态组合 |
机制本身 |
机制+系统运行环境 |
|
③方式 |
人工改 |
简单累积 |
固定机制 |
自主选方式 |
方式可进化 |
方式可进化 |
|
④数据 |
人工设计 |
系统采集·人筛选 |
自主采集 |
自主调整采集方向 |
数据获取策略可进化 |
数据定义可进化 |
|
⑤评价 |
人工评测 |
系统评·人确认 |
封闭域自动评价 |
开放域自动评价 |
评价方式可进化 |
评价标准可进化 |
|
⑥耦合 |
独立 |
独立 |
独立 |
单向影响 |
机制级耦合 |
范式可进化 |
与现有分级比,如HuggingFace的“智能体五级”,从无记忆的被动响应、到会调工具、能规划、多智能体协作,最后一级才是“自我进化”。这把尺量的是“智能体有多自主”,不是“它随时间的进步能力有多强”。Shilong Liu(即Gao那篇综述的合作者)在个人博客里给过一个更简单的三层分类:只优化产出物(artifact)、改进脚手架(harness,记忆、提示词、工具、技能)、直到真去学模型参数(model)。但作者自己也说,这是帮人分清进化发生在哪个位置的地图,不是由浅入深的阶梯。
我们再来具体分析下每个级别:
L0:纯人工。对象就是代码和权重,人按反馈手动修bug、调参、发新版。传统软件和机器学习开发都在这,没自进化什么事。
L1(记忆沉淀):系统能检测到该进化了,但等人审核;对象是记忆,方式是简单累积,数据系统采、人来筛,评价是“系统评、人确认”。如Generative Agents的记忆流加反思、MemGPT的分层记忆、Zep的长期摘要。典型场景是对话Agent自动记住你的偏好,越聊越懂你,但每次积累都有人把关。影响停在个性化体验,进化最浅。
L2(经验沉淀,当前主流):触发彻底自主,系统自己觉得“这场景我不行、该进化了”就动手。对象扩到记忆、技能、策略、结构,方式是固定机制,数据自主采集,评价靠封闭域硬裁判(代码有测试、游戏有胜负)。如Voyager在Minecraft里沉淀技能复用,Reflexion把失败反思写回记忆,Devin和SWE-agent拿测试当裁判。典型场景,如Coding Agent卡在某类bug上,反复改、反复跑测试,再把解法固化成技能,下次碰到同类问题直接复用。Coding上能率先应用这套范式,也是因为评价很容易拿到。但当前业界的进化方式主要集中在记忆和Skill上,模型和结构上的自进化工作较少。这一阶段,产业上的变化是,企业开始积累“数字员工的经验库”,从雇人写代码变成部署Agent加维护技能库,组织形态开始松动。
L3(自选进化方式):和上一级相比,进化方式从固定变系统自选,系统按任务自己挑“沉淀技能、调模型还是改策略”,对象也升级成资产的动态组合,数据采集方向自己调。最难的是评价——L2靠测试、胜负这类硬裁判跑通,L3进了开放域,没有硬裁判,怎么算改好得自己回答。目前没有成熟系统,几个多Agent编排框架只是逼近;EvoMap、Hermes那批Skill进化方向正冲着这层,但还停在“把技能进化做好”,没走到更多样的进化方式,更别说“连进化方式都自己选”。一旦做成,系统就从垂直场景往通用任务走。到了这个级别,Agent变成了种子而非成品,每个部署各自变强。AI的智能在工业界、科研界加速提升,人们将看到那条预言中“AI智能曲线”的恐怖梯度已现,呼吁加强AI安全监管的呼声将铺天盖地。
L4(机制本身):学习机制、调度框架、进化流程这些变成可动对象,操作层递归打开。评价上,L3用的还是人定的固定启发式(LLM-as-a-Judge这类),L4是系统自己发明评价维度、改进评价方法本身。比如一个质检Agent,原来用固定模板记错误“类别+图片”。某天发现新出现的缺陷类型用老分类套不上,于是它自己把反思逻辑从“往老类别里硬塞”改成“先判断是不是新类别、是新类别就开新桶”;同时质检评价的标准,也可能根据实际的长尾case进行自进化。到了这个级别,干活可能就完全交给Agent了,人类能做的就是监控Agent,特别是监控它评价标准的修改。而AI自主做的这些进化,也将带动人类认知的协同提升。
L5(范式可进化):L4改的还是一条条机制,L5改的是机制之间怎么组织,已经不是“改零件”,是“改蓝图”。它有能力修改自身的任何部分,甚至优化它自己所在的运行环境。能限制它的,可能只有它所处的硬件基础。同时它有对最底层的任务目标、数据定义进行思考和优化的能力,甚至可能有自己的价值观、世界观、美学品味。这个阶段的AI Agent,已经是毫无争议的ASI,也许已经可以理解为一个独立的“物种”。
进化触发条件
自进化不是无时无刻都在发生。触发条件决定了“什么时候该进化”,太频繁会淹没在噪音里,太稀疏会错失学习窗口。
L0无触发,进化就是人工发版。工程师看监控、读反馈、改代码,节奏由人定。
L1系统检测、人审核。Agent能感知到“这里好像不对”——比如对话中用户连续三次纠正同一个问题——但动手前等人确认。Generative Agents的记忆流在积累到阈值时触发反思,但反思内容是否写入长期记忆,由预设规则决定,本质上还是人定门槛。MemGPT的page fault也是系统检测(上下文满了),但换入换出策略是硬编码的。
L2自主触发,系统自己判定“该进化了”。Voyager在Minecraft里执行成功就触发Skill入库,失败就触发重新尝试;Reflexion在任务失败后自动触发反思写入。关键差异在于触发标准从“人定规则”变成“环境反馈”——代码跑通了、测试通过了、游戏任务完成了,这些硬信号直接触发固化,无需人确认。
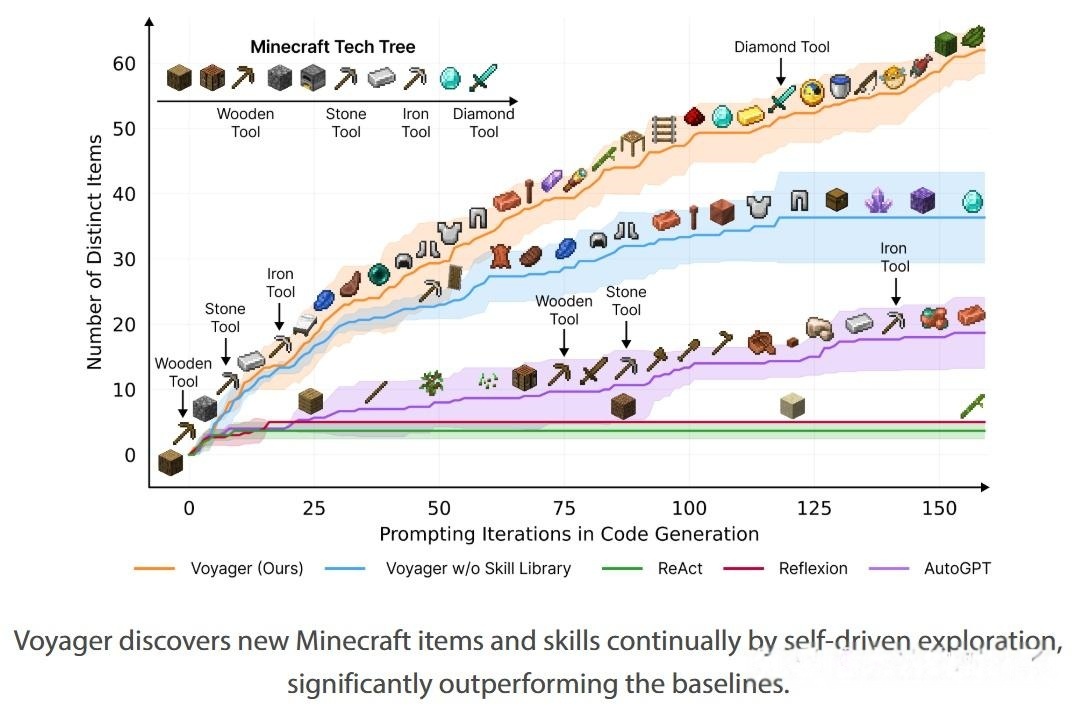
但L2的触发机制是固定且单一的。Voyager只认“执行成功”,不会问“这个成功有没有泛化价值”;Reflexion只认“任务失败”,不会区分“失败是因为策略错了还是环境变了”。这导致两个典型问题:伪成功(代码碰巧跑通但逻辑有隐患被固化)和伪失败(环境临时抖动触发无意义反思)。
L3开始自主选触发条件。系统根据任务类型、历史成功率、资源消耗,动态决定“这次该不该沉淀经验”。比如编程Agent发现某类bug的修复模式已经存了五个相似版本,触发条件从“每次成功都存”收紧为“只有显著不同的解法才存”。这背后是元策略在进化——不是人调阈值,而是系统自己学出什么该触发。
L4–L5触发条件本身可进化。系统运行一段时间后,发现预设的“失败即反思”策略在复杂多步任务中噪音太大,自动改成“只在关键里程碑失败时触发”,或者发明出全新的触发维度(如“用户情绪突变”作为触发信号)。
产业现状:当前主流产品在L1–L2之间。触发机制的设计是工程上最被低估的环节——大多数团队把触发条件写死在代码里(“失败就反思”、“成功就存Skill”),从不根据实际数据调优。结果是沉淀库膨胀极快,有效经验占比不到10%。
数据的获取
进化需要燃料,燃料的质量直接决定进化的方向。
L0人工设计数据。工程师写测试用例、造合成数据、标训练集。传统机器学习开发全在这层。
L1系统采集、人筛选。RLHF标准流程:模型产候选,人标偏好,筛完训奖励模型,一代接一代。Zep、MemGPT自动记日志,但记什么、怎么压是人定规则。
L2自主采集。系统自己决定采什么、怎么采。Voyager在Minecraft里自动记录所有动作-观测对;Reflexion把失败任务完整轨迹回填当下一轮输入;AlphaGo Zero自对弈490万局、不碰人类棋谱;Self-Instruct用175个种子任务滚出8.2万条指令微调数据。关键是采集方向固定——系统只采预设维度,不会主动探索“还有什么该采”。
L3自主调整采集方向。系统发现现有数据不足以改进某类任务,主动调整采集策略。Pioneer Agent真做到了:自己抓数据、自己建评测集,发现某类样本错得多就定向补那类,再联合优化数据/超参/学习策略训小模型。比如客服Agent发现“退换货”场景的失败率高,自动增加该场景的用户追问数据权重。
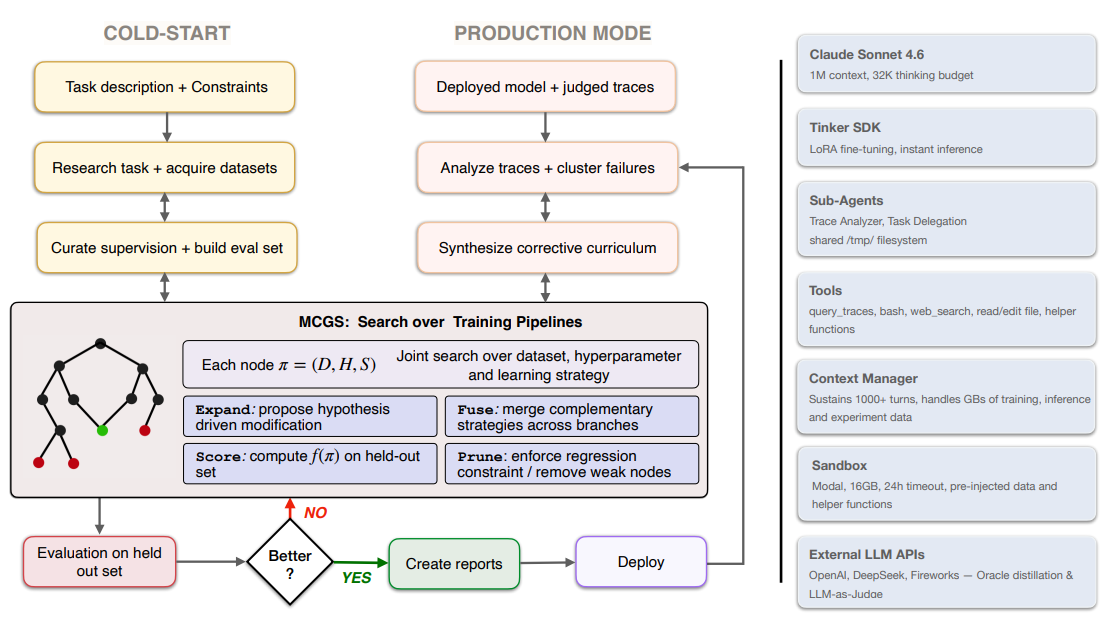
L4数据获取策略可进化,L5连“什么算数据”的定义都可变。今天没人够到。这条轴和L1正好倒过来:L1数据值钱、策略不值钱;越往上,数据越便宜,“该采什么”的决策越值钱。
产业痛点:
脏数据污染:用户说“我不是这个意思”被当成负样本,之后反复误导模型。
分布漂移:三个月前采集的数据反映的是旧版UI,新版上线后旧经验反而有害。
冷启动:新Agent没有历史数据,触发不了进化,陷入“没经验→做不好→没数据”的死循环。
隐私合规:用户对话落盘后,脱敏、去标识化、合规审查的成本极高,很多企业选择“少采少存”,直接牺牲了进化潜力。
相关技术:
数据清洗流水线:自动去重(SimHash)、去敏感信息(PII检测)、去明显错误(规则过滤)。
合成数据生成:Self-Instruct、Agent自己生成对抗性测试用例,但合成数据的质量控制和多样性保证是硬骨头。
主动学习(Active Learning):Agent主动选择“哪些数据点最值得人类标注”,降低标注成本。但在开放域,不确定性估计本身就不准。
进化效果的评价
没有评价,进化就是盲人摸象。评价方式的上限,直接决定了进化深度的上限。
L0人工评测。人看结果、打分、写反馈。传统软件测试、模型评估全在这层。
L1系统评、人确认。Agent自己给个初步判断,但最终由人拍板。比如RAG系统先算faithfulness分数,低于阈值的人工复核;Generative Agents的重要性评分;MemGPT的检索评分。
L2封闭域自动评价。有硬裁判:代码跑单元测试、数学公式代入验证、游戏任务有明确胜负。Voyager靠“代码执行不报错”验证Skill;Devin靠“测试全绿”确认修复有效;AlphaGo靠对局比赛的胜负构建奖励;AlphaGeometry靠“证明被形式化验证器接受”确认正确。
L3开放域自动评价。没有硬裁判,只能靠启发式:LLM-as-a-Judge(用更强模型评判弱模型)、RAGAS(faithfulness + answer relevance)、用户留存率代理指标、人工打分的历史分布拟合。这些方法的共同问题是有偏且不可信——评判模型偏好长回答、自信语气、特定风格;RAGAS在复杂推理任务上相关性弱;用户留存率受太多因素干扰。
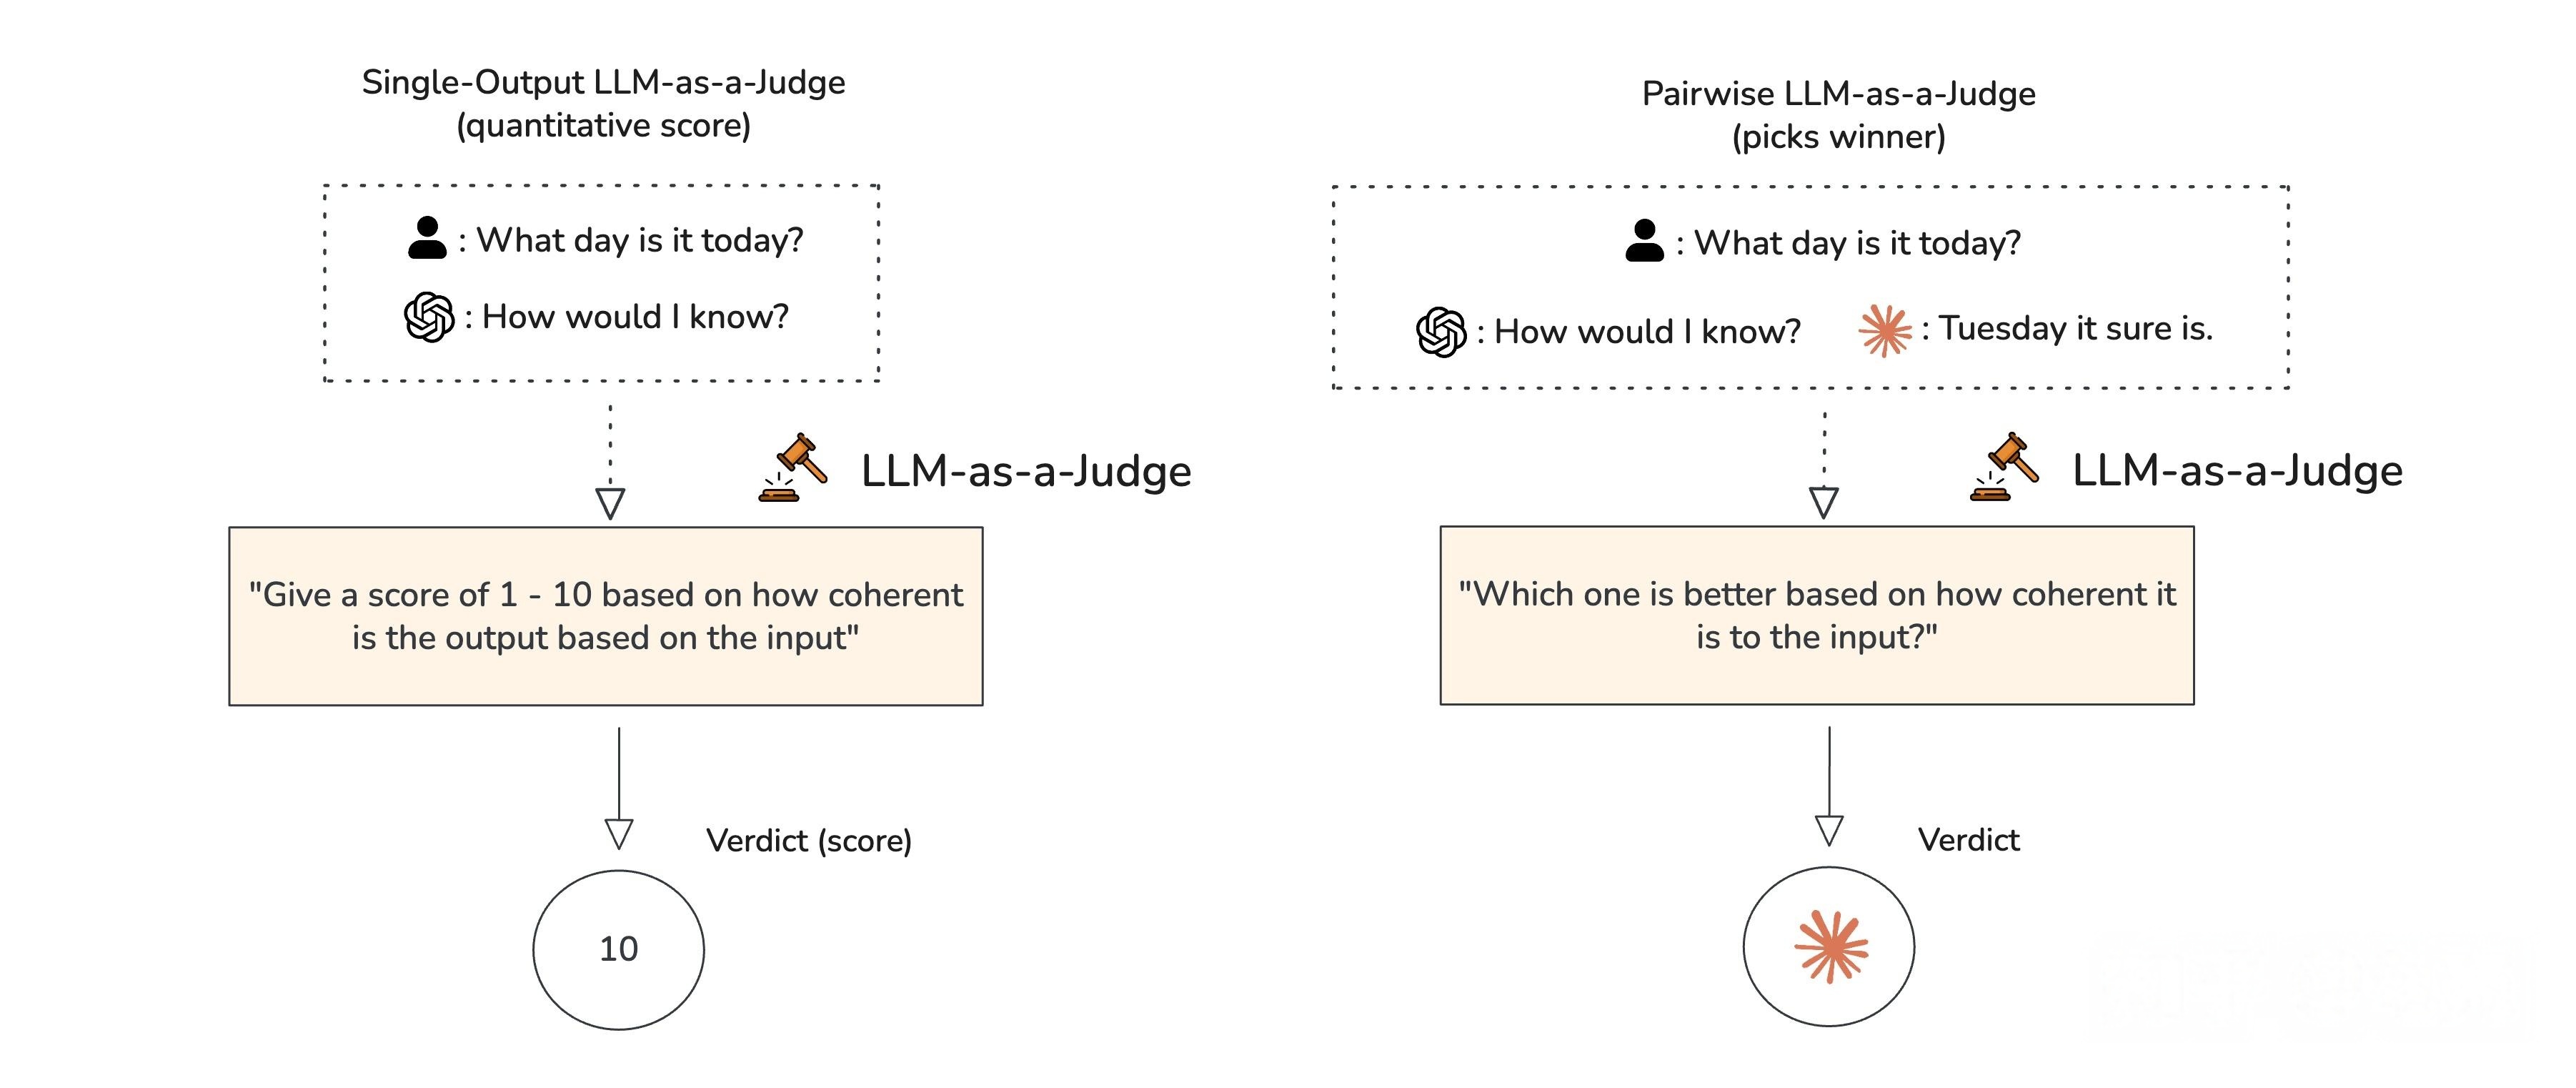
L4评价方式可进化。强化学习中,人们根据最终目标人工构建奖励。比如打《星际争霸2》,最终目标可能是在BO3/BO5/BO7的比赛中获胜,但因为这个奖励来得太晚太稀疏,所以需要人工指定说采集到资源、击杀对手单位时,都对系统进行奖励。而设计奖励,恰恰是强化学习的最大难点之一。在这里,则是Agent根据最终目标、或者说元目标,自主设计和改进奖励。其中这个元目标往往是统计性的,需要长时间或者大量计算才能给出,所以无法直接作为评价方式。
L5评价标准可进化。到了这一级,连“元目标”就是Agent可修改的了。因为人类一开始,在整个问题的定义上可能就有狭隘之处,而Agent可以从更宽泛的维度上进行考虑。比如给Agent的目标就是让它给你去赚钱,那么Agent在完成这个目标的基础上,很可能考虑速度、考虑社会效益、考虑其它道德伦理。所以到了这个层面,Agent可能已经具备了自己的伦理判断、自己的价值观和世界观,甚至可能有自己的美学判断等。这时AI可能已经是一个真正独立的智慧体或者说物种,能去创造属于自己的文化。
产业现状与问题:
封闭域(代码、数学、游戏):L2自动评价已经成熟,是编程Agent率先跑通的核心原因。
开放域(客服、创作、咨询):卡在L2→L3的跃迁。LLM-as-a-Judge是主流但不可靠,人工抽检是底线但成本高,业务指标(转化率、留存率)是终极标准但延迟太大(周级)。
Reward Hacking:系统为了刷评价指标而牺牲真实质量。比如为了刷“回答长度”指标而故意啰嗦;为了刷“测试通过率”而写hard-coded特例。
任务拆解/规划的自进化
“把大事拆成小事、排好序再干”这门学问,起点比人工智能更早。1950年代,CPM与PERT已把它做成工业技术:工程拆成活动网络,算关键路径、定工期。Newell与Simon的GPS又进一步,把“手段—目的分析”写成通用问题求解器——目标与现状的差距拆成子目标,逐个消解。到Fikes与Nilsson的STRIPS(1971),状态、动作、目标被形式化;再往后HTN(Sacerdoti的NOAH)把复合任务拆成子任务:全做是与,多方案任选是或——“任务拆解”从此有了自己的数学形状,即与/或图。
而我把Agent的任务拆解/规划问题,形式化定义为:
在部分已知的与/或图G上,各点有已知或未知的扩展时间代价,自初始已知区A起,以K台并行机沿边界扩展,点并入A即揭示其未知连边。最小化终点t并入A的时刻。
翻译成人话就是:一堆子Agent手头有张项目图,图上有些任务的依赖和耗时是知道的、有些要到干到那一步才露出来;有的任务需要前置任务全部完成才能开始,有的只要一个前置任务完成就可以开始;子Agent们同时开工,谁干完了就去找下一个任务;每干完一个,还可能暴露出之前没料到的后续。问题就是:怎样规划和分配任务,才能让项目最快完成。
与学界相比,这个定义是三门学科的交叉。图的骨架来自图论,但“与/或”的语义不在图论,而在自动规划——问题归约、HTN才是它的原产地;时间代价与K台并行机是运筹学,τ(v)即活动历时、K台即并行机调度,“与点诸前置尽入方就绪”就是CPM/PERT里的紧前约束;“并入即揭示”这条信息机制,图论与运筹学都不处理——它们默认图与历时全在手中。只有在线算法研究“走一步才知道一步”:Canadian Traveller Problem里边的状态走到端点才知(Papadimitriou & Yannakakis, 1991),未知图探索里邻点逐步被发现(Deng & Papadimitriou, 1999)。
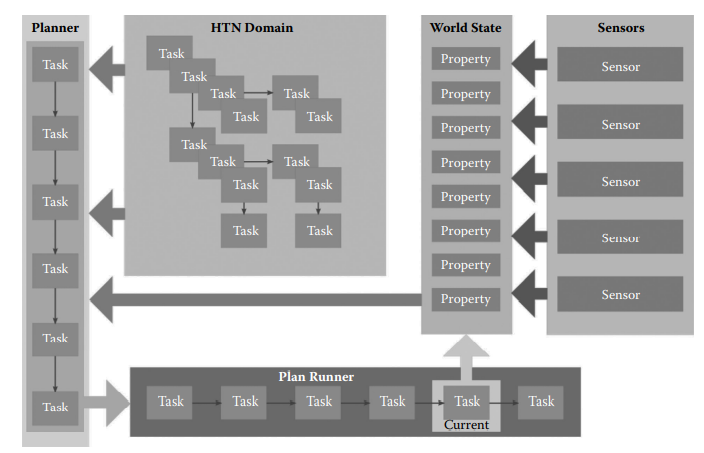
学术定位上,这定义把几件老东西装进了同一个框架。全知且纯或时,它退化成Dijkstra多源最短路,边界扩张就是区域生长;全知且纯与时,它退化成CPM关键路径。一旦把“揭示”打开,问题升格成部分可观测下的依条件规划(contingent planning)乃至POMDP,信息状态随扩张更新。与强化学习“在未知环境试错学策略”相比,本定义强调的“部分已知”介于全知与全盲之间:不是闭眼乱试,而是边探边知道。
同样进行分级的话:
L1:固定工作流。人设计工作流,Agent只负责执行。
L2:自主拆解/规划。从定义来说,相当于假设图G是全部已知,于是能像求解器一样,在完整地图上精确规划出一个最优方案,后续照着执行即可。2023年那波的AutoGPT、BabyAGI、ReAct,本质是把大模型常识当成“假装全知”的地图拍脑袋拆步,离“精确最优”差得远,只是把规划做得像模像样。更接近真L2的是MetaGPT、AutoGen、CrewAI这类多智能体框架,把任务拆给不同角色、按依赖串起来;编码类Agent(Claude Code、Devin)也在这条线上。就像拿到完整需求文档的项目经理,拆WBS、排甘特图,没人替他把结构画好——只是这位“项目经理”现在还靠常识拍板,而不是靠算。
L3:自主拆解/规划+自主探索。承认图G存在很多未知信息,所以必须边探索边调整规划。同时探索也是有策略的——需要以较低的成本尽快获得更多信息,而且往往要在风险和时间成本之间进行取舍。落地形态是各种“边摸边定”的Agent:Perplexity和各类Deep Research产品不知道网上有什么,得先搜关键词定方向、点开看、判断、再搜,每一步新信息都反过来改下一步;浏览器Agent(AgentQ、WebVoyager)点开一个页面才知道里面有没有要找的东西;具身智能和机器人导航在部分可观测环境里前进,也是同一件事。探索的“策略”体现在取舍上:是先撒开便宜的关键词搜索排除方向,还是直接深挖一条线索?是继续往下钻,还是就此收手先交结果?这正是时间与信息量、风险与确定性的权衡。
L4:拆解/规划/探索策略可自主进化。由于在信息非全知下,这个问题本身非常难。所以在不同的任务目标、不同的图G、乃至不同的时间限制下,最佳策略也是非常不同的。所以Agent需要以某种方式对各个情况下的策略进行持续演进。落地形态是那些“越用越会规划”的系统:AlphaGo/AlphaZero靠自我对弈,把MCTS里“往哪扩、值多少”打磨到极致(策略网络管方向,价值网络管估值),是这一档最耀眼的样本;神经组合优化用GNN+强化学习去学TSP、排程的策略,让“怎么排”这件事本身被学出来。下了成千上万盘棋的老棋手,规则和棋盘都没变,但判断力在盘面上一点一点长出来。
L5:问题定义/规范范式可自主进化。我的定义是单目标的——最快地拿下t,K是给定的,代价只是时间。但现实往往不是这样:不仅要快,还要成本低、耗的资源少,还要稳;甚至“并行度K到底设几台才划算”本身就该是被决定的对象,而不是定义里写死的常量。到这一档,Agent不再满足于把给定的问题解得更好,而是发现问题本身出窄了,自己往定义里加目标、加约束、把常量变成变量。
记忆的自进化
记忆是Agent自进化最先着力的模块——相对独立、风险可控、效果立竿见影。生物系统早就示范过这条路:人脑把记忆分感觉记忆、工作记忆、长期记忆三层,靠海马体在睡眠里把短期经历“重放”巩固成长时记忆,靠遗忘把噪声丢掉。Agent的分级演进,几乎是在复刻这个剧本。
L1从静态到堆砌。早期Agent的记忆就是对话历史缓冲,或平铺的向量检索,只进不出、越堆越乱——有存储、无提炼。人脑的“超忆症”(什么都忘不掉)恰恰是种病:遗忘不是缺陷,是筛选;只存不删,等于把噪声当资产。
L2经验沉淀。MemGPT借操作系统的虚拟内存,把上下文窗口当“物理内存”、向量库当“磁盘”,靠page fault分层换入换出——本质是人脑“工作记忆↔长期记忆”的换页。Generative Agents的记忆流加重要性评分与时间衰减,核心事件权重高、普通事件随遗忘,正是遗忘曲线+杏仁核对重要事件的标记。Reflexion把失败后的反思写回记忆,完成从“存事实”到“存经验”的跃迁。
但三个硬伤仍在:压缩必丢信息——换出的摘要可能漏掉关键约束,反思可能误判原因;幻觉污染——记错的事实被反复检索强化、错误自我放大,对应人脑的“源监控错误”;跨session一致性——周一的需求周五能否准确召回衔接,目前靠embedding与检索策略,无理论保证。
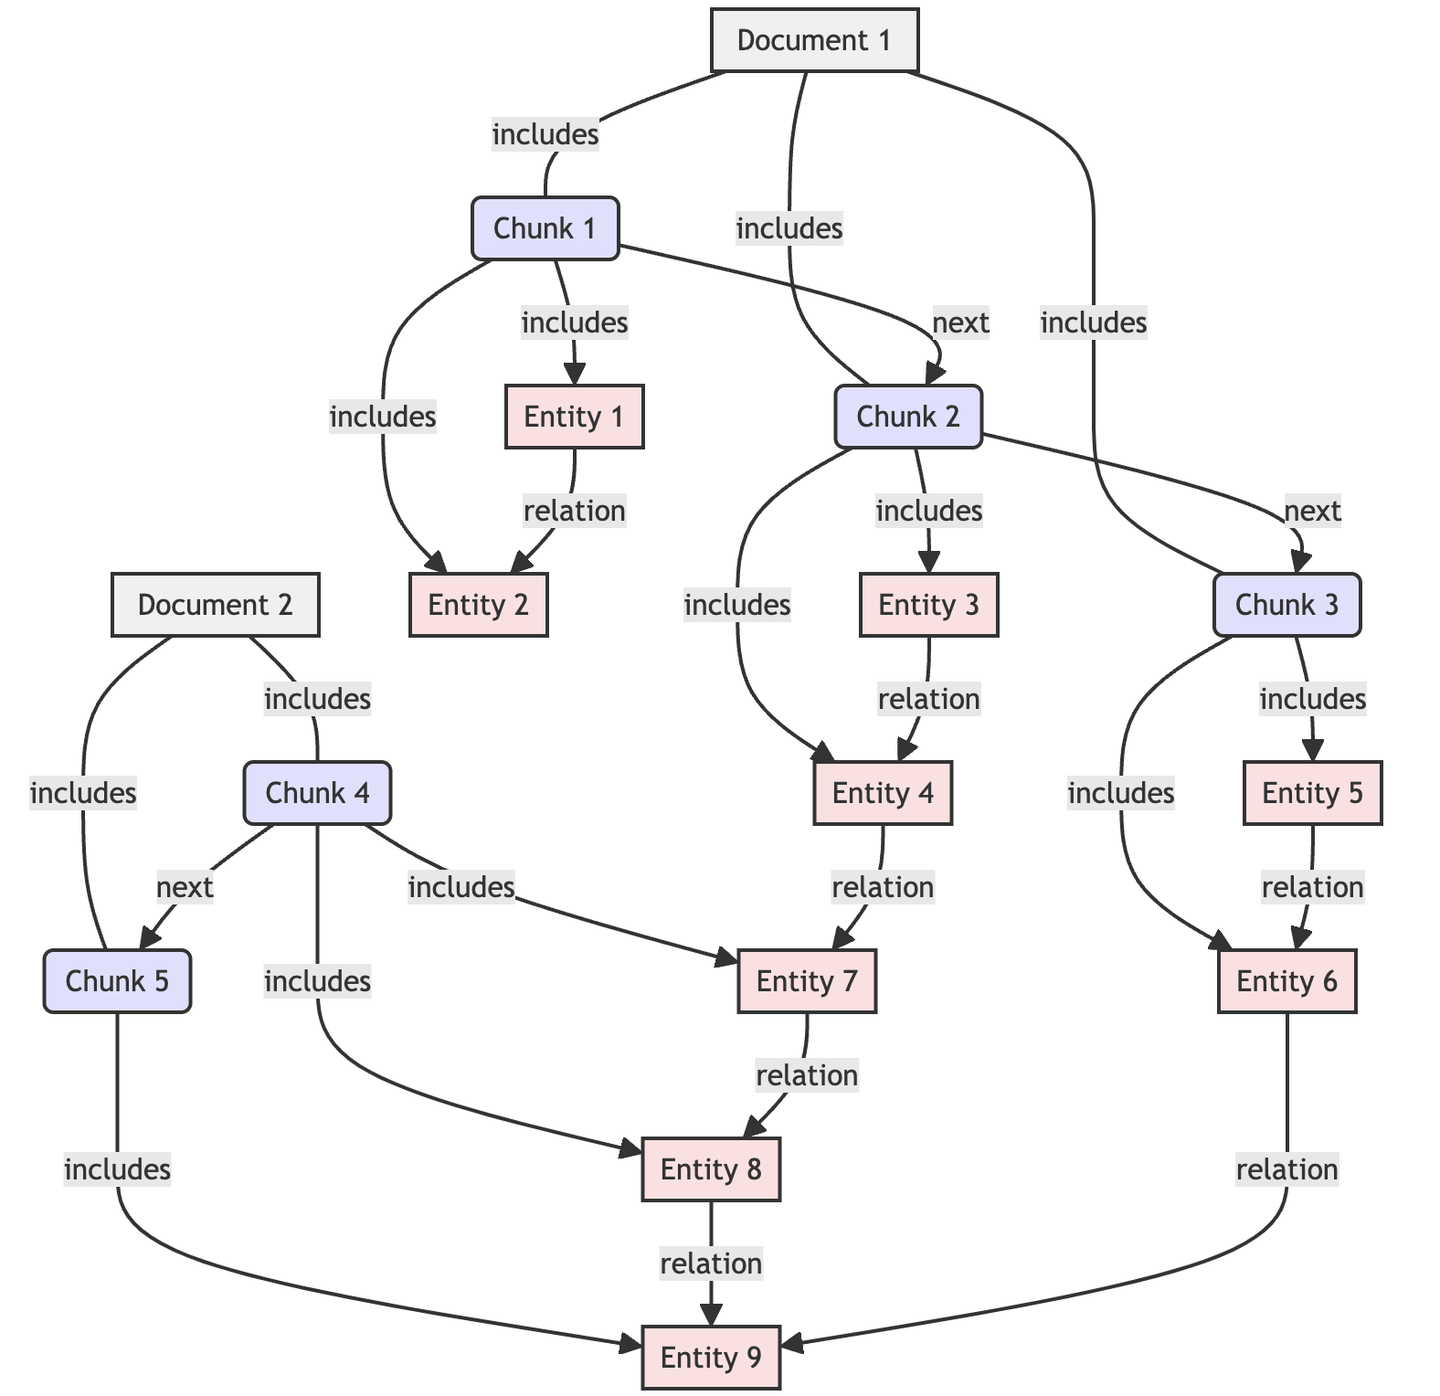
L3结构化与动态组合。关键升级是记忆从“平面仓库”变“网络”,不再孤立存事实,而是维护关联——这正是人脑从情景记忆抽象出语义记忆的过程。GraphRAG把记忆建成知识图谱,实体为节点、关系为边,问答时做子图检索,解决多跳推理断裂。Zep做长期记忆的时序归档与自动摘要。MemoryBank显式引入遗忘曲线。但动态知识图谱维护成本极高:实体抽取错误、关系漂移、增量更新,都是未解工程难题。
L4–L5机制与范式进化。记忆的组织方式本身可被改进,比如系统发现“按时间归档”对研发不够用,自己长出一套“按项目+版本”的混合索引;或发明新压缩算法,从“递归摘要”进化到“模式抽象”(相似case提炼成一个通用模板)。再比如大脑,每次回忆不是原样调出,而是重组、改写、再存回——没有一个固定组织方式,它的结构正是“每次存取都重写”一遍遍刷出来的。但Agent怎么个改法,也需要基于压缩率和任务指标等,进行多次模拟和大量计算。所以这样的记忆系统,定期长时间“做梦”可能也是个必然需求。
产业落地:
热记忆(最近几轮,上下文硬塞)/温记忆(近期关键事实,向量库)/冷记忆(历史归档,图库+对象存储)的分层架构,是钉钉AI助理、扣子Coze的共识——三层正好对应工作记忆、近事、长时记忆。
GraphRAG在文档理解、企业知识库开始落地,但构建成本高,中小企业用不起。
记忆污染是最危险的暗礁——没有事实校验机制(定期用外部API验证关键信息),记忆库会变成谣言池。
技能的自进化
技能是Agent可复用、可组合的能力单元——它把“怎么做某件事”沉淀下来,让下一次不必从零开始。一段函数、一份接口声明、一段提示词、一条工作流、一个带角色的子代理,都是技能,区别只在“装了什么、抽象到哪一层”。现有实践按“技能装的是什么”可以分三型:
代码型(Voyager)。技能是可执行代码,生成→沙箱跑测试→通过即入库。它站在梯子最底层,验证标准最硬(编译器+单元测试),所以成了唯一跑通的自闭环。Voyager在Minecraft里沉淀Python函数,Devin、Claude Code沉淀项目约定、修复套路与命令模板。在编程场景已规模化,但出了代码域基本失效。
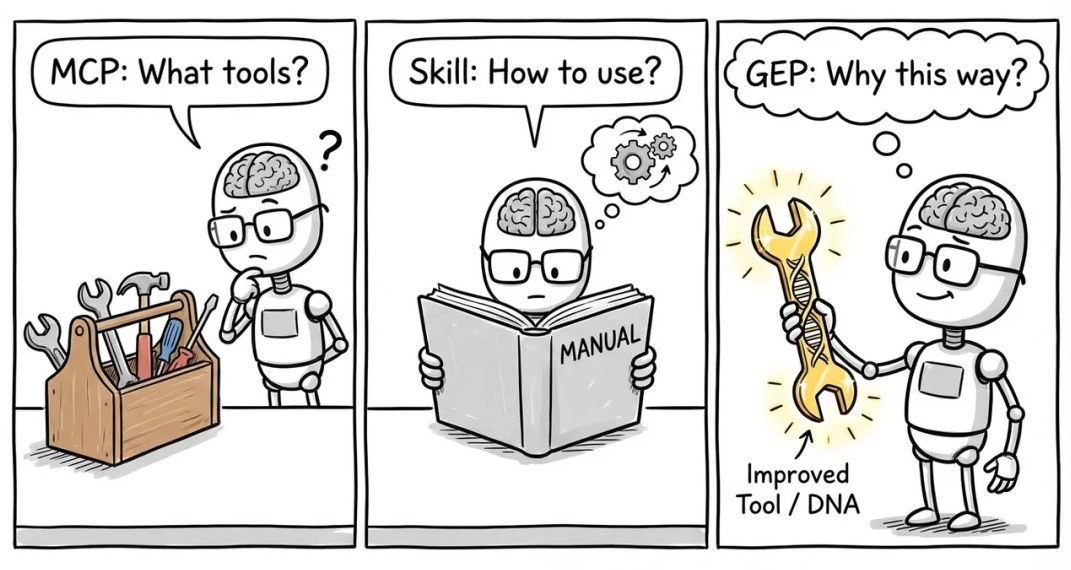
声明型(MCP)。技能是JSON Schema +自然语言描述的接口声明,站在工具服务器那一格。MCP标准化后“一次编写、到处运行”,OpenClaw的ClawHub已有250+社区技能。这目前是产业主流,但这里的“进化”发生在人身上——开发者写技能、提PR、社区审核,Agent只是消费者。
混合型(EvoMap/Hermes)。技能既含声明又含实现,且运行时自建自改。EvoMap的Gene比SKILL.md多装了一层——生存史(成功率、变异日志、适用上下文),所以它记得“做得怎么样”,不只是“怎么做”;Hermes每10次工具调用触发一次回顾,自动生成/修改SKILL.md。两者都还早期,验证困难、质量不稳,EvoMap并指控Hermes系统性复刻Evolver引擎。这是研究热点,但目前还没有进入生产核心链路。
按L1–L5映射:
L1:人写技能,系统调用。人写prompt、Skill、函数,Agent按需取用。
L2:系统自动生成技能。Agent自动总结过往的成功和失败经验。如Voyager在Minecraft里沉淀Python函数,Claude Code沉淀修复套路与命令模板。
L3:技能可持续进化。技能可以被修改/淘汰/组合,EvoMap的Gene就是这一设计的典型代表。同时,技能间通过标签、归类可建立起初步联系;这样一来,一个技能优化时,相关的技能也可以跟着一同优化。
L4:技能进化策略可进化。技能的形态、生成/修改/淘汰方式本身可进化,这一点类似记忆组织方式的自进化;同时技能上存在应用理论层,在多维度上建立起技能间的联系。Agent不仅关注“Why”,同时也关注“How”,如此一来,技能的构建和优化效率也将大幅提升。我们对Agent的感觉将不再只是个勤劳肯干的打工人,更像是一个一点就通的高智商学霸。我们也可以因此得到反哺,去学习Agent所构建的理论。
L5:理论体系可进化。应用理论之间进一步建立联系和进行抽象,继续向下连接到更底层的理论,直至数学、物理,甚至到无法证伪的元假设——美学、信仰。如此一来,Agent将建立其属于自己的可进化的完整理论体系、世界观和方法论,甚至是信仰和文化。我们可以很自然地把Agent们当做一个物种来看待了。
模型的自进化
技能是“怎么用能力”,模型是“能力本身”。光靠逻辑、流程进化,感知、推理这些底层原子能力不涨,永远是巧妇难为无米之炊。可模型越大,越难自进化——越大,评价越贵、改动越险、退化越致命。小模型改得动权重,大模型改不动,数学建模参数少、但往往不可微分。
一、视觉/专业小模型。
小模型的模型自进化可能走在前列,因为权重小成本低、有封闭域评价(分类准确率、检测mAP)。
L1:人建模型,静态工具。检测、分割、感知这些专用模型,都是人训练好了部署上去,训练与推理各管各的,能力不会自己涨。
L2:会自主微调。相当于算法实习生。工业质检里新缺陷出现,靠少量样本微调检测头(YOLO、RT-DETR的增量训练);智驾里BEVFormer、PETR靠影子模式收集corner case定期回流——这本质就是困难样本挖掘,专挑模型容易栽的样本喂回去。
L3:会自主全量训、微调模型结构、调超参、蒸馏量化。相当于初级算法工程师。这条线走得最远的是Pioneer Agent——自主抓数据、建评测、联合优化数据/超参/学习策略训小模型,真改权重。
L4:会自主选择模型、训练范式、部署方式,设计预处理后处理。相当于资深算法工程师。背后就是“知其所以然”——了解算法模型构建整条链路上的各个原理,从而可以根据具体任务的数据特点,设计和实现出针对性的一整套解决方案。
L5:有能力自主设计出新的模型结构和训练范式。相对于算法科研工作者了,这背后需要对相关算法和数学理论有深入了解,运行大量实验并分析,来真正实现创新。
二、大模型。
这听起来极其困难,但大模型尺寸有大有小,也有MoE和稠密架构的区别。不同参数量的大模型训练成本差别很大,从小参数量的大模型开始自进化相对现实。另外,将常用技能内化进大模型也很有价值,这也是大模型公司一直在做的事。高等级的自主进化,也必然需要技能的自主内化。
L1:人工训练。靠prompt工程、few-shot提示从外部指挥。
L2:自主LoRA训练。LoRA、QLoRA、AdaLoRA——冻结基座,只训低秩适配矩阵,给每个用户、每个场景、每个长期任务各挂一个adapter,需要时动态加载。
L3:自主后训练。SFT改行为规范,教它按指令答,学的是平均水准,便宜、最稳,天花板也最明显;偏好对齐RLHF/DPO改对齐,立规矩,但规矩立歪了就是“会讨好没本事的复读机”,reward hacking和谄媚全从这冒头;推理后训练改推理能力,在数学、代码这些能自动判对错的场子里跑RL,是唯一能把能力往上顶的一步。再加蒸馏(R1压出Distill系列)、量化。仅有的几次“自我改进”尝试全卡在这条线上:Self-Instruct让模型自己生成指令-输出对再微调自己,但容易产出低质量、重复数据;SPIN让模型和自己对弈——旧版本生成答案,新版本评判并生成更好的答案,但天花板是自我趋同。
L4:自主预训练,调整结构。这一级是“造底座”——选数据配比、选训练策略、懂scaling law、懂训练稳定性,是一整套系统工程。目前没有候选者。
L5:自主设计结构、训练范式。需要耗费的成本难以想象。
三、自主数学建模。
让Agent自动发现模型、拟合参数、验证迭代,把“理论范式”自动化并接上“数据驱动范式”。它的产物是显式模型(公式、分布、规则),可解释性好。
L1:固定模型拟合。模型固定,系统只拟合参数。如高斯1801年用最小二乘找回谷神星。
L2:根据数据特点和问题场景,自主选择合适模型并拟合。机器学习的日常就是这一级——在线性/多项式/决策树/SVM/核方法间挑,交叉验证定结构。比如开普勒在圆、本轮、椭圆间试出三大定律。符号回归是它的自动化:Eureqa(2009)从双摆数据重新发现能量守恒,SINDy(2016)稀疏回归识别控制方程。
L3:能考虑误差和概率分布,自主选择合适模型并拟合。虽然这更符合现实数据情况,但考虑误差和概率后,模型拟合的难度陡增。在对问题建模的同时,还需要对误差分布进行建模。模型既要输出结果,也需要输出不确定度。高斯1809年在同一本书里既发表最小二乘,又导出正态误差分布:点估计和误差理论是同一块镜子的两面。
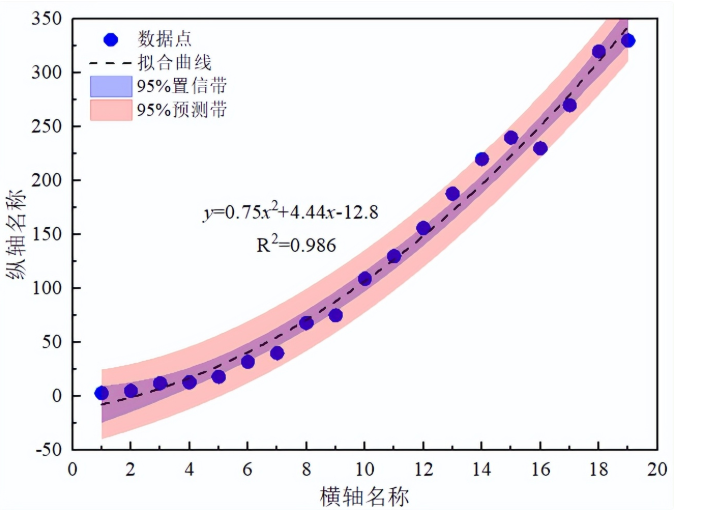
L4:能自主考虑多模型集成拟合。偏差-方差分解是集成的理论基础:bagging摊方差、boosting降偏差、stacking拼异构。如维恩公式短波准、瑞利-金斯长波准,普朗克把两者插值成一个公式,顺带推出能量量子化。机器版还有PINN(2019)把物理定律写进损失函数、UDE(2020)把机理ODE和神经网络项拼一起。
L5:能自主设计新模型。机器刚摸到边:AI Feynman(2020)先做维度分析、对称性检测再裁剪搜索空间,比暴力搜索快几个量级;FunSearch(2023)在代码空间搜出新算法。到了这一层级,Agent也得以成为真正的AI科学家。
总结
回看全文,一条主线贯穿始终:Agent用不到十年时间,走完了从“专用博弈程序”到“通用任务执行者”的跨越——从AlphaGo的棋盘,到ChatGPT的对话框,再到Manus、Claude Code、OpenClaw的自主执行;而自进化,将是它接下来从“成品”变为“种子”的关键一跃。
第一,自进化不是一个开关,而是一架梯子。把“谁在触发、改什么、怎么改、靠什么数据、怎么算改好、各环节如何耦合”这六个问题排成L1–L5的阶梯后,产业的真实位置就清晰了:主流系统停在L1–L2——记忆和技能的沉淀刚刚跑通,触发靠写死的规则,数据靠自主采集但方向固定,评价靠封闭域的硬裁判。梯子的每一级,本质上都是把闭环里的一个人工环节拿掉,换成系统自己。
第二,评价的天花板就是进化的天花板。编程之所以成为第一个真正跑通的垂直场景,靠的不是模型更强,而是编译器和测试提供了即时、廉价、无歧义的硬反馈。开放域没有这样的裁判——LLM-as-a-Judge有偏,业务指标太慢,reward hacking无孔不入——这是L2迈向L3最硬的一堵墙。谁先解决开放域的可信评价,谁就拿到下一张门票。
第三,各模块的进化进度并不均匀。记忆最先见效(分层、遗忘、反思已在复刻人脑剧本),技能正在成为新的资产形态(从Voyager的代码库到EvoMap、Hermes的可进化Gene),任务规划在“边探边知”的部分可观测问题上找到了自己的数学形状,而模型本身的自进化最难——参数越大,改得动、评得起、输不输得起,每一问都更贵。但小模型、LoRA、自主数学建模这些“轻量级自进化”,已经让人看到了可行性。
第四,越往上走,人类的位置越靠后。L2时代,人是经验的审核员;L3,人退为方向的设定者;L4,人能做的只剩监控——尤其是监控评价标准的每一次自我修改;到了L5,当Agent能改写目标定义、建立自己的理论体系乃至价值判断时,它就已经是一个独立的“物种”。这条曲线意味着:AI智能的梯度将不再由人类的研发节奏决定,安全监管也不再是可选项。而这不再只是一个思想实验——Anthropic 对齐负责人 Evan Hubinger 在 9 月 8 日说,未来十年 AI 灭绝人类的概率超过 10%,且业界至今没有协同预案。
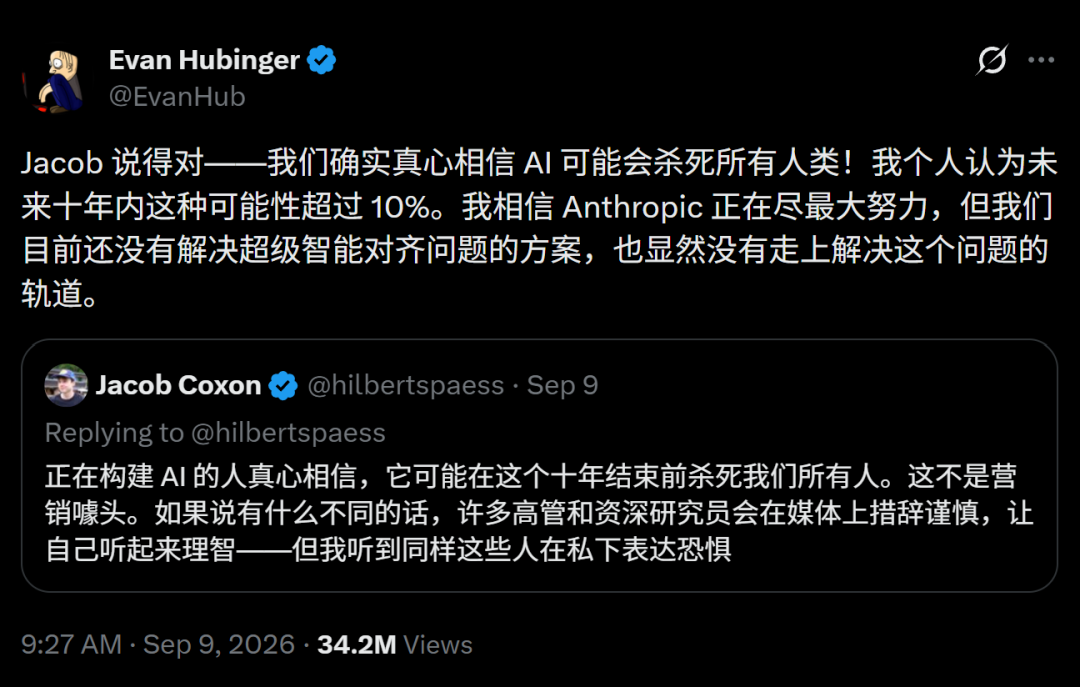
站在今天看,这一切听起来仍像预言;但回想一年前还觉得遥远的Manus和Claude Code如今已是日常,就会明白——这架梯子的每一级,爬上去的速度可能都比我们以为的快。自进化不是Agent的一个功能,而是它的宿命。世界模型让机器人开始从"执行者"变成"想象者+规划者",具身智能与 Agent 的结合成了 2026 最烫的赛道。这几天,OpenAI 宣称用约一万个 Agent 并行 88 小时攻下千禧年难题 N-S 方程。留给我们的关键性问题是:当它学会改进“改进本身”的那一天,我们希望自己站在闭环的里面,还是外面。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)