现场去体验了觅蜂的Ego和UMI产品后,发现最关键的不是硬件。
今天,我们去了觅蜂2w套 MEgo 下线的现场。
一方面,我们想亲手看看 Ego 这类设备戴起来、跑起来到底怎么样,UMI 形态的产品能不能把人的动作顺滑地采下来;另一方面,我们也想看下这两万套终端出去之后,数据的回流和infra现在搭建的如何了。
这次见到了很多熟人,姚卯青、茂青(觅蜂的VP)、还有力哥(觅蜂技术负责人)。
除了设备数量,这家成立刚半年的公司,还累计生产了超过 100 万小时真实世界数据。
虽然具身圈里,各家都在扩大数据规模。
但半年做了这么快,推进速度依然不多见。
01 姚卯青说,物理AI可能需要的数据在亿级
行业正在形成一个共识:大模型在互联网里吃到了海量文本和图像,机器人却没有一座可以随手取用的「物理世界互联网」。每一次抓取、拧转、推拉和接触都要重新采集;场景、物体或机器人本体一变,数据分布也会跟着变化。
觅蜂董事长姚卯青在现场判断,物理 AI 所需数据很可能以千万小时、甚至上亿小时计。
问题也随之而来:这么多数据从哪里来?
觅蜂给出的路径,是先把采集设备铺进真实世界,再用一套完整的数据管线,把人的操作经验转成机器可以学习的样本。
姚卯青这次把它比作物理 AI 的「数据电网」。
这个比喻挺有意思,场景和数采员织起来的网。
02 他们的Gripper和Ego设备
目前行业里最常见的无本体数采,大致有两类:Ego 和 UMI。
觅蜂自研的两套设备,正好沿着这两条路线展开:MEgo View 对应 Ego,MEgo Gripper 对应 UMI。一个负责把真实场景的规模化展开,一个负责让采集动作更接近机器人。
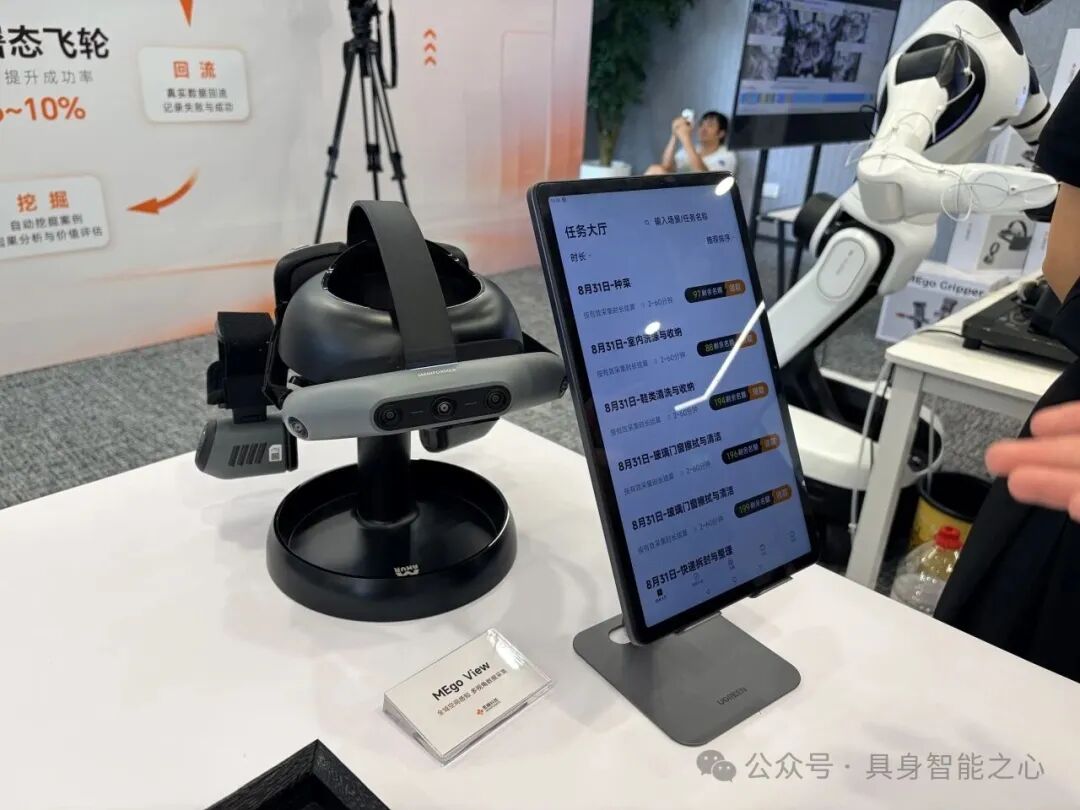
我们现场试戴了MEgo View:一个头环+2个腕部设备组成,头环有3个相机,两个腕部则是各一个相机,负责采集手与物体交互/动作的细节。
两个视角合在一起,能够减少开放环境中的遮挡,也让模型知道:这只手是在什么场景里、为了什么任务、对哪个物体做出了动作。
还有MEgo Gripper。
它沿用了 UMI 的夹爪形态,并在此基础上加入触觉采集。
我们现场测试了下(三个相机,中间是鱼眼),直接拿着夹爪抓取杯子,设备会同步记录夹爪动作、末端轨迹与接触过程。人手的操作经验,也因此更早一步被转成接近机器人末端的数据形态。
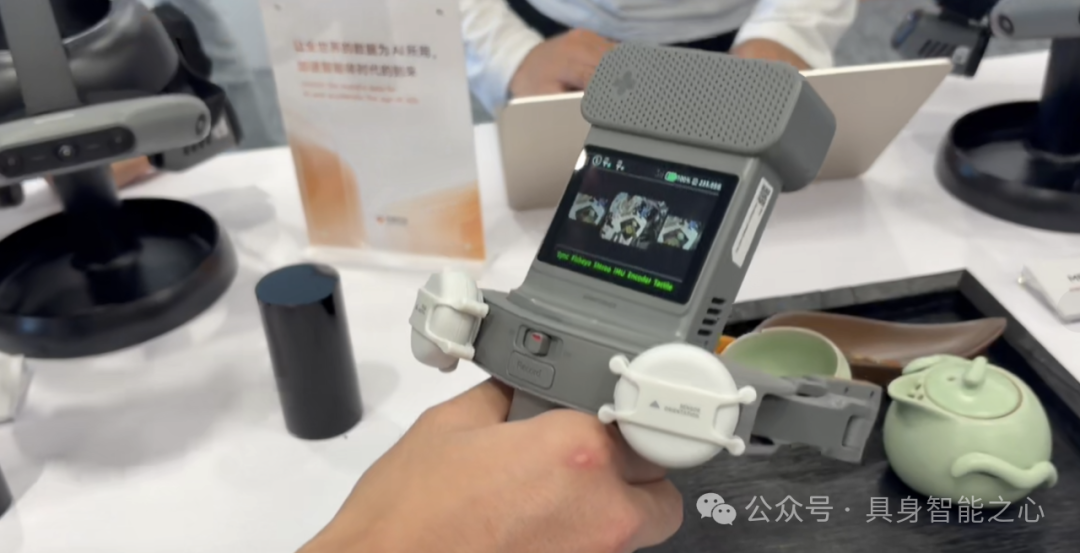
现场试了下他们的UMI设备
茂青在现场用四个词概括这套设备的设计思路:以人为中心、随行、轻量、无界。
在产品设计上,他们就是主打无线、尽量减少束缚,以及支持快速更换电池。
这些听起来像体验问题,却会直接影响采集者愿意戴多久、设备能进入多少种环境。
只有设备得先跟着人进入真实世界,后面的数据网络才铺得开。
03 这些设备在真实场景是怎么用的?模态是怎么样的?
那真的到场景现场,设备怎么用的?
比如UMI和Ego类产品。
觅峰给出了一个参考,这 100 万小时目前由三部分组成:纯Ego数据占约 50 万小时,Ego+Wrist 腕部数据约 35 万小时,Ego+UMI 夹爪数据约 15 万小时。
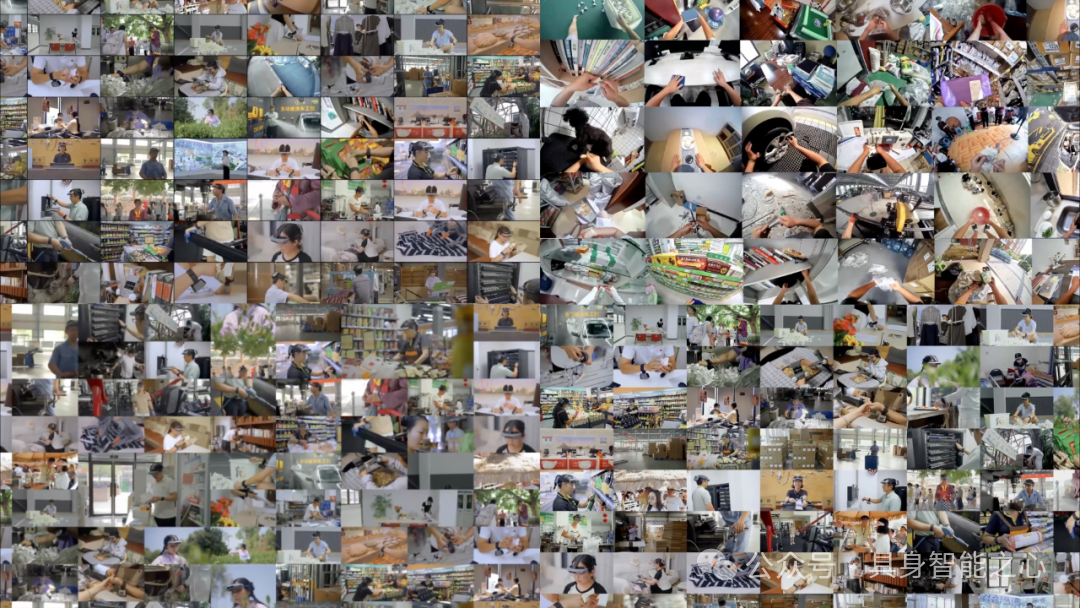
三种形态,一层层往机器人真实任务靠近。Ego 裸手负责把场景铺开,Ego+Wrist 补上腕部视角与连续轨迹,Ego+UMI 再把动作拉近机器人夹爪,并加入触觉信息。采集粒度越往后越细,数据也越接近机器人真正执行任务时的状态。
形态变了,但还有一个关键问题:多模态能不能对齐。
整套 MEgo 体系会采集 RGB、Depth、IMU、触觉和音频等信息。
按照觅蜂披露,各通道通过硬件级同步实现亚毫秒级对齐。
而要让这样的数据持续产生,设备就得离开实验室。
茂青说,目前两万套设备已经进入家庭、办公、零售、生产、餐饮等真实环境,采集的数据都是真实的。
设备规模有了,那后面的问题就是:采回来的数据,究竟够不够真实、够不够多样?
04 还有任务派发平台
现场还看到了他们正在内测中的「觅蜂派」App。
前端面对的是分散在不同场景里的采集人员:今天采什么任务、用哪一种设备、需要完成多少次,都要在这里被拆成可以执行的工单。
我们和现场的产品经理开玩笑,也许后面这个会像美团 or 滴滴这种方式。
让有兴趣、有需要的人都参与进来。
在具身里,这个平台既能向采集人员分发具体任务,也能回看采集与治理进度。
这个环节没有 Gripper 和多目相机那么抢眼,却决定了两万套设备能不能真正连成一张网络。
规模一上来,任务定义、人员调度、数据回传和质量状态便很难继续靠微信群和表格维持。
05 后面给模型的数据分布应该是怎么样的?
这个问题,其实是在前端和平台问题解决之后,需要重点关注的。
因为场景数据采集后,就到模型那边了。模型能否泛化,全靠这些。
按照觅蜂披露,这 100 万小时数据中,82% 来自居住、办公、零售、生产、仓储、餐饮、文娱休闲、交通出行八类高频场景;其余数据分布在公共服务、物流、医疗、教育、养老、文旅、汽车服务、农业生产等 14 类长尾场景。
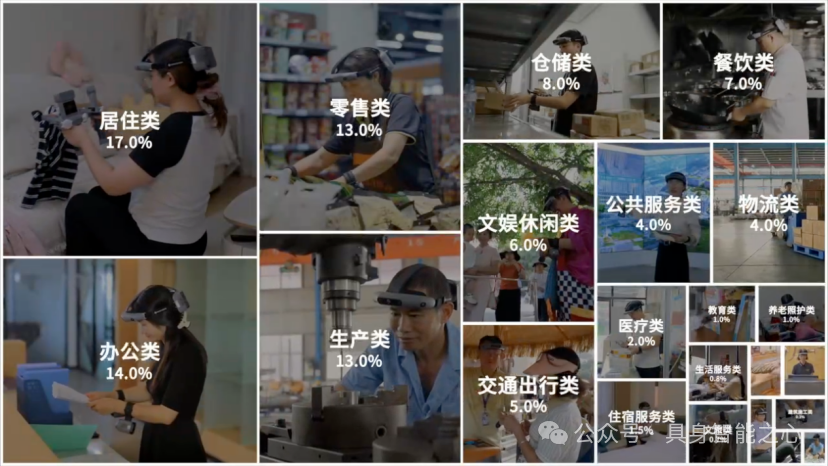
整个数据集覆盖 22 大类场景、1 万余个真实环境、5 万余类物体和 500 余种细分任务。
高频场景提供通用动作的密度,长尾场景补充任务分布的宽度。真实采集只是第一道门槛;能否覆盖足够多的物体、动作、遮挡和失败情况,才决定模型最终能从中学到多少。
06 数据是怎么保证可以被模型消费掉?
任何一个真正做过具身数据的人都知道,数据「采下来」和「能训练」之间,还有很长一段距离。
麻烦恰恰来自真实世界。
人的手会高速运动,会被物体遮挡,会和别人的手交叉,也可能戴着厚手套。光照在变,视角在变,任务进度也不会像实验室脚本那样整整齐齐。采集规模越大,脏数据、时序漂移和标注误差也会被同步放大。
所以在现场,我们一直在关注 MEgo Engine。
数据技术负责人刘力把它概括为一套数据全链路技术体系,底层是「RGB-D + X」:RGB 与深度提供视觉和空间信息,X 则按任务继续叠加 IMU、触觉、音频等模态。
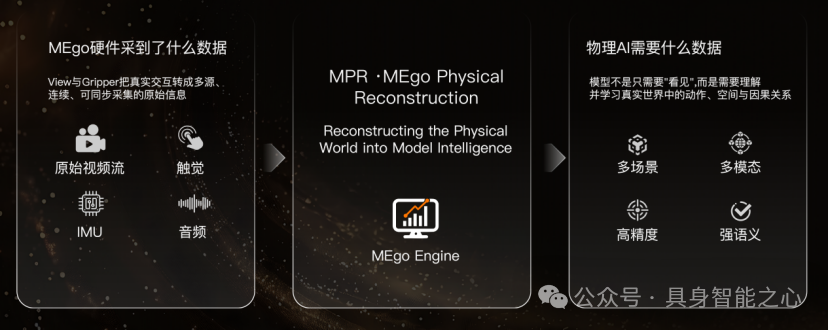
往后,MEgo Engine 覆盖数据处理、感知、标注和质量评估,并通过位姿重建与动作映射,把手部、身体、头部、机器人末端和环境信息转成统一的空间数据。而任务派发端与运维平台,则负责把设备、采集人员、任务和数据回流串起来。
从这个角度看,采集硬件只是入口。觅蜂交付的,是一条从任务下发、数据回流、自动治理到最终交付的流水线。
还有一个很有意思的是他们的HandPose 高精度手部重建技术。
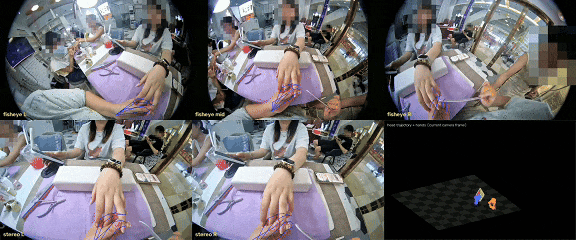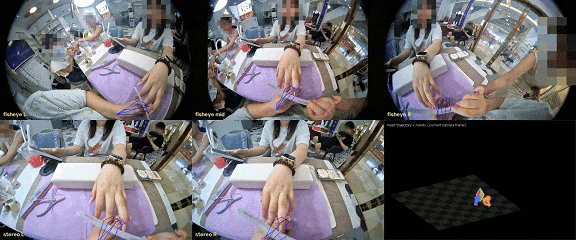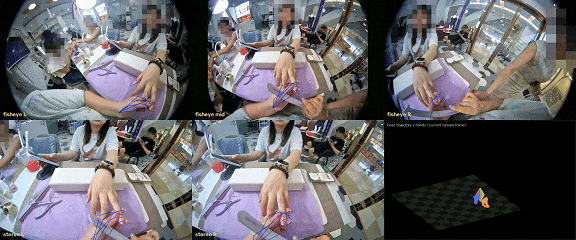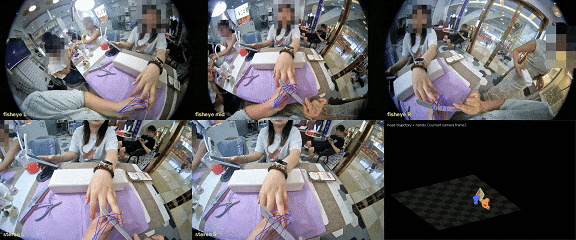
这套方案把五目全景感知、鲁棒手部追踪、三目深度融合、参数化手部重建和轨迹恢复串在一起,用来处理开放环境中的遮挡、多人交互与快速运动。
按照觅蜂现场披露的测试结果,其七项核心指标达到 SOTA;PA-MPJPE 重建误差较测试中的次优方案降低 62%,Jitter 帧间抖动降低 93%。
这组指标展示的是算法结果,更能说明问题的还是它要面对的具体场景。
现场还有几个有意思的例子。
在美甲场景里,系统需要区分采集者与服务对象两双不断交互的手;制作奶茶时,手部会被杯具大面积遮挡。觅蜂称,在手部可见率低于 30% 的情况下,系统仍能完成亚厘米级三维重建,并保持零跟踪丢失。给宠物洗护时,快速运动造成的模糊和泡沫引起的外观变化会同时出现;到了模具维修,操作者戴着厚工业手套,系统依然要估计稳定的手部姿态。
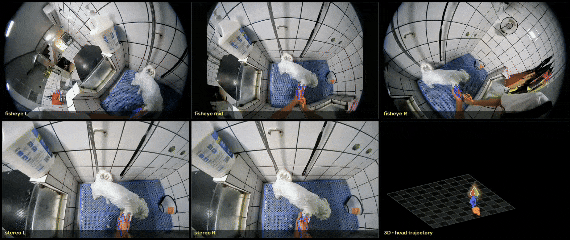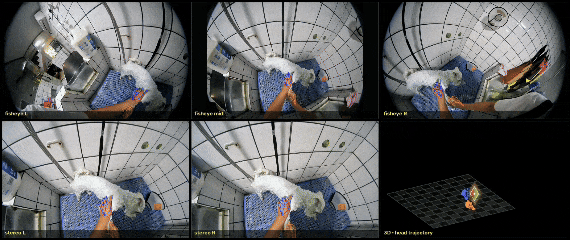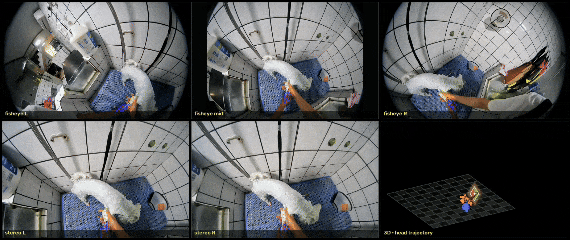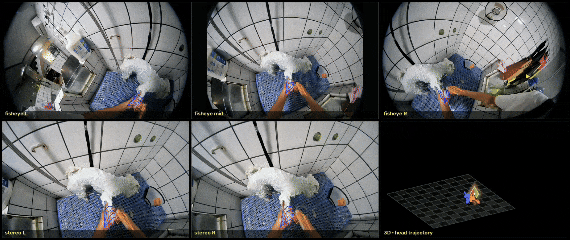
开放世界里,是否可以解决这些最常见的难点:比如遮挡、模糊、多人交互、外观变化,以及非标准动作等。往往决定了,我们把具身放到“物理世界”中,这个命题是真是伪。
07 两家大客户:一个是腾讯,一个是京东
发布会现场的两项合作,很有代表。
一个是面向模型,一个是面向场景。
京东是场景侧。现场,第 20,000 套 MEgo 正式交付京东,现场姚卯青也与京东副总裁何贺进行了一场对谈。设备最终会落到哪个具体业务环节,发布会没有展开,我们不替它预设答案。可以确认的是,京东能够提供实验室难以复制的真实流程、真实物体和持续变化的工作现场。对一家数采公司来说,这类场景入口往往比一次采购本身更重要。
腾讯 Robotics X 实验室则是模型侧。这次达成的是无本体数据业务合作,觅蜂将为腾讯的具身模型建设提供数据支持。
一端持续产生真实任务,一端提出模型需求,中间由采集设备、数据治理和运营系统连接起来。
觅蜂所说的「数据电网」,这里才真正出现供给方和使用方。
08 还有一些未解决的问题
现场我们发现了一些没有解决的问题,茂青来展开的。
一类是拧螺丝等高精度任务。这类操作对末端轨迹、力与触觉的要求更高。
另一类是 whole-body 数据。很多移动操作任务需要同时知道头、手、躯干和脚在做什么,现有产品对全身协同的覆盖还不完整。
这两点很重要,虽然现在没有解决,但现场透露,他们已经有面向 whole-body 数据设备的研发在推进了。
百万小时已经很大,但和姚卯青判断的千万乃至上亿小时需求相比,行业仍处在早期。
重磅!
全网首个!具身智能开源知识库来啦(技术/产业/投融资/上下游)
推荐阅读
我们用低成本的机械臂完成pi0/pi0.5/GR00T/世界模型等VLA任务~
VLA+RL方向首个系统教程来啦!Online RL/Offline RL/test time RL等~
VLA/VLA+触觉/VLA+RL/具身世界模型等!具身大脑+小脑算法与实战全栈路线来啦~
1v1 科研论文辅导来啦!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献158条内容

所有评论(0)