破解具身智能“数据荒”!Isaac Teleop+合成数据+Sim2Real,打通人形机器人训练闭环
如果说过去几年人工智能竞争的关键词是“大模型”,那么具身智能正在把另一个关键词推到台前:数据。
2026年8月28日,深圳市工业和信息化局、深圳市科技创新局发布《深圳市推动智能机器人产业高质量发展工作方案(2026—2028年)》,其中一项值得关注的内容,是支持建设具身智能数据采集场。
政策提出,鼓励开展仿真合成、视频、Ego第一人称视角、UMI、外骨骼、真机等多种形式的数据采集,同时支持机器人企业与工业制造、仓储物流等下游用户合作,在真实场景中采集工作数据,构建可复用的具身智能数据集。
为什么机器人产业已经有大模型了,还需要专门解决“数据”问题?
因为语言大模型解决的主要是信息理解与生成,而机器人最终面对的是一个更加复杂的问题:如何把对世界的理解转化成物理动作,并且在环境发生变化时依然能够完成任务。
这也是具身智能走向工业落地时绕不开的一道门槛。
一、机器人需要的不是普通数据,而是“动作数据”
假设给机器人一个任务:“把服务器板卡放到托盘中。”
对于人来说,这几乎不需要额外解释,但对于机器人而言,任务背后是一条连续的动作链:识别目标板卡、判断位置和姿态、选择抓取点、规划手臂轨迹、完成抓取、移动到托盘、调整姿态并放置,最后还需要确认任务是否成功。
因此,机器人真正需要学习的并不只是“这是什么”,而是在什么环境下,看到什么之后,应该采取什么动作。
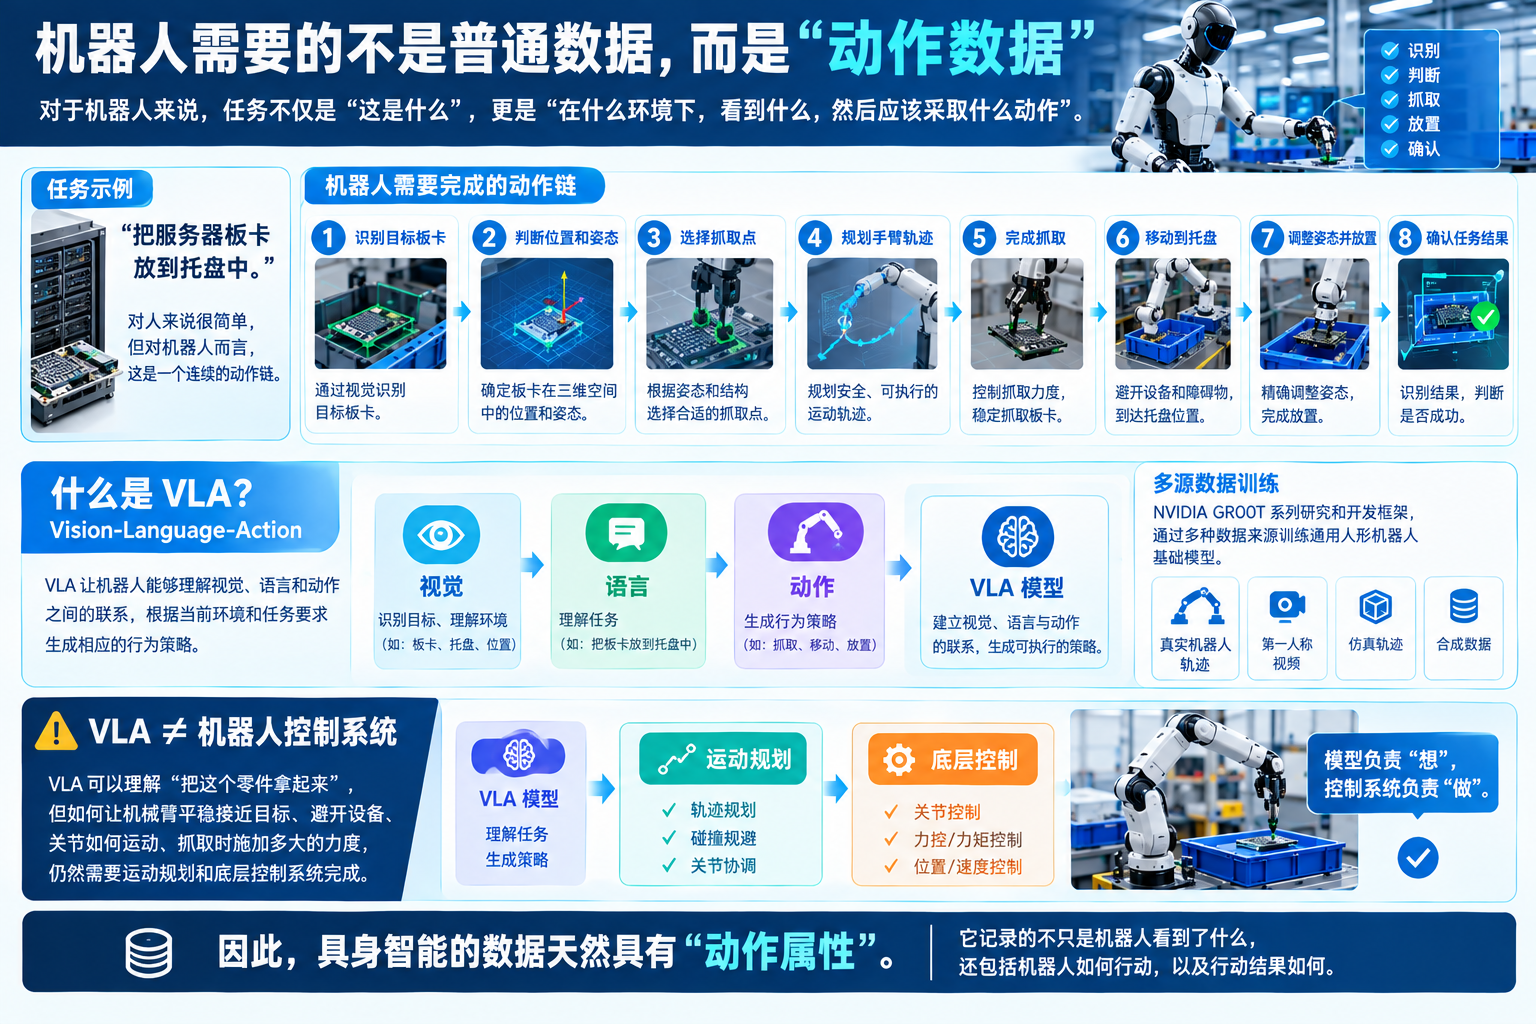
这也是Vision-Language-Action,即VLA模型受到关注的重要原因。传统视觉模型主要解决目标识别和环境理解,语言模型负责理解任务,而VLA进一步尝试建立视觉、语言与机器人动作之间的联系,让机器人能够根据当前环境和任务要求生成相应的行为策略。
NVIDIA公开的GR00T系列研究和开发框架,就是围绕通用人形机器人基础模型进行探索,通过真实机器人轨迹、第一人称视频、仿真轨迹和合成数据等多种数据来源训练机器人策略。
这里需要注意,VLA并不等于机器人控制系统。
模型可以理解“把这个零件拿起来”,但如何让机械臂平稳接近目标、如何避开设备、关节应该如何运动、抓取时施加多大的力度,仍然需要运动规划和底层控制系统完成。
所以,具身智能的数据天然具有“动作属性”,它记录的不只是机器人看到了什么,还包括机器人如何行动以及行动结果如何。
二、为什么机器人数据比互联网数据更难获得?
大模型可以从各类网络平台获得海量文本、图片和视频,但机器人没有这样的便利。
如果希望机器人真正学会抓取,就需要大量不同物体、不同位置、不同姿态和不同环境下的抓取数据;如果希望机器人学会装配,就需要采集大量真实操作轨迹。
而这些数据往往需要机器人亲自执行,或者由人类操作员进行示范。
真实数据采集不仅成本高,而且存在一个明显问题:很难覆盖所有情况。
机器人可能已经学会从标准位置抓取零件,但如果零件旋转了30度,或者位置偏移了一段距离,它还能不能完成任务?如果现场光照变化,或者物料表面存在反光,它的视觉判断是否仍然可靠?
这些情况都需要数据。
于是,具身智能逐渐形成了一种新的数据获取方式:真实数据负责提供现实经验,人类示范负责提供动作经验,仿真数据负责扩大训练规模。
三、Teleoperation:让人先教机器人怎么做
在机器人训练过程中,一个非常重要的技术路径是Teleoperation,也就是远程操控。
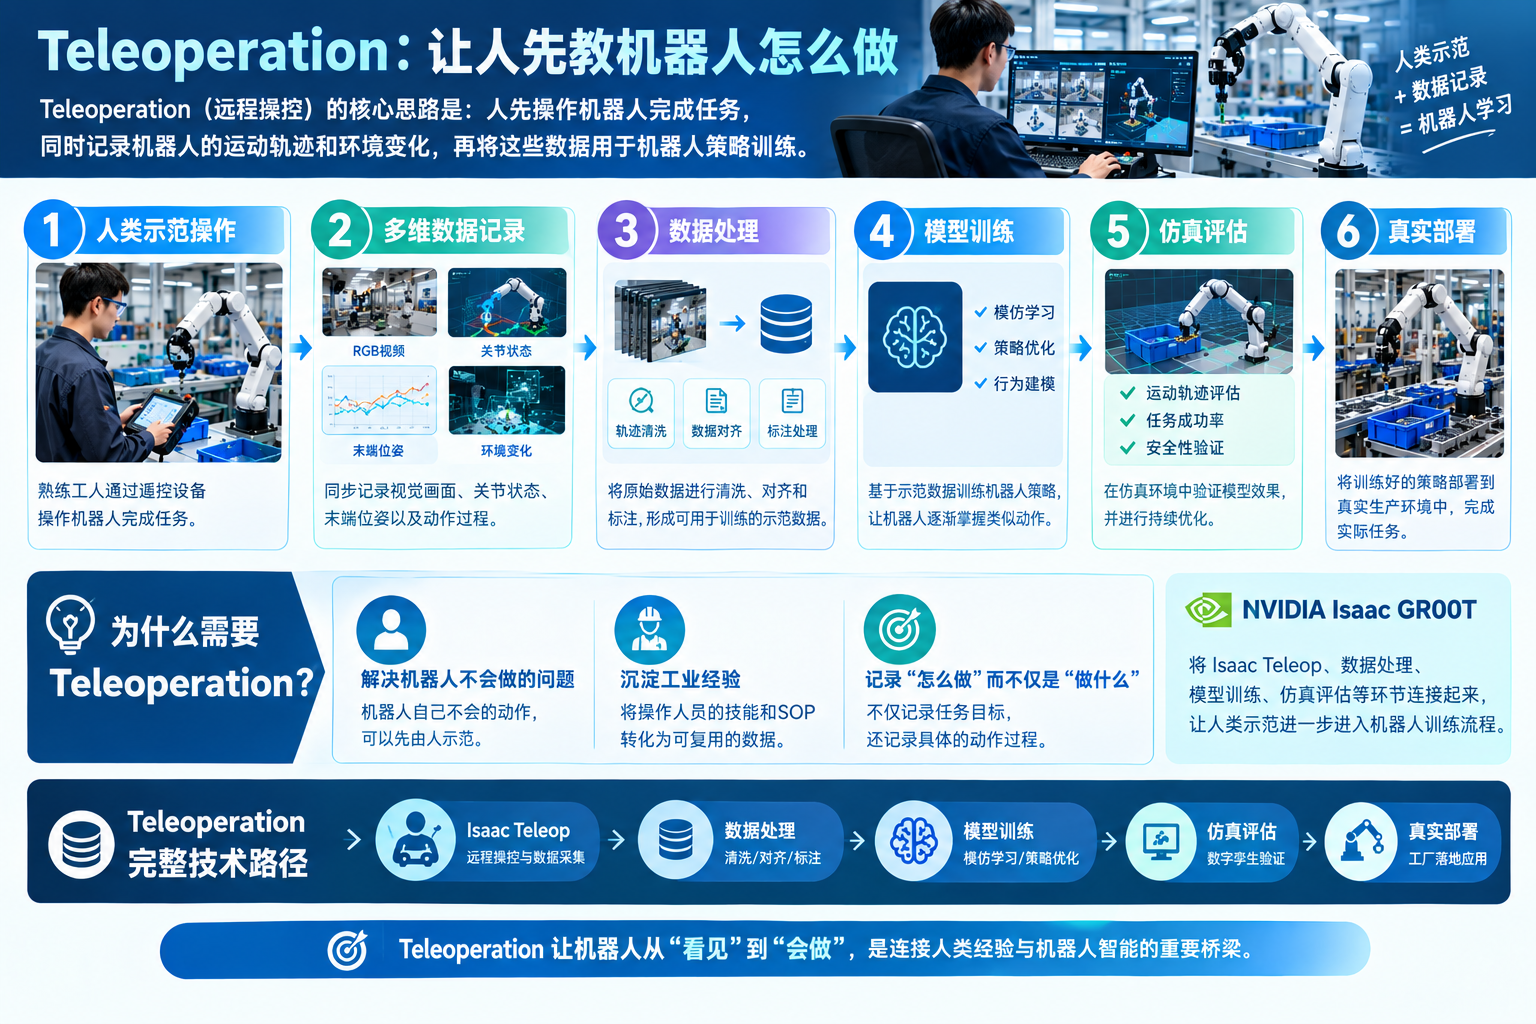
基本思路是让人先操作机器人完成任务,同时记录机器人运动轨迹以及环境变化,然后将这些数据用于机器人策略训练。
这解决了一个非常实际的问题:机器人自己不会做的动作,可以先由人示范。
例如熟练工人操作机器人完成一个复杂装配任务,系统可以同步记录视觉画面、关节状态、末端位姿以及动作过程。经过数据处理后,这些示范轨迹就可以用于模仿学习,让机器人逐渐掌握类似动作。
对于制造业来说,这种方式尤其有价值。
大量工业经验过去存在于操作人员的技能和SOP中,而Teleoperation提供了一种新的经验数字化路径:不仅记录“应该做什么”,还可以记录“具体怎么做”。
NVIDIA的Isaac GR00T开发体系已经将Isaac Teleop、数据处理、模型训练、仿真评估等环节连接起来,使人类示范能够进一步进入机器人模型训练流程。
四、为什么有了真实数据,还需要仿真数据?
真实数据重要,但完全依赖真实机器人训练并不现实。
一方面,机器人训练需要大量重复动作,会占用设备和生产资源;另一方面,真实工厂很难主动制造大量极端情况,而这些情况恰恰可能决定机器人能否泛化。
仿真因此成为具身智能训练的重要工具。
在NVIDIA Isaac Sim等平台中,可以建立机器人、设备、物料和环境组成的虚拟空间,并改变物体位置、姿态、光照以及机器人初始状态,让机器人反复执行抓取、搬运、避障和装配等任务。
仿真最大的优势是可以低成本扩大数据规模和环境变化范围。
真实数据告诉模型现实世界通常是什么样,仿真数据则可以帮助模型探索更多“如果发生变化怎么办”的情况。
因此,仿真并不是为了替代真实数据,而是为了让机器人获得更多试错机会。
五、Sim2Real:仿真练得好,不代表工厂里就能干
仿真解决了数据规模问题,却带来了另一个挑战:Sim2Real Gap。
虚拟环境中的物体摩擦力、摄像头噪声、机械误差、光照条件都可以人为设置,而现实世界不会按照设定运行。
一个在仿真中成功率很高的抓取策略,到了真实工厂里可能因为物体材质、位置误差或者光照变化而失败。
因此,工业具身智能真正需要的是一个闭环,而不是单向的“仿真训练→现场部署”。
比较典型的路径是:数据采集 → 模型训练 → 仿真验证 → 真机部署 → 现场数据回流 → 再训练。
机器人在虚拟环境中进行大量训练,表现较好的策略进入真实环境验证;真实机器人执行任务产生新的数据,再反馈给模型训练系统。
这样,仿真和真实世界就形成了相互补充的关系。
六、工业场景为什么特别适合形成“数据飞轮”?
当机器人真正进入工厂之后,一个重要变化就发生了:工厂本身开始成为机器人的数据源。
机器人每天执行搬运、拣选、检测、上下料等任务,会持续产生视觉数据、动作数据和任务结果。如果任务成功,这些数据可以帮助模型强化已有策略;如果任务失败,则可以进一步分析失败原因,并用于下一轮训练。
于是形成了具身智能非常重要的“数据飞轮”:人工示范产生数据,数据训练模型,模型进入仿真环境验证,验证后的策略部署到真实机器人,真实生产产生新的数据,再回到训练环节。
这个闭环的价值在于,机器人不再是一次训练、一次部署,而是可以随着数据积累不断提高任务成功率和环境适应能力。
对于工业企业而言,这可能比单纯追求机器人第一次部署时“有多聪明”更加重要。
七、工业富联科技服务正在把这套闭环放进真实工厂
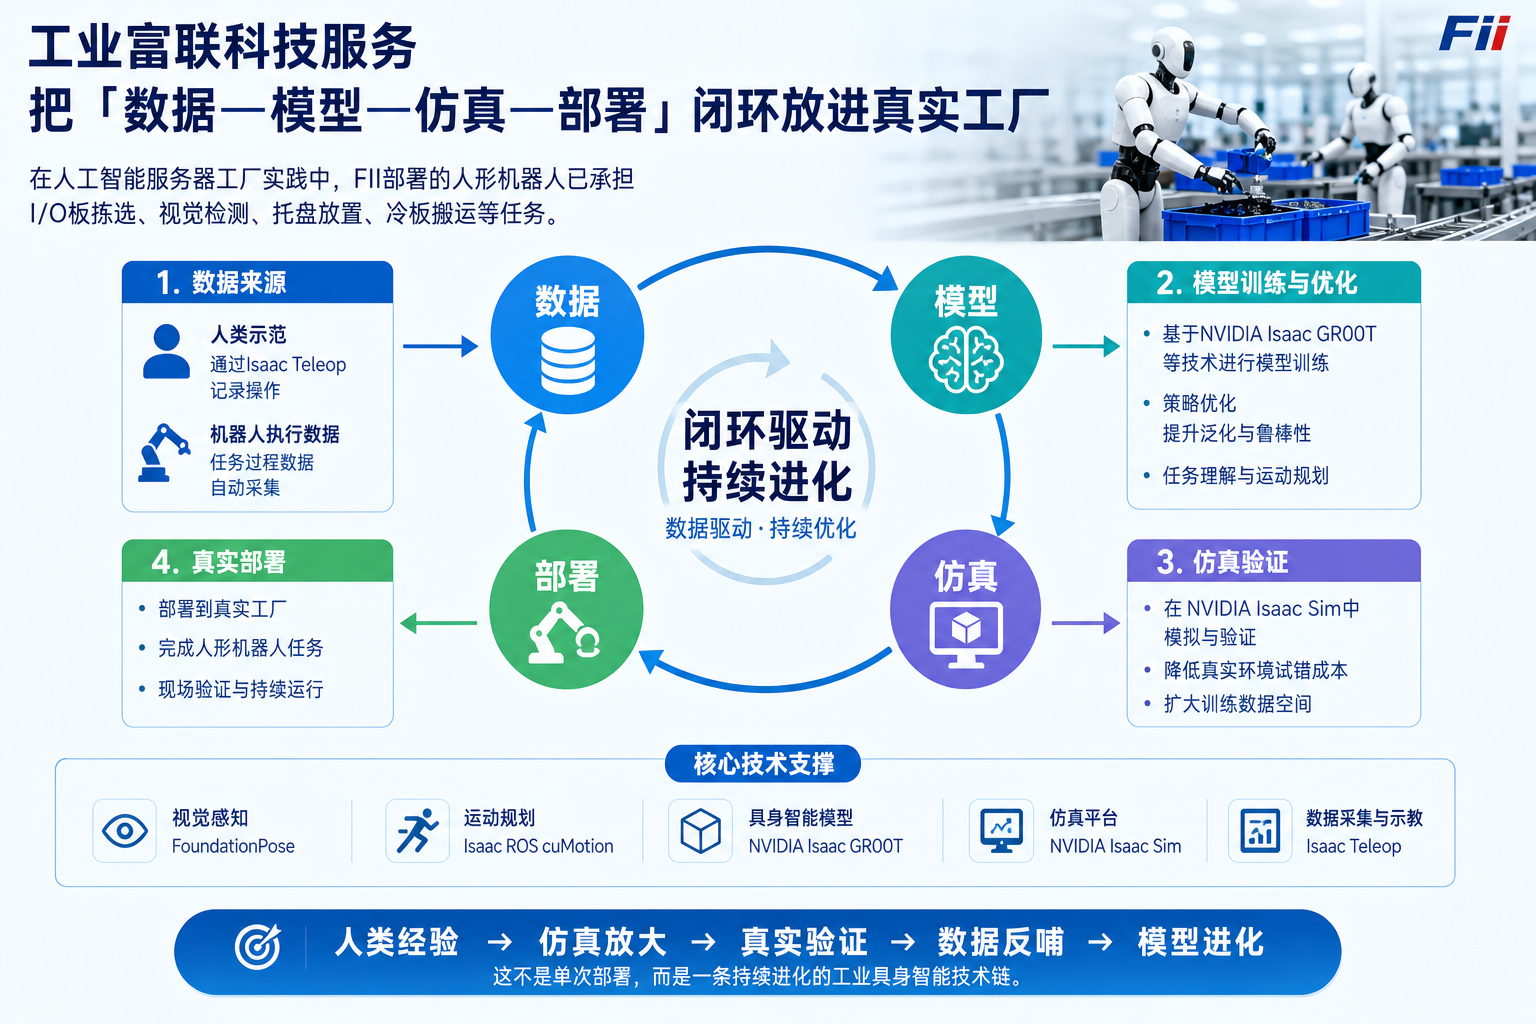
工业富联科技服务在具身智能领域的探索,正在围绕这条“数据—模型—仿真—部署”的技术链展开。
在人工智能服务器工厂相关实践中,FII部署的人形机器人已经承担I/O板拣选、视觉检测、托盘放置以及冷板搬运等任务。
在技术实现上,机器人结合FoundationPose、Isaac ROS cuMotion以及NVIDIA Isaac GR00T等技术完成视觉感知、运动规划和任务执行。相关动作在进入真实生产环境之前,会先通过NVIDIA Isaac Sim进行模拟和验证,以降低真实现场试错成本。
部署之后,真实工厂又成为新的数据来源。借助Isaac Teleop等技术,人类示范动作能够转化为机器人训练数据;机器人实际执行过程中产生的任务数据,也可以进一步用于模型和策略优化。
这样形成的并不是一个单纯的机器人应用,而是一条持续迭代的技术链:人类示范提供经验,仿真扩大训练空间,真实工厂负责验证,现场数据推动下一轮模型优化。
对于工业具身智能而言,这种闭环能力可能比单个机器人完成某一项任务更具有长期价值。
八、为什么深圳开始建设具身智能“数据采集场”?
再回头看深圳此次政策,“具身智能数据采集场”的意义就更加清晰了。
它并不只是建设一个地方让机器人采集视频,而是在补齐具身智能产业所需要的数据基础设施。
Ego数据可以记录第一视角下的人类观察和操作过程;外骨骼等方式可以采集人体动作;Teleoperation能够获取机器人示范轨迹;真机数据反映真实物理环境;仿真合成数据则可以快速扩大训练规模。
这些数据经过清洗、标注、筛选和训练之后,有机会形成面向工业操作的可复用数据资产。
这对于机器人产业规模化非常关键。
如果每一家机器人企业都需要从零开始采集数据,研发成本和周期都会很高;如果逐渐形成公共或产业化的数据采集、处理和训练基础设施,机器人技能开发的效率就有机会明显提高。
因此,未来机器人产业的基础设施,除了工厂、产线和零部件供应链之外,数据采集和仿真训练环境也可能成为重要组成部分。
九、人形机器人下一阶段,拼的可能是“数据飞轮”
人形机器人产业早期的竞争,很大程度上集中在本体、关节、电机、减速器和控制器等硬件能力上。
进入具身智能阶段之后,软件和数据的重要性正在快速提升。
有没有机器人基础模型?有没有高质量动作数据?有没有仿真训练环境?有没有真实工业场景?能不能把现场数据持续反馈给模型?
这些能力最终决定机器人能不能从“完成一个任务”,走向“不断学会更多任务”。
深圳此次政策同时提出具身智能大模型攻关、真实场景实训和数据采集场建设,实际上已经把产业发展的关键环节串联起来:模型负责学习,数据提供经验,仿真降低试错成本,真实场景负责最终验证。
当这条链路真正跑起来,人形机器人进入工厂的意义就不再只是增加一种自动化设备,而是制造业开始拥有一种能够通过数据持续学习、通过仿真持续训练、通过真实生产持续优化的Physical AI系统。
对于工业具身智能来说,真正值得关注的问题因此也不再只是“机器人什么时候能进工厂”,而是:进入工厂之后,它能不能越干越好。而这,或许才是“数据飞轮”真正的意义。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 6
 0
- 0


 已为社区贡献24条内容

所有评论(0)