VLA落地的三条路径:端到端、结构化技能库与混合架构
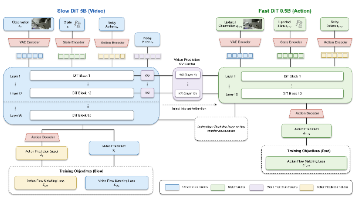
具身智能这一年最热的话题是 VLA(Vision-Language-Action)模型。OpenVLA 开源之后,几乎成了做机器人算法的默认起点——斯坦福和伯克利团队用 Open X-Embodiment 数据集里 97 万条真实机器人轨迹训练出这个 7B 参数的模型,把视觉、语言指令和动作输出打进同一个网络。紧接着 Physical Intelligence 的 π0 又往前推了一步,用 flow matching 直接生成连续动作序列,不再依赖离散化的动作 token。这条端到端路线现在是学术会议上出现频率最高的方向,但工程落地的时候,情况会复杂一些。
端到端 VLA 的优势很直接:感知、决策、动作在同一条链路里完成,不需要手工设计中间表征,换场景靠微调而不是重写一套规则。问题出在长时序任务上。机器人要完成的很多任务是多步骤的——识别物体、规划路径、执行抓取、检查结果、纠正偏差,端到端模型把这些步骤压进一个黑盒,误差会在步骤之间累积,出了问题很难判断是感知层出错还是决策层出错。而且覆盖长尾场景往往需要成千上万条额外示范数据,数据成本随着场景复杂度指数上升。
另一条路径是结构化技能库。把任务拆成一组原子技能——抓取、放置、导航、擦拭,每个技能单独训练或者调用现成的控制器,上层用规则或者轨迹规划器决定技能的执行顺序。这条路径工程上更可控,出了问题能定位到具体哪个技能失效,而不是面对一个不透明的端到端网络。代价是系统能做的事情边界很清楚——技能库里没有的动作组合,系统就是做不了,长尾场景处理能力天然弱于端到端模型。
Anthropic 今年发布的 Claude Skills,本质上是把这套"可插拔、可组合的结构化能力"思路带进了数字 Agent 世界。数字世界和物理世界在这件事上走的是同一条逢山开路的思路:单一大模型没法覆盖所有长尾场景,那就用工程化的方式把能力拆成模块,需要的时候调用,而不是指望一个模型什么都会。
真实工程落地里更常见的做法是混合架构。用 VLA 或者 VLM 处理感知和粗粒度决策——识别物体、理解自然语言指令、规划大致的动作序列,用结构化规则或者技能库兜底关键步骤——安全约束、精确的抓取点计算、任务边界的判断。这不是对端到端理想的妥协,是对当前 VLA 模型置信度的一个诚实判断:模型给出的动作预测还没有可靠到能完全托管高风险决策,工程上更现实的做法是让模型负责它擅长的模糊感知和粗规划,把精确控制和安全约束交给可验证的规则层。
这里其实是一个编排问题:VLA、技能库、业务规则这几层,谁的输出该被信任到什么程度,谁在什么情况下有权覆盖谁的决策。这和多 Agent 协作里怎么给不同 Agent 分配任务、怎么判断谁的产出可以直接采用、谁的产出需要另一个 Agent 审核,是同一类问题的两个版本——一个发生在数字世界,一个发生在物理世界。我们在Octo这边做多 Agent 编排的时候,处理的正是"谁负责什么、谁的输出该被信任到什么程度"这层问题,往具身场景延伸时面对的是同一个问题,只是决策的对象从数字任务变成了物理动作。
当 VLA 模型的置信度输出还不足以完全托管决策的时候,工程上更现实的选择不是等模型变得更聪明,是先把编排层和兜底规则的接口设计清楚。这条分界线会随着模型能力提升往后移,但短期内它决定了一个系统能不能真正在生产环境里跑起来。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献8条内容

所有评论(0)