机器学习系列文章:参数方法(回归)
一、回归
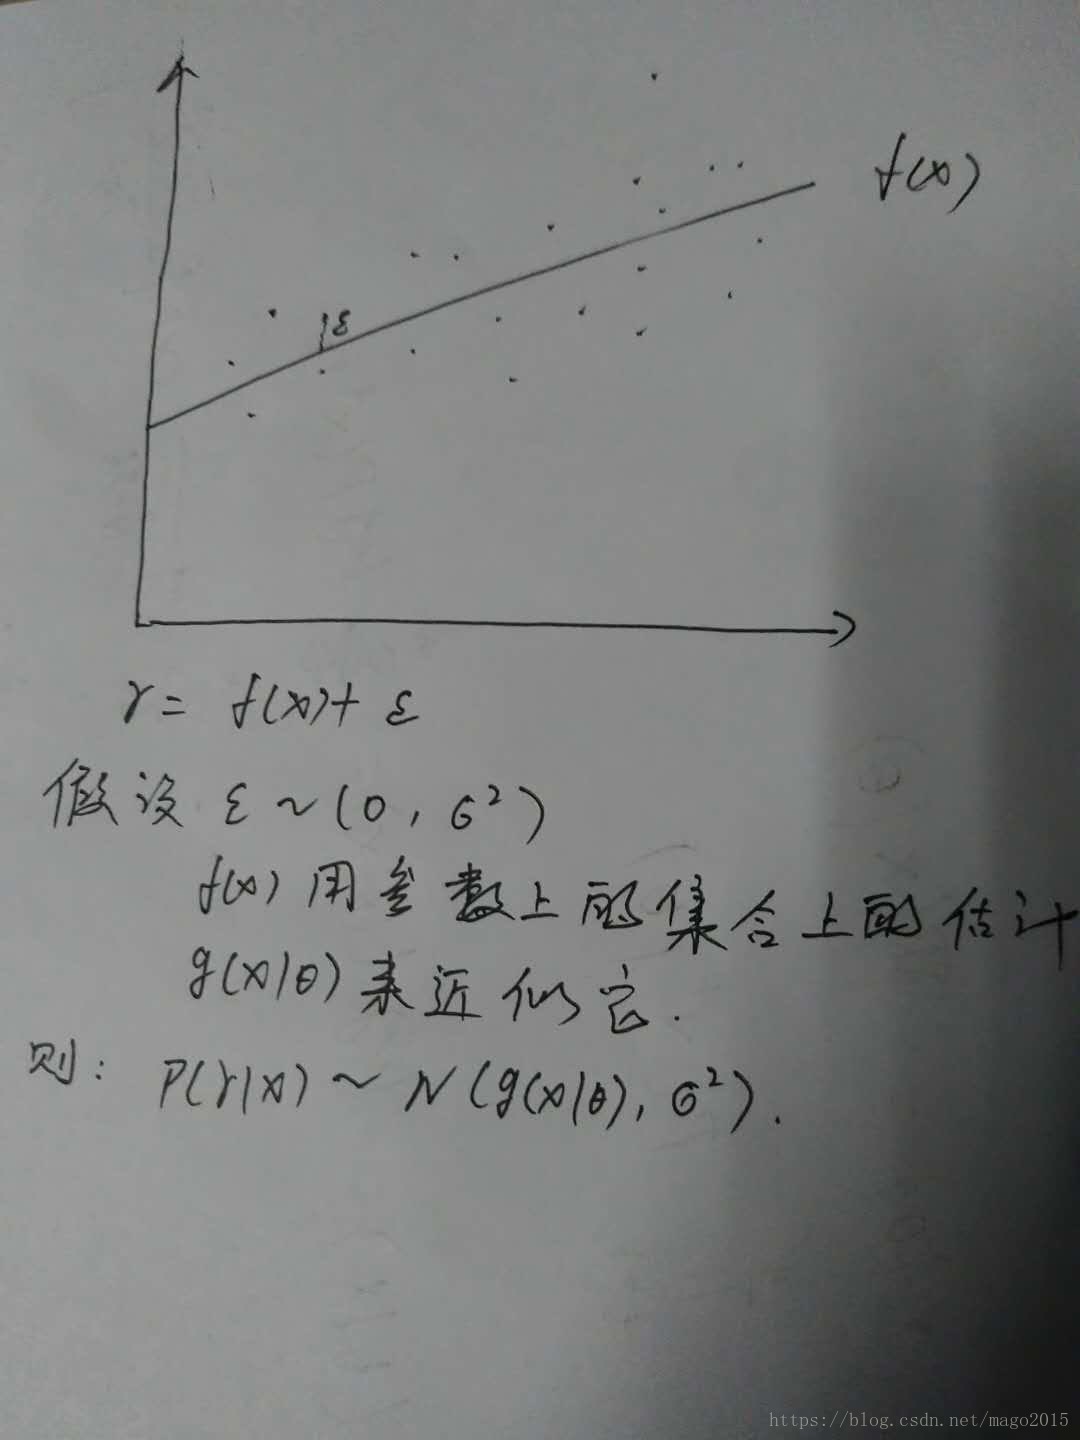
回归的基本含义是,通过多项式插值的方式获取一个能够拟合样本数据的函数,用来反映数据的一般性和通用性。在回归中,我们可以将函数的准确数值输出和随机噪声的和:
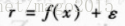
其中,f(x)是位置函数,将用定义在参数的集合上估计类似然 来近似它(直接对后验概率进行估计)。如果假定类似然
 服从0均值的高斯分布,即:
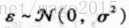 , 则有:
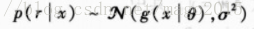
一个高斯分布和一个函数的乘积依旧满足高斯分布。所以,由上式可用最大似然来学习参数。
训练集中的对偶 取自位置联合概率
 ,所以可以记作:
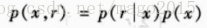
在假设样本分布为独立同分布时,我们假设的可以使用最大似然进行估计参数。上述的对数似然函数为:
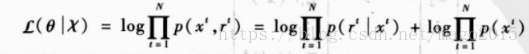
可以忽略第二项,因为它不依赖于我们的估计(我们的目的是利用最大似然求未知参数 )。于是我们有:
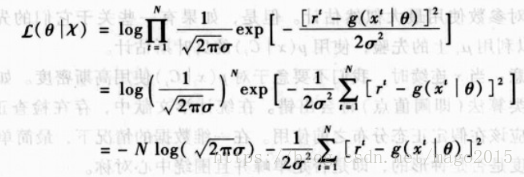
上式,第一项独立于参数 ,可以去掉,因子
 也可以去掉。最大化上式等价于最小化:
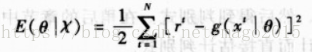
它是最经常使用的误差函数,而最小化它的参数的操作叫做最小二乘法,这是统计学经常做的一个变换:当似然l包含指数时,取代l,我们定义一个误差函数 (交叉熵),并最小化它。
---这就是为什么我们经常使用均方差和交叉熵损失函数作为误差函数求参数的过程。当样本点与期望回归判别式间垂直距离(噪声)分布满足0均值高斯分布,而且假定数值输出是输入的确定性函数与随机噪声的和,而确定性函数我们使用定义在参数集合上的估计来近似它。这样问题就转换成求以确定性函数为均值方差不变时的参数似然求解过程。
所以我们经常使用的均方误差函数求最小二乘的过程,可以看成是一个求最大似然的过程。
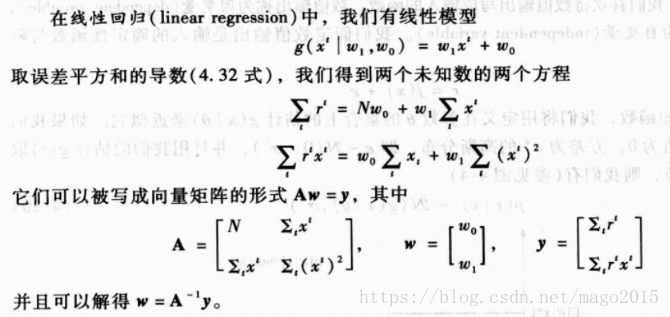
二、线性回归
所以我们经常使用的均方误差函数求最小二乘的过程,可以看成是一个求最大似然的过程。
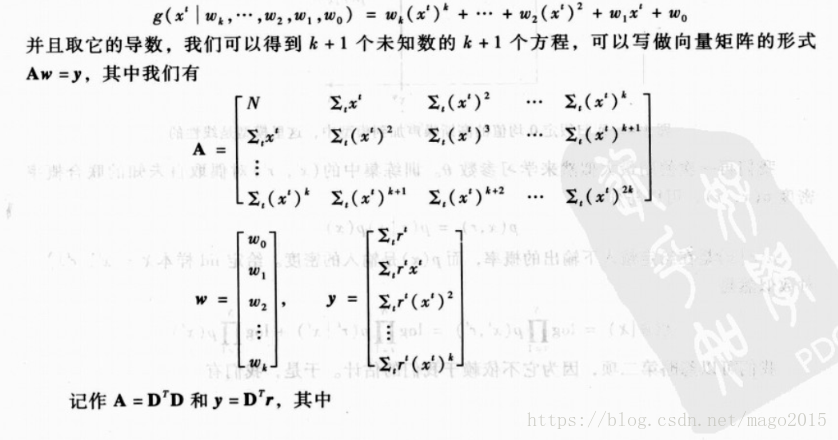
三、多项式回归
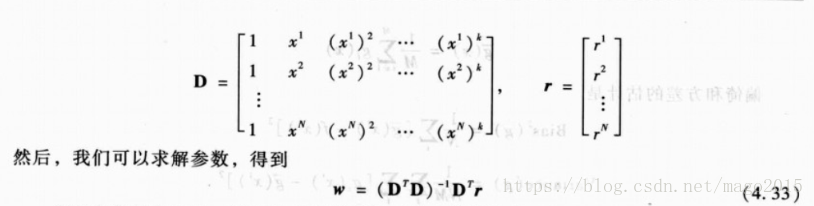
总结:
本文首先讲解了基本回归理论的推导。假设我们估算的回归方程与原始样本集间存在一定的噪声偏差,我们将这种噪声假设为高斯分布,然后样本集的估计可以表示成回归方程的估计和噪声的和。这样样本集就可以表示成均值为回归方程的估计,方差为噪声高斯方差的高斯分布。这样就可以针对这个高斯分布使用最大似然进行参数估计了。最终推出的公式为我们常见的损失函数均方误差函数。
所以,假定高斯分布误差且最大化似然对应于最小化误差平方和。
引: 机器学习导论

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献12条内容

所有评论(0)