机器学习实战篇:使用贝叶斯模型对鸢尾花数据集分类
·
1、简介
本文主要讲解朴素贝叶斯及其推理,并实现鸢尾花数据的分类问题
2、算法解释
朴素贝叶斯最初来源于统计科学领域。根据朴素贝叶斯公式:
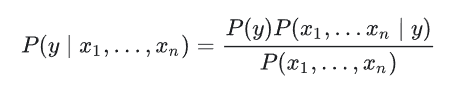
由于类似然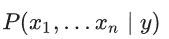 涉及到多个特征的组合求解较为困难。所以为了简化运算,降低计算复杂度,我们假设每个特征具备统计独立性,即特征间不存在关联性。这样就可以简化上述贝叶斯公式为:
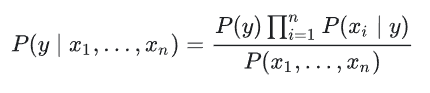
上述公式即为朴素贝叶斯通用公式,我们进一步化简去除无关证据项得:
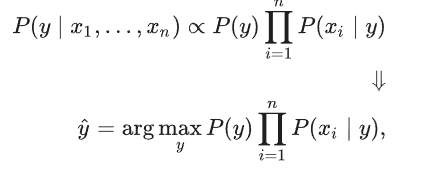
根据上述朴素贝叶斯简化公式,即可以得到某个样本属于某个类的近似统计概率。
3、案例展示
### 这里使用sklearn朴素贝叶斯集成库进行案例分析,其中GaussianNB函数假设了类似然函数满足高斯分布,即:
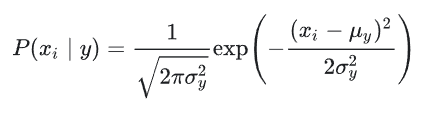
from sklearn import datasets
iris = datasets.load_iris()
from sklearn.naive_bayes import GaussianNB
gnb = GaussianNB()
y_pred = gnb.fit(iris.data, iris.target).predict(iris.data)
print("Number of mislabeled points out of a total %d points : %d" % (iris.data.shape[0],(iris.target != y_pred).sum()))
结果:
Number of mislabeled points out of a total 150 points : 6
原创整理,转载请注明出处!!!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献12条内容

所有评论(0)