计算机组成原理——第三章 存储系统
第三章 存储系统
一、基本概念
(一)存储体系层级结构
1.总体架构
从靠近CPU 到远离CPU ,存储层级依次为:Cache(高速缓冲存储器)→ 主存(内存,如内存条)→ 辅存(外存,像硬盘、U盘 等) ,还有更底层的磁带、光盘等,构成一个金字塔形结构,越往上速度越快、成本越高、容量越小,越往下速度越慢、成本越低、容量越大。速度最快的是寄存器,是连接CPU与主存储器的关键缓冲部件

2.各层级作用与关联
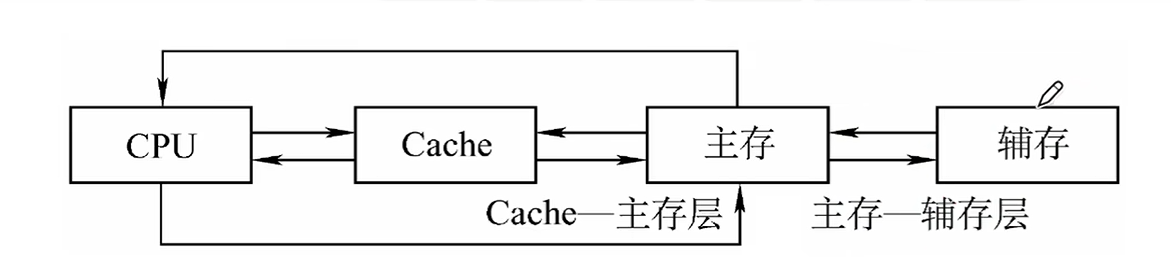
- Cache - CPU:Cache 是为缓解CPU(是芯片)快速运算与主存较慢读写速度的矛盾,存储CPU 近期要频繁访问的数据和指令,让CPU 能更快获取,减少等待主存读写的时间。
- CPU - 主存:CPU可直接读/写主存中的数据
- Cache - 主存:存在
Cache - 主存层次,涉及Cache 命中率等概念,用于高效利用Cache ,当CPU 访问数据时,先查Cache ,命中则直接用,未命中再去主存找并更新Cache 。 - 主存 - 辅存:主存 - 辅存层次借助
虚拟存储技术,把主存和辅存统一管理,让程序以为有超大容量主存可用,实现存储扩充,比如硬盘作为辅存,可暂存主存放不下但需处理的数据,在需要时调入主存。辅存中的数据要调入主存后才能被CPU访问

(二)存储器的分类
除了按照层次分类外,存储器还可以按以下标准分类:
1.按存储介质分类:
- 半导体存储器(主存、Cache),以半导体器件存储信息
- 磁表面存储器(磁盘、磁带),以磁性材料存储信息
- 光存储器(以光介质存储信息),以光介质存储信息
存储器的功能:存放二进制信息(0和1组合表示)。按存储介质分类:
2.按存取方式分类:
- 随机存取存储器(Random Access Memory, RAM) 读写任意存储单元所需时间与存储单元所在物理位置无关,如常见的内存,可随时读写数据 。
- 串行访问存储器:
读写某个存储单元所需时间与存储单元的物理位置有关。- 顺序存取存储器(Sequential Access Memory, SAM) 读写一个存储单元所需时间取决于存储单元所在的物理位置
- 直接存取存储器(Direct Access Memory, DAM) 既有能直接找到需读写存储单元所在区域,也有按顺序方式存取的特点,例如磁盘,通过磁头寻道找到大致区域后,再在该区域顺序读写数据。
- 相联存储器(Associative Memory) 可按内容访问的存储器(Content Addressable Memory,CAM),能以存储内容为依据快速检索,比如按内容检索存储地址进行读写,“快表”就是一种相联存储器 。
3.按信息的可更改性分类:
- 读写存储器(Read/Write Memory) 即可读,也可写(如:磁盘、内存、Cache),能灵活地写入和读取数据,满足程序运行中数据修改、更新需求 。
- 只读存储器(Read Only Memory) 一般只能读,不能写(如:实体音乐专辑通常采用CD-ROM,实体电影采用蓝光光碟,BIOS通常写在ROM中),但事实上,很多ROM也可以多次读写,只是比较麻烦。
4.按信息的可保存性分类:
- 易失性存储器 断电后,存储信息消失的存储器(主存、Cache),其工作依赖于供电,断电数据就丢失 。
- 非易失性存储器 断电后,存储信息依然保持的存储器—(磁盘、光盘),能长期保存数据,不受断电影响 。
- 破坏性读出 信息读出后,原存储信息被破坏(如DRAM芯片,读出数据后要进行重写,因为读出过程会破坏存储单元内的电荷状态 )。
- 非破坏性读出 信息读出后,原存储信息不被破坏(如SRAM芯片、磁盘、光盘,读出操作不影响存储内容,可多次读取 )。
(三)存储器的性能指标
- 存储容量:存储字数
(存储单元的个数)×字长(如(M×b)位 ),体现存储器能存储数据的总量。 - 单位成本:每位价格=总成本/总容量,用于衡量存储成本高低。
- 存储速度:数据传输率=数据的宽度
(存储字长)/存储周期。
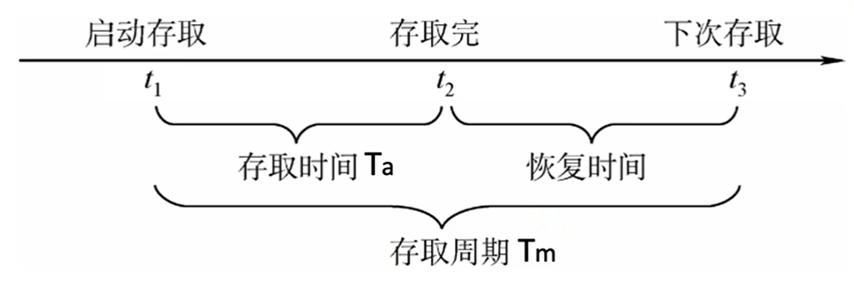
存储周期指存储器进行一次完整的读/写操作所需的全部时间,存取时间是从启动一次存储操作到完成该操作经历的时间,分读出时间和写入时间 。- 存取时间 (T_a):从启动一次存储操作到完成该操作所经历的时间,包含读出时间和写入时间。
- 存取周期 (T_m):又称读写周期或访问周期,是存储器进行一次完整的读写操作所需的全部时间,即连续两次独立地访问存储器(读或写操作)之间所需的最小时间间隔。
主存带宽((B_m) ):主存带宽又称数据传输率,表示每秒从主存进出信息的最大数量,单位为字/秒、字节/秒((B/s) )或位/秒((b/s) ) 。

二、主存储器基本组成
(一)基本元件及原理
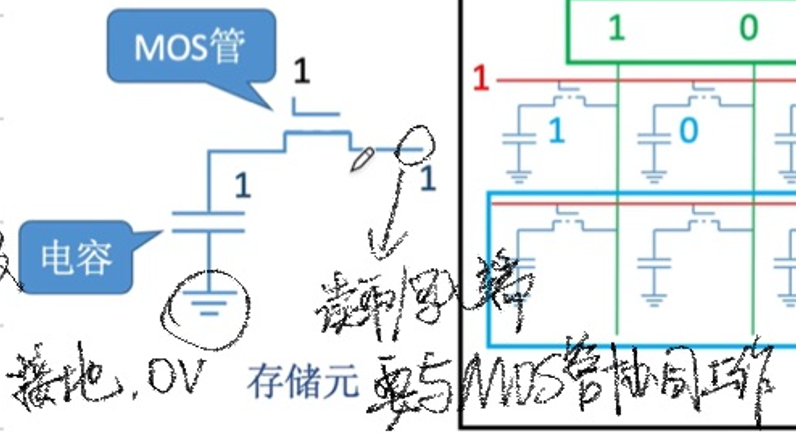
- MOS管
可理解为电控开关,当输入电压达到特定阈值时,MOS管能够导通,在半导体存储等电路里,是实现数据存储与控制的基础元件,常和电容配合工作 。 - 电容
与MOS管协同构成存储元,利用电容存储电荷的特性表示二进制信息,比如带电状态可表示“1”,放电后可表示“0” ,是存储元实现数据存储的关键部分。 - 存储元
- 存储体(存储矩阵)
大量存储元的集合,是实际存放数据的物理空间,可看作由众多存储单元组成的阵列结构,为数据存储提供“容器” 。

(二)存储器芯片的基本原理
1.核心概念与基础参数
-
存储容量表示
存储器芯片容量常见表述如8K×8位、8K×1位、64K×16位等,含义为存储单元个数 × 存储字长 。- 以
8K×8位为例:8K是存储单元数量(8K = 2¹³,即 13 位地址可寻址),8位是每个单元存储字长,总容量为2¹³×8bit = 8KB(1Byte = 8bit)。
- 以
-
关键信号与引脚
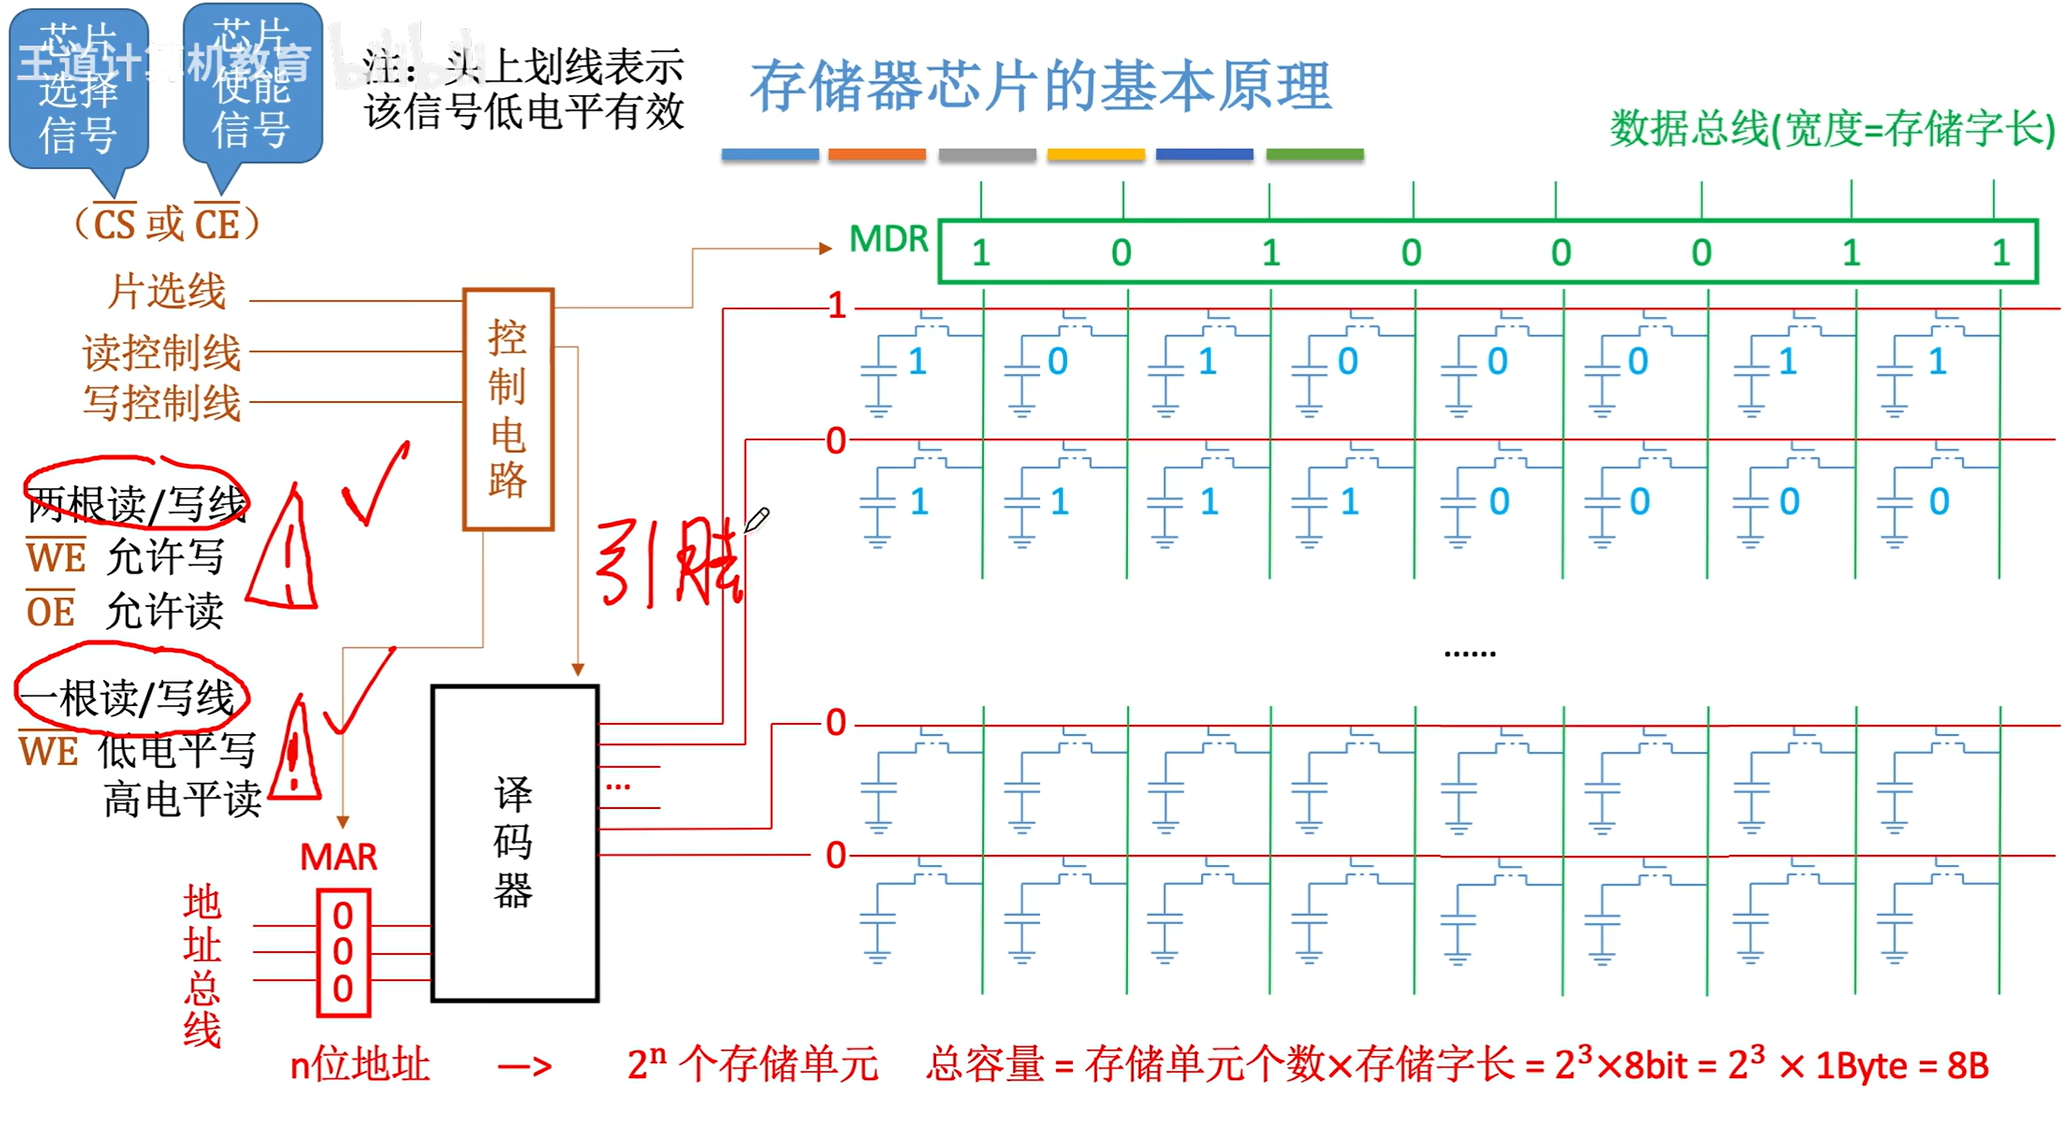
每根线都会对应一个金属引脚,此外,芯片还有供电引脚、接地引脚- 地址总线:传输要访问的存储单元地址,
n位地址总线可对应2ⁿ 个存储单元,地址送入 MAR(地址寄存器) ,经译码器定位单元。和CPU连接。 - 数据总线:宽度等于存储字长,用于传输读写的数据,和 MDR(数据寄存器) 交互,实现数据收发。和CPU连接。
- 读/写控制线:控制芯片读写操作,如
WE(写使能,低电平写)、OE(读使能,低电平读),配合时序决定数据流向。 - 片选线(CS 或 CE):决定芯片是否工作,初始常为高电平(芯片未选中);需访问时,片选线变低电平,选中对应芯片。
- 电源与接地引脚:保障芯片供电稳定,让电信号可靠传输(笔记中“保证电信号能在稳定状态下传输” )。
- 地址总线:传输要访问的存储单元地址,

2.芯片内部结构与工作流程

-
内部模块
- 存储矩阵:大量存储单元组成,是实际存储数据的“仓库”,按地址矩阵式排列。
- 译码驱动器:接收地址总线信号,经译码器后选中存储矩阵中对应单元,配合读写电路操作。驱动器用来确保译码器输出的高电平信号稳定有效(把电信号放大),常接在译码器后。
- 读写电路:连接存储矩阵与数据总线,写操作时将数据总线数据写入存储单元;读操作时从存储单元读出数据到数据总线。
- 控制电路:整合读/写、片选等信号,协调各模块时序,保障读写流程有序,保证电信号能在稳定状态下传输。
-
读写流程(以读为例)
- 地址输入:CPU 把存储单元地址通过地址总线 送至芯片,地址存入 MAR 。
- 芯片选中:片选线 置低电平,选中当前芯片;若为高电平,芯片不响应操作。
- 读控制:
OE(读使能)置低电平,触发读操作,控制电路 协调译码驱动器选中目标单元。 - 数据输出:存储单元数据经读写电路 处理,通过数据总线 传输到 MDR ,供 CPU 或其他部件使用。
(写操作类似,WE(写使能)置低电平,数据从 MDR 经数据总线、读写电路写入存储单元 )
3.内存条与芯片关联

一个内存条可能包含多块存储芯片 ,通过合理布局与电路设计,让多芯片协同工作,扩展存储容量与带宽。使用时,系统通过地址、控制信号等,协调访问不同芯片,提升整体存储能力。
(三)寻址

三、SRAM与DRAM(随机存储器)
(一)核心区别
DRAM芯片:常用于主存储器,使用栅极电容存储信息,靠电容电荷状态保存数据 。
SRAM芯片:常用于Cache使用双稳态触发器存储信息,利用触发器的两种稳定状态(如高、低电平 )存储数据 。
核心区别在于:存储信息的元件本质不同(电容 vs 触发器 ),这导致后续性能差异 。
(二)栅极电容 VS 双稳态触发器

- 栅极电容:靠电容存储电荷,结构简单,集成度高,制造成本低,功耗低,但读出信号时,电容放电,信息被破坏,是破坏性读出,因此读出后,应有重写操作,这导致读写速度慢。
- 双稳态触发器(如NMOS实现 ):由多个MOS管组成,有两条数据线,结构相对复杂,集成度受限,但状态稳定,无需频繁刷新,读写速度快。只要不断电,触发器的状态就不会改变。
(三)工作原理与特性对比
| 类型特点 | SRAM(静态RAM) | DRAM(动态RAM) |
|---|---|---|
| 存储信息元件 | 触发器 | 电容 |
| 破坏性读出 | 非(读出数据不破坏原存储状态) | 是(读出后电容电荷流失,需再生) |
| 读出后需要重写?(再生) | 不用 | 需要 |
| 运行速度 | 快 | 慢 |
| 发热量 | 大 | 小 |
| 存储成本 | 高 | 低 |
| 易失/非易失性存储器? | 易失(断电后信息消失) | 易失(断电后信息消失) |
| 需要“刷新”? | 不需要 | 需要 |
| 送行列地址 | 同时送(容量小,地址少) | 分两次送(容量大,地址多) |
| 常用场景 | 常用作Cache | 常用作主存 |
(现在的主存通常采用SDRA)
(四)读写原理
- SRAM读/写:
读:通过字选择线选通,双稳态触发器状态输出到数据线,因触发器状态稳定,读出后数据不丢失,无需再生 。
写:字选择线选通,数据线信号写入触发器,改变其稳定状态。写0:BL低电平,BLX高电平;写1:BL高电平,BLX低电平 - DRAM读/写:
读:字选择线激活,MOS管导通,电容电荷经位线放电,产生电流被检测为数据(但此过程使电容电荷减少,属于破坏性读出,需后续“再生” ) 。
写:字选择线激活,MOS管导通,数据线电平控制电容充电(写“1”充电,写“0”放电 ) 。
刷新:因电容电荷会泄漏(约2ms内电荷流失 ),需定期(小于2ms )对DRAM所有存储单元重新充电,补充电荷,保证数据不丢失 。
(五)DRAM的刷新
刷新基本概念
- 刷新频率:
- 一般 2ms 内要完成全部行的刷新(因电容电荷泄漏特性,需定期补充电荷保证数据不丢失 )。
- 每次刷新一行的存储单元(不同 DRAM 结构对应不同行规模 )。
- 刷新条件与判断
- 有硬件支持时,读出一行的信息后重新写入,占用 1 个读/写周期(利用读写操作同时完成刷新 )。
- 无硬件支持时,需专门的“刷新周期”,仅完成刷新操作(如只输出行地址,进行刷新 )。
刷新策略对比

| 刷新策略 | 特点 | 死时间 | 适用场景 |
|---|---|---|---|
| 分散刷新 | 每个存取周期刷新一行 | 每个周期有刷新耗时(如 50ns ),但分散到全程 | 对实时性要求不高,追求简单控制 |
| 集中刷新 | 2ms 内集中一段时间刷新所有行 | 集中段内无法读写(如 51.2μs 死时间 ) | 对性能波动容忍度高,硬件控制简单 |
| 异步刷新 | 每行按间隔(2ms/行数 )刷新 | 死时间短(单个周期级 ) | 对实时性和效率都有要求的系统 |
(六)、DRAM 的地址复用技术

地址复用原理
- DRAM 地址分为行地址和列地址(如行地址 A0 - A9 、列地址 A10 - A19 等,具体位数依芯片定 )。
- 通过行地址锁存器、列地址锁存器,分两次传送地址(先送行地址,锁存后送列地址 ),利用多路地址线(如系统 2 条地址线,配合分时复用 ),减少芯片引脚数量(地址引脚可复用行、列地址 )。
- 流程:地址信号先送行地址锁存器,锁存行地址用于选通存储矩阵的行;再送列地址锁存器,锁存列地址选通列,行、列地址分两次送,可使地址线更少,芯片引脚更精简 。
地址复用优势
- 减少芯片引脚数量:无需为行、列地址单独设置大量引脚,降低芯片设计复杂度和成本 。
- 适配系统地址总线:可与 CPU 等部件的地址总线高效配合,利用分时复用传输行、列地址 。
四、只读存储器ROM
(一)各类 ROM 介绍

(二)ROM 共性与核心区别
- 共性:断电后数据不丢失,属于非易失性存储器,适合存储固定程序、固件等 。
- 核心区别:在于内容改写的方式与灵活性,从 MROM 完全不可改,到 PROM 一次改写,再到 EPROM 紫外线擦除、EEPROM/Flash 电擦写,灵活性逐步提升 。
(三)计算机内的重要 ROM(以主板 BIOS 为例 )
- 功能:存储“自举装入程序”,计算机启动时,先从 BIOS 读取引导程序,再从辅存中加载操作系统到 RAM 并运行(开机) 。
- 意义:属于计算机“主存”体系的一部分(虽物理独立,但逻辑上是启动关键),保障系统从断电到开机的初始化、引导流程。逻辑上,主存由RAM+ROM组成,且二者常统一编址
五、双端口RAM与多模块存储器
(一)双端口 RAM
基本概念与特性
双端 RAM 具备两套独立的地址线、数据线和读写控制线,可支持两个 CPU 或功能部件同时访问存储单元。但当两个端口同时访问同一存储单元时,会产生访问冲突,需通过“忙”信号(如 BUSY 标识 )进行仲裁,一个端口访问时,另一个端口需等待,保障数据一致性 。

应用场景与优势
适用于多处理器共享存储等高并发访问场景,能提升存储访问的并行度,让不同处理器可同时读写不同存储区域,加速数据交互与处理流程 。
(二)多体并行存储器
多体并行存储器可简单类比为**“多根内存条并行工作”** ,通过多个存储体(如M₀、M₁、M₂、M₃ )协同,提升数据存取效率,关键区分高位交叉编址与低位交叉编址两种模式。
编址模式对比

高位交叉编址
- 地址结构:地址高位表示体号,低位表示体内地址 。例如地址
00100,高位选体,低位定位体内部单元。 - 访问特点:连续访问时,通常同一存储体需完成存取(含恢复时间)后,才能访问下一个地址 。因相邻地址大概率属于同一“体”,存取
n个存储字耗时≈nT(T为存取周期 ),效率较低,基本被淘汰
低位交叉编址
- 地址结构:地址低位表示体号,高位表示体内地址 。地址按存储体数量“分散”,如 4 个体时,地址
0、4、8…对应M₀,1、5、9…对应M₁等。 - 访问特点:连续访问时,无需等待存储体恢复即可访问下一个体(因相邻地址一般属于不同体 )。存取
n个存储字耗时≈T + (n-1)τ(τ为存取时间,T为存取周期 ,且T > τ),接近流水线工作模式,大幅提升效率,是多体并行“提速”的核心设计。
流水线条件与模块数计算
为实现流水线不间断(即前一个体读写未结束,下一个体可接力),需满足:
- 若存取周期为
T,存取时间为t,则模块数m ≥ T/t(存取不停顿)。 - 若存取周期为
T,总线传输周期为t,同理需m ≥ T/t(传输不停顿)。
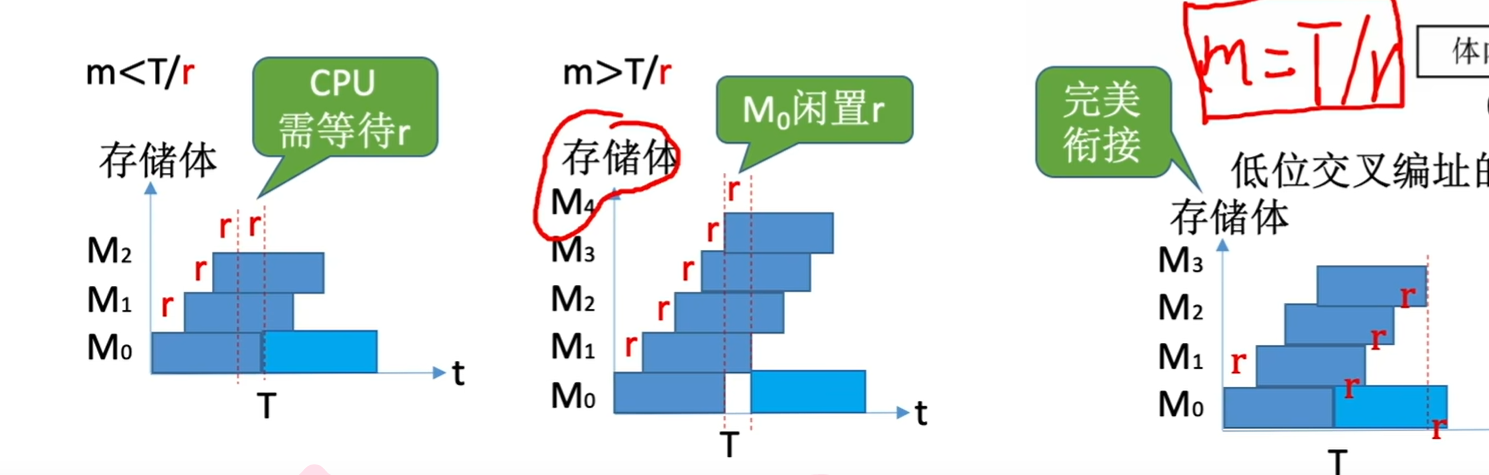
通过合理设置模块数m,可实现“完美衔接”(m = T/t时,各体流水线无闲置);若m < T/t,CPU 需等待(存储体未准备好);若m > T/τ,会出现存储体闲置(资源浪费 )。

效率提升逻辑
低位交叉编址的多体并行,利用“相邻地址分散到不同体”的特性,让存储体无需等待完整周期恢复,就能接力处理下一个地址,宏观上使“读写一个字的时间接近t” ,突破单存储体的存取速度限制,显著提升存储器带宽与整体存取效率。
(三)多模块存储器
多模块存储器分类与核心差异
多体并行存储器
可理解为多个独立“小存储器”(模块)并行工作,每个模块具备:
- 相同容量与存取速度;
- 独立读写控制电路、地址寄存器、数据寄存器;
- 支持并行工作(同时操作不同模块) 或交叉工作(按地址交叉访问) ,灵活适配不同场景。
关键优势:访问某存储字时,可精准定位模块读取,无需额外读取无关数据。
单体多字存储器
- 结构特点:单个存储模块内,每个存储单元存
m个字,总线宽度也为m个字,一次读/写必取连续m个字 。 - 核心局限:若目标数据不在“连续
m字”范围内,无法单独读取某个字 ,且可能被迫读取无关数据(因总线宽度固定,需按m字批量传输 )。
两类存储器对比
| 类型 | 多体并行存储器 | 单体多字存储器 |
|---|---|---|
| 访问灵活性 | 可精准访问单个字,按需选模块 | 仅能批量访问连续 m 字,无法单独取 |
| 数据关联性 | 访问目标字时,不涉及无关数据 | 易读取无关数据(因批量传输) |
| 存取效率逻辑 | 靠模块并行提升吞吐量 | 靠“单次多字传输”提升名义效率 |
| 适用场景 | 通用存储、随机访问(如内存主存) | 需连续数据批量读写场景(如特定缓存) |
(两者的读取速度一样)
内存条(属于主存)插法与交叉编址实现
高位交叉 vs 低位交叉

- 高位交叉(单纯扩容):插入内存条时,选不同颜色插槽但同组通道(如 A1 + A2 ),地址高位选模块,实现“容量叠加”。
- 低位交叉(双通道/多通道):插入内存条时,选同颜色插槽、同主频率/容量(如 A1 + B1/A2 + B2 实际要看主板推荐),地址低位选模块,让访问“分散到多模块并行”,提升带宽。
- 双通道对比单通道,已能满足需求,提升明显,多通道提升不明显
- 在同一通道插入的,只会提高这一通道的容量,并且采用高位交叉编址
实操 Tips
买内存条时,优先选同品牌、同容量、同主频率的,若不同:
- 高频条会降频适配低频条;
- 容量不同以“最小容量 × 2”为准(如 8G + 16G ,实际按 8G×2 工作 ),多余的部分变成单通道。
六、主存储器与 CPU 的连接
(一)现代计算机的寄存器集成
现在计算机中,MDR、MAR多集成在CPU内部,作为CPU与主存交互的“桥梁”,部分还包含缓存功能,加速数据访问。而存储芯片上则只有一个普通的寄存器(暂存输入、输出数据)
(二)多芯片扩展
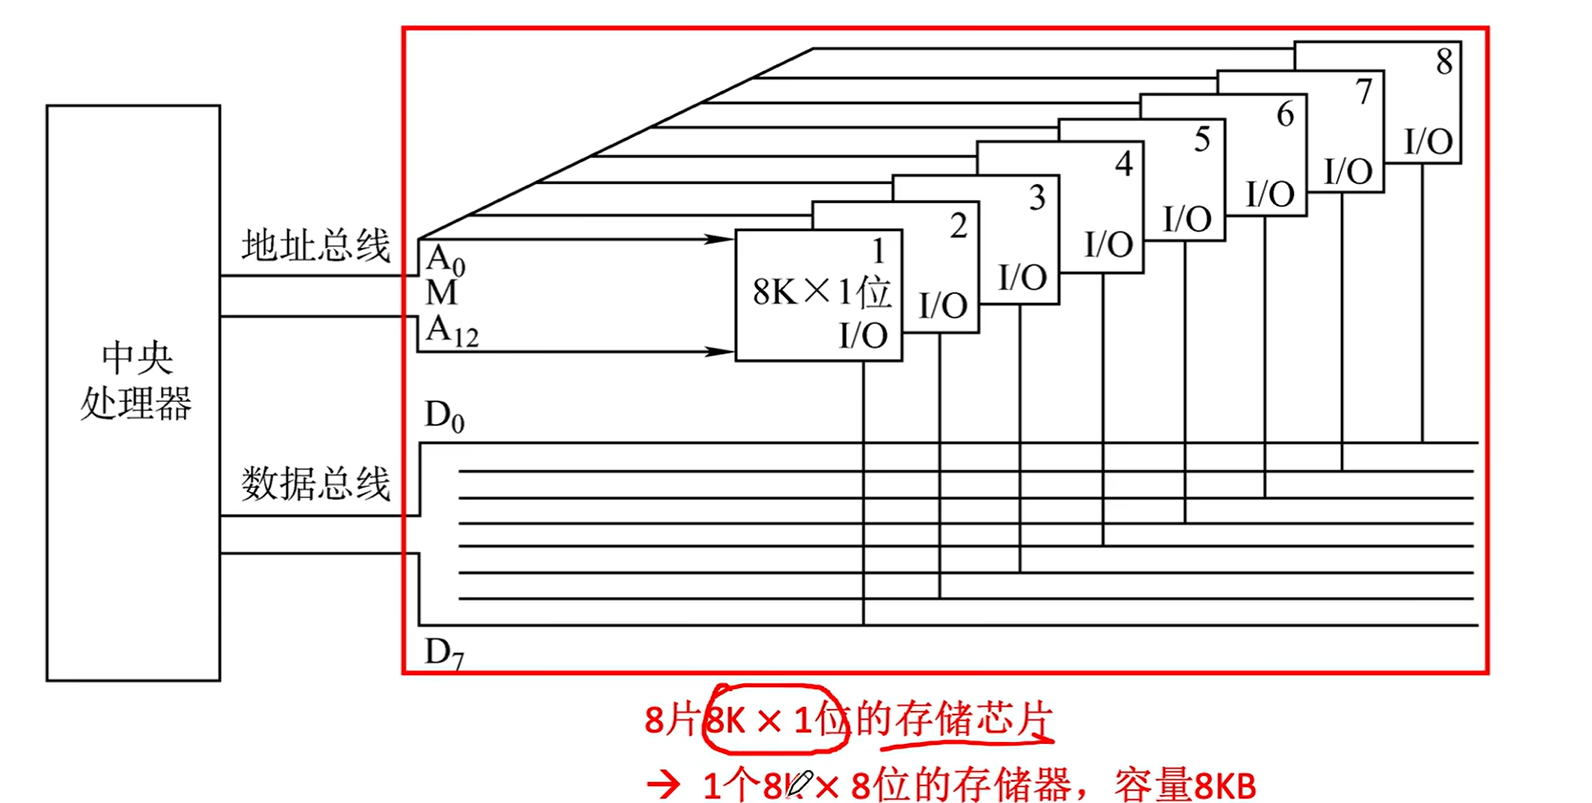
1. 位扩展(增加主存存储字长)
- 原理:将多个同容量、同字长芯片“并联”,扩展数据总线宽度。如用8个8×1位芯片,组成8×8位主存,每个芯片负责1位数据,同时读写,提升字长 。
- 作用:匹配CPU数据总线宽度,增强单次数据传输能力,更好发挥数据总线传输能力

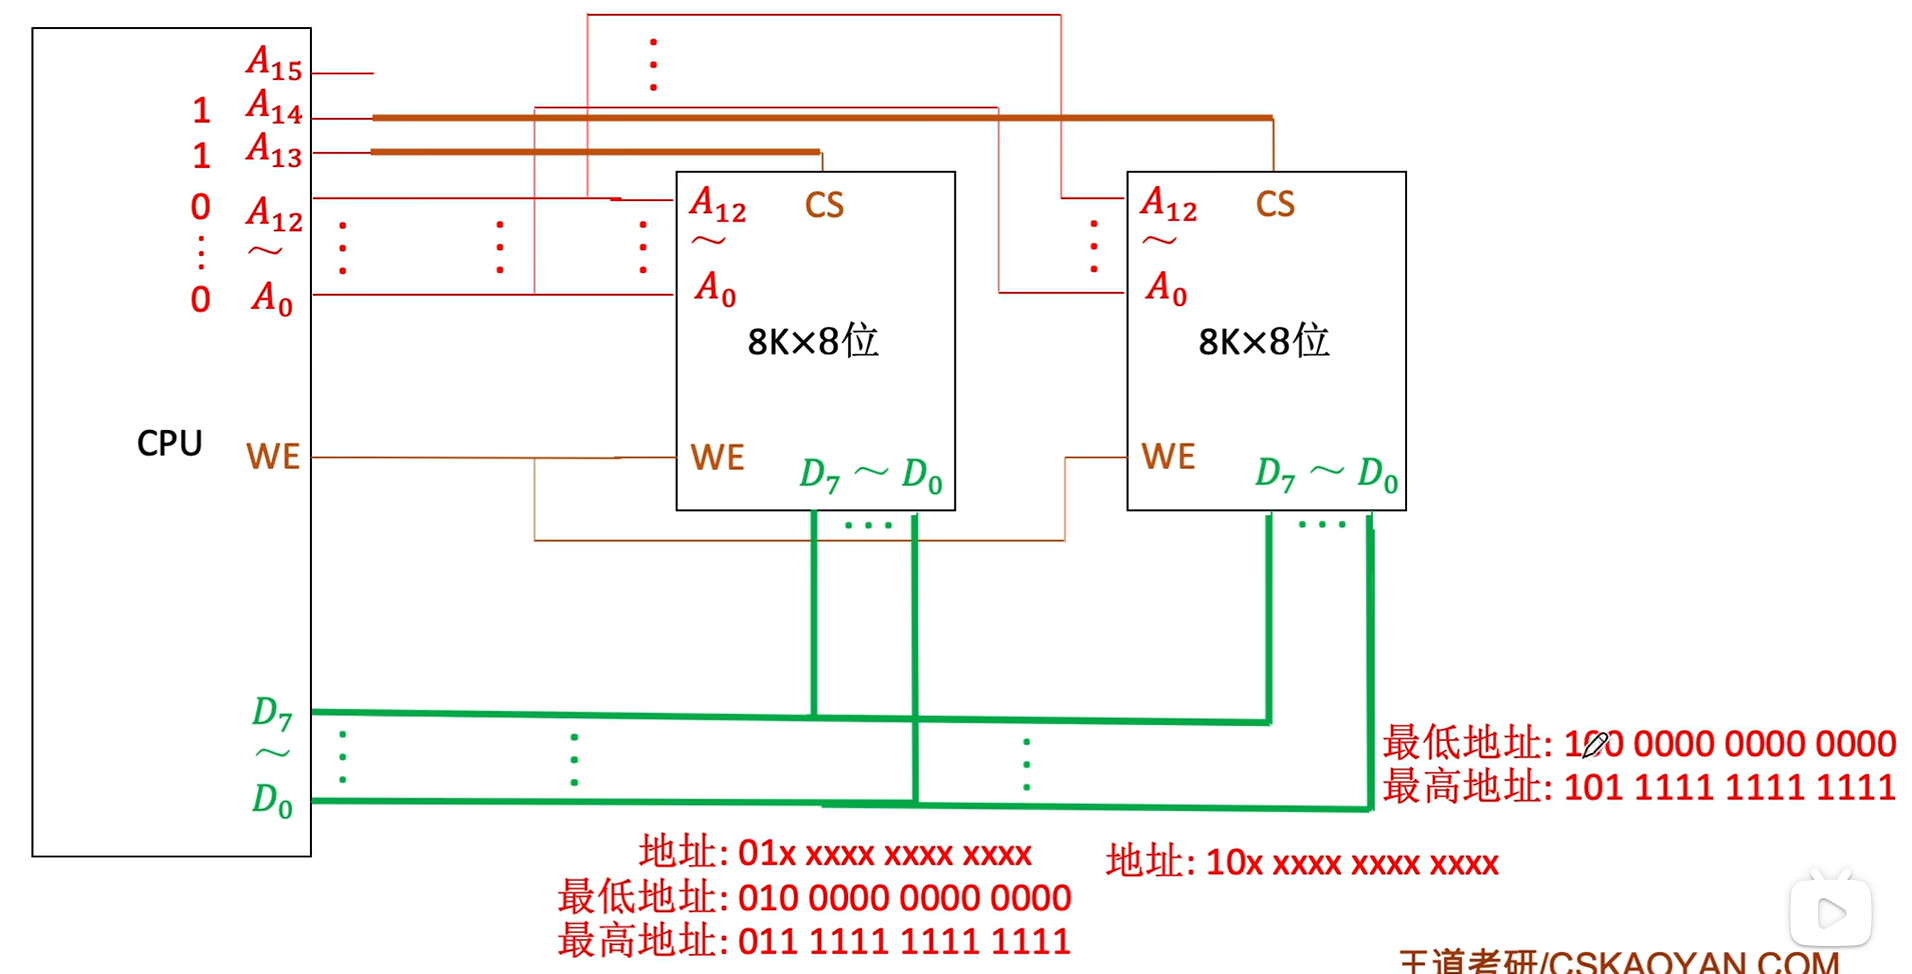
2. 字扩展(增加主存存储字数)
- 原理:将多个同字长芯片“串联”,扩展地址空间。如用8个1×8位芯片,组成8×8位主存,通过片选信号选通不同芯片,增加存储单元数量 。
- 片选实现方式:
- 线选法:
n条地址线直接选n个芯片,电路简单,但地址空间不连续
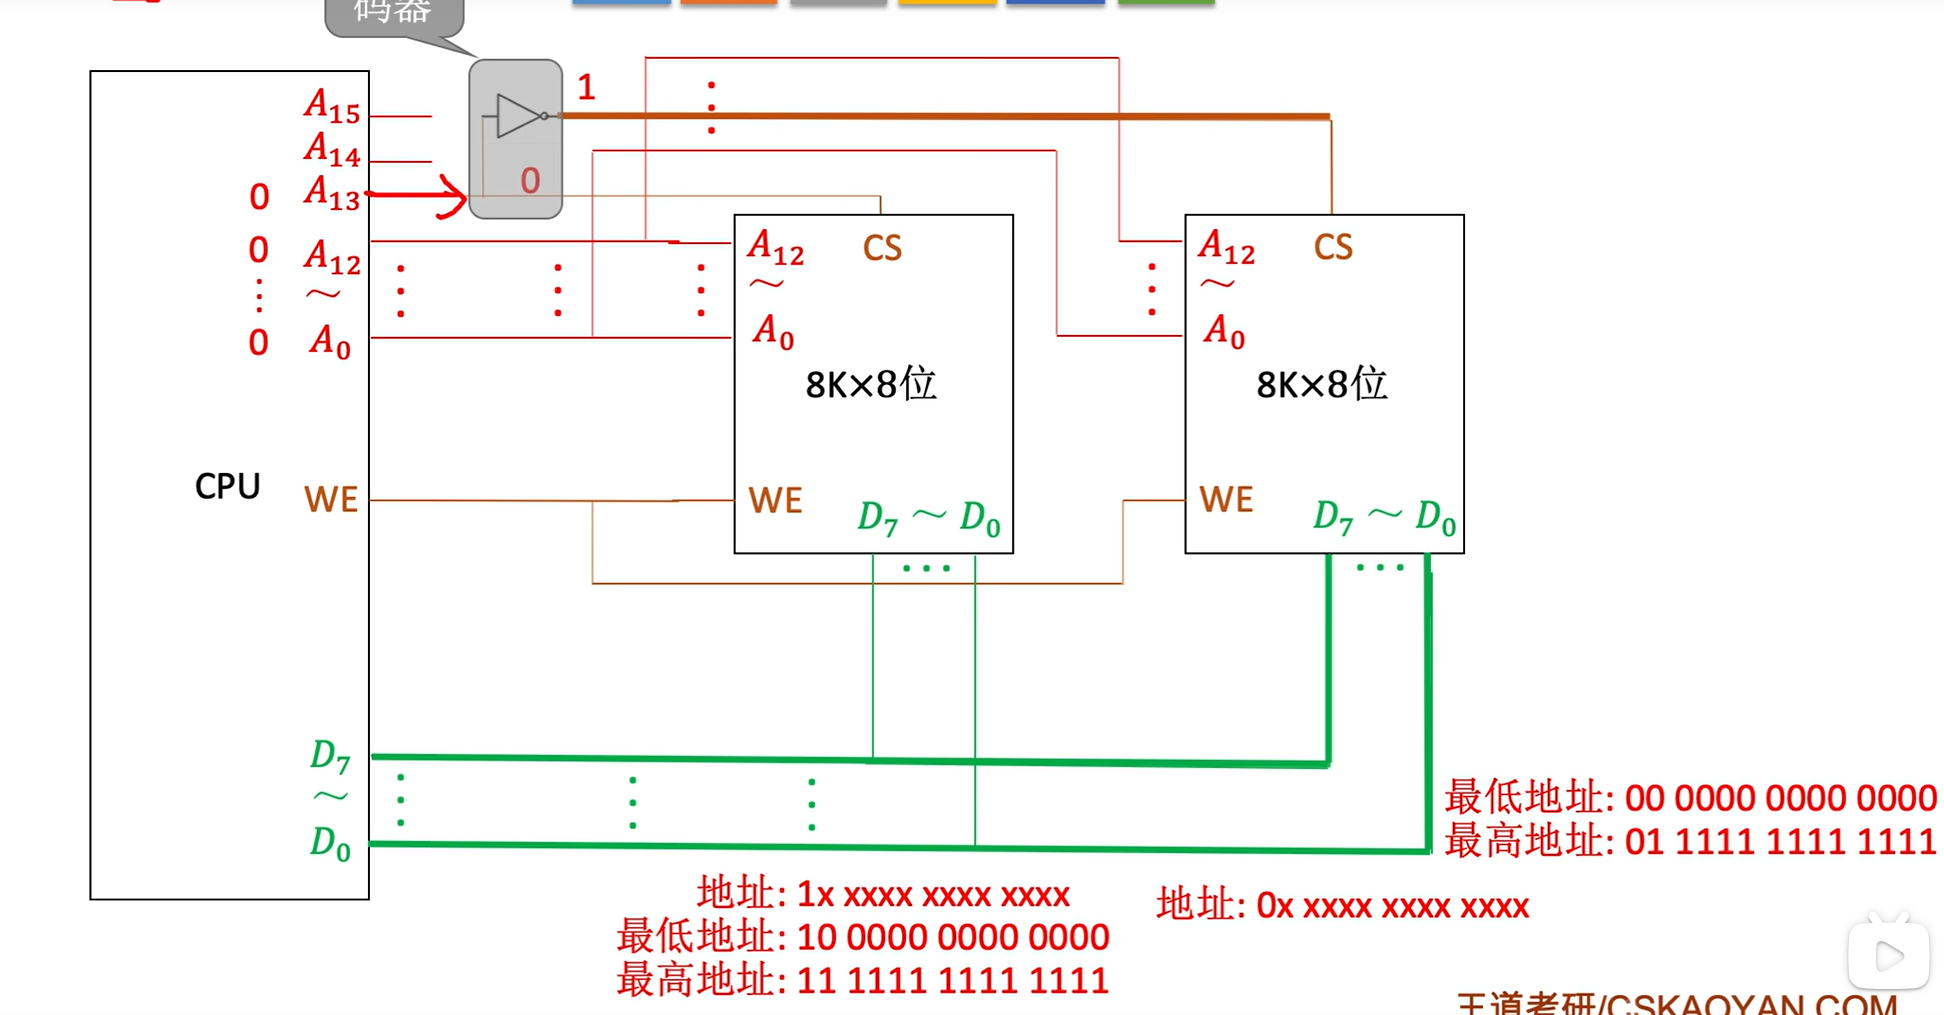
- 译码片选法:
n条地址线经译码器生成2ⁿ个选片信号,电路复杂,但地址空间连续
- 线选法:


3. 字位同时扩展扩展

(三)译码器
1.译码器作用
将CPU输出的高位地址译码,生成片选信号,选中对应存储芯片,实现多芯片字扩展时的地址空间管理。
2.使能信号

CPU可以通过使能信号控制片选信号的生效时间。CPU先送出地址信号,稳定后发出使能信号

七、外存储器
(一)外存储器概述
外存储器又称为辅助存储器,用于长期存储大量数据,可作为输入/输出设备。目前主要使用磁表面存储器,常见类型包括磁盘存储器(如硬盘),利用磁记录原理存储信息,通过磁头读写磁盘表面的磁化区域实现数据交互。

(二)磁表面存储器
- 盘片:表面涂覆磁性材料,是数据存储的物理载体,通过磁层磁化方向变化记录“0”和“1” 。
- 磁头:负责读写数据,悬浮于盘片表面,写入时改变磁层磁化状态(通电线圈,电生磁),读取时感应磁场变化转换为电信号(切割磁感线)。
- 驱动机构:包含主轴(带动盘片旋转)、磁头臂(带动磁头寻道),保障磁头精准访问盘片指定位置 。
(三)磁盘存储器

1.磁盘的物理组成

2.磁盘的性能指标
-
存储容量
总容量 = 记录面数 × 磁道数(柱面数)× 扇区数 × 扇区容量 。
(例:若硬盘有4个记录面,每个柱面8000个磁道,每个磁道64个扇区,扇区容量512字节,则总容量 = 4×8000×64×512 Byte 。)
磁盘容量有格式化和非格式化之分。- 非格式化容量是指磁记录表面可以利用的磁化单元总数,即设计容量。
- 格式化容量是指按照某种特定的记录格式所能存储信息的总量,实际使用中,并非使用所有容量,部分容量留作备用,应对扇区损坏
-
记录密度
指盘片单位面积上记录的二进制的信息量,通常以道密度、位密度和面密度表示:- 道密度:是沿磁盘半径方向单位长度上的磁道数
- 位密度:是磁道单位长度上能记录的二进制代码的位数
- 面密度:是位密度和道密度的乘积
- 注意:同一扇区的每一道的二进制位数一样。因此,磁盘所有磁道记录的信息量一定是相等的,并不是圆越大信息越多,故每个磁道的位密度都不同。越内侧的磁道位密度越大。
-
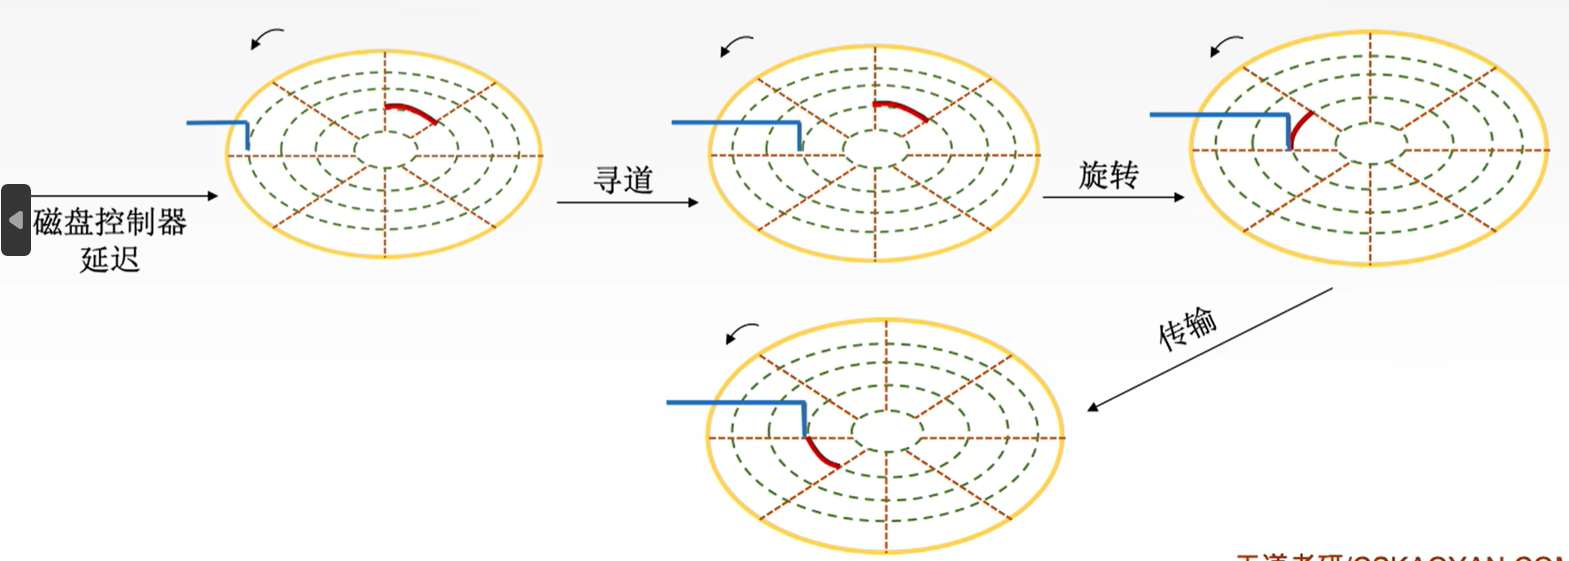
平均存取时间
=寻道时间(磁头移动到目的磁道)+旋转延迟时间(磁头定位到所在扇区)+传输时间(传输数据所花费的时间)
-
数据传输率
磁盘存储器在单位时间内向主机传送数据的字节数,称为数据传输率。- 假设磁盘转速为r(转/秒),每条磁道容量为N个字节,则数据传输率为rN

3.磁盘地址
主机向磁盘控制器发送寻址信息,磁盘地址一般如图所示:

4.磁盘的工作过程


(四)磁盘阵列
1.RAID 基本概念
RAID(Redundant Array of Inexpensive Disks,廉价冗余磁盘阵列 ):将多个独立物理磁盘组成独立逻辑盘,数据在多个物理盘分割交叉存储、并行访问,具备更好存储性能、可靠性和安全性 。
2.RAID 分级及特点
RAID的分级如下。在RAID1~RAID5中的几种方案中,无论何时有磁盘损坏,都可以随时拔出受损的磁盘再插入好的磁盘,而数据不会损坏。
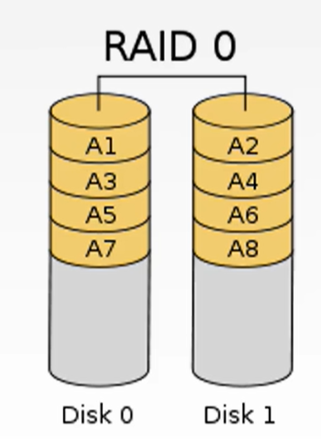
RAID 0
- 特点:无冗余和无校验的磁盘阵列。把连续多个数据块交替存放在不同物理磁盘扇区,多个磁盘交叉并行读写。
- 优势:扩大存储容量,提升磁盘数据存取速度。
- 不足:没有容错能力,若有磁盘损坏,数据易丢失。
- 示意图:

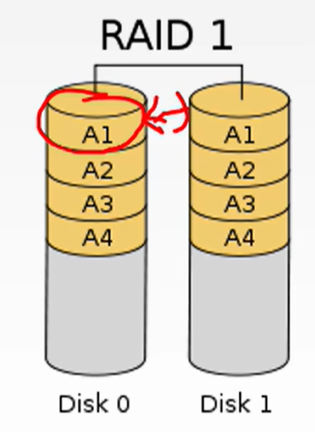
RAID 1
- 特点:镜像磁盘阵列,很粗暴,存两份数据。为提升可靠性,两个磁盘同时读写、互为备份,一个磁盘故障,可从另一磁盘读数据,两个磁盘当一个盘用,容量减少一半。
- 示意图:

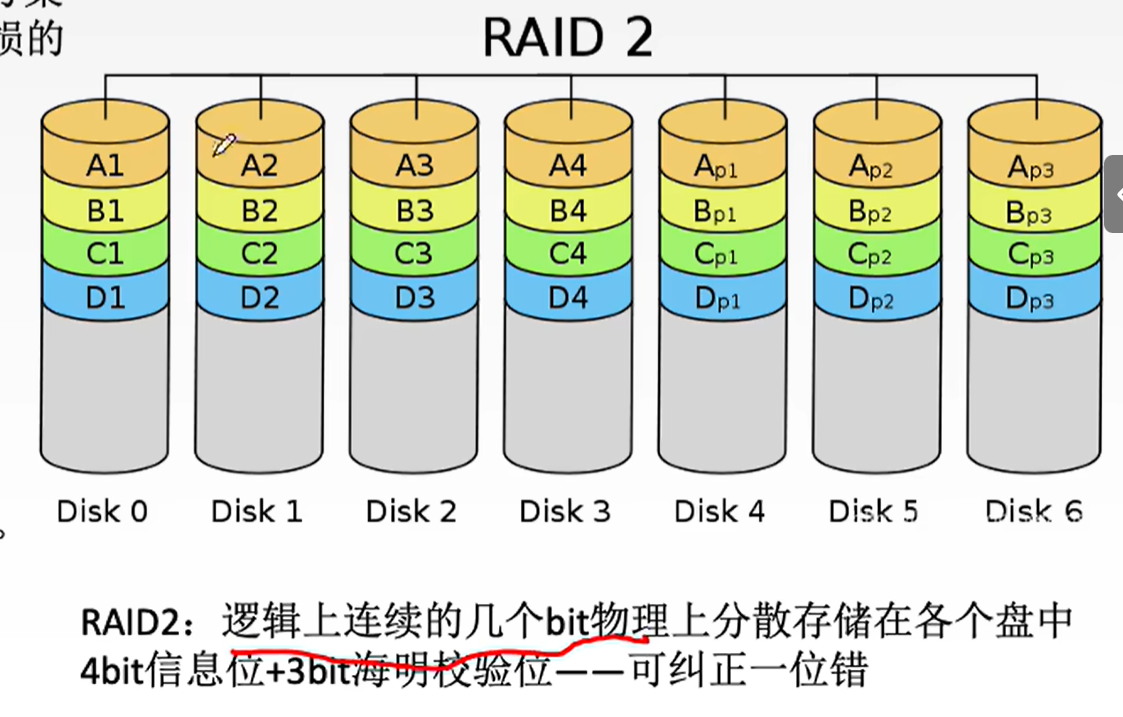
RAID 2
- 特点:采用纠错的海明码的磁盘阵列。逻辑上连续的几个 bit 物理上分散存储在各个盘中,4bit 信息位 + 3bit 海明校验位 —— 可纠正一位错 。
- 示意图:

RAID 3
- 特点:位交叉奇偶校验的磁盘阵列(笔记中未详细展开,可补充:以位或字节为单位交叉存储数据,同时设置专门校验盘存储奇偶校验信息,用于数据恢复 )。
RAID 4
- 特点:块交叉奇偶校验的磁盘阵列(笔记中未详细展开,可补充:按块交叉存储数据,有专门校验盘,针对块级别的数据进行奇偶校验 )。
RAID 5
- 特点:无独立校验的奇偶校验磁盘阵列(笔记中未详细展开,可补充:将校验信息分散存于各个磁盘,没有专门校验盘,兼具一定性能和容错能力 )。
(五)固态硬盘(SSD)
1.SSD 基础概念
固态硬盘(SSD),基于闪存技术(Flash Memory ),属于电可擦除 ROM(EEPROM ),是计算机存储设备,和机械硬盘有明显差异。
(闪存因可快速整块擦除、数据状态切换高效,早期突出“擦写速度快如闪烁”的特性得名,经市场传播固定为通用称呼。)
2.SSD 与机械硬盘对比
内部结构差异

- 机械硬盘:
由盘片、磁头、电机等机械部件构成,读写基本单位是扇区(Sector)(通常 512B 或 4KB ),磁头通过寻道、旋转盘片,定位到对应扇区完成数据读写; - SSD 固态硬盘:
基于闪存芯片,读写单位是页(Page,通常 4KB - 16KB ),擦除单位是块(Block,包含多个页 ) 。
因闪存特性,写入前需先擦除块(擦除后页才能写入新数据 ),且擦除时要把块内有效数据先迁移到其他空闲块,这是 SSD 特有的“写前擦除”流程,和机械硬盘完全不同 。
读写特性差异
- 机械硬盘:
- 读写靠磁头寻道,有机械运动,随机读写慢,且磁头易磨损,读写次数多会影响寿命 。
- SSD 固态硬盘:
- 靠电控制访问位置,随机访问时间短,读写性能好;但存在“一个块被擦写过多次(重复写同一块 )可能会坏掉”的情况,不过寿命受多种因素影响,合理使用也较耐用 。
其他特性对比
- SSD 安静无噪音、耐摔抗震、能耗低,但成本更高;机械硬盘则相反,因有机械结构,怕震动,有噪音,能耗相对高 。
3.SSD 组成与工作原理
组成
- 闪存翻译层:负责翻译逻辑块号,找到对应页(Page )。
- 存储介质:多个闪存芯片(Flash Chip ),每个芯片包含多个块(block ),每个块包含多个页(page ) 。
- I/O 总线:用于数据传输等操作 。
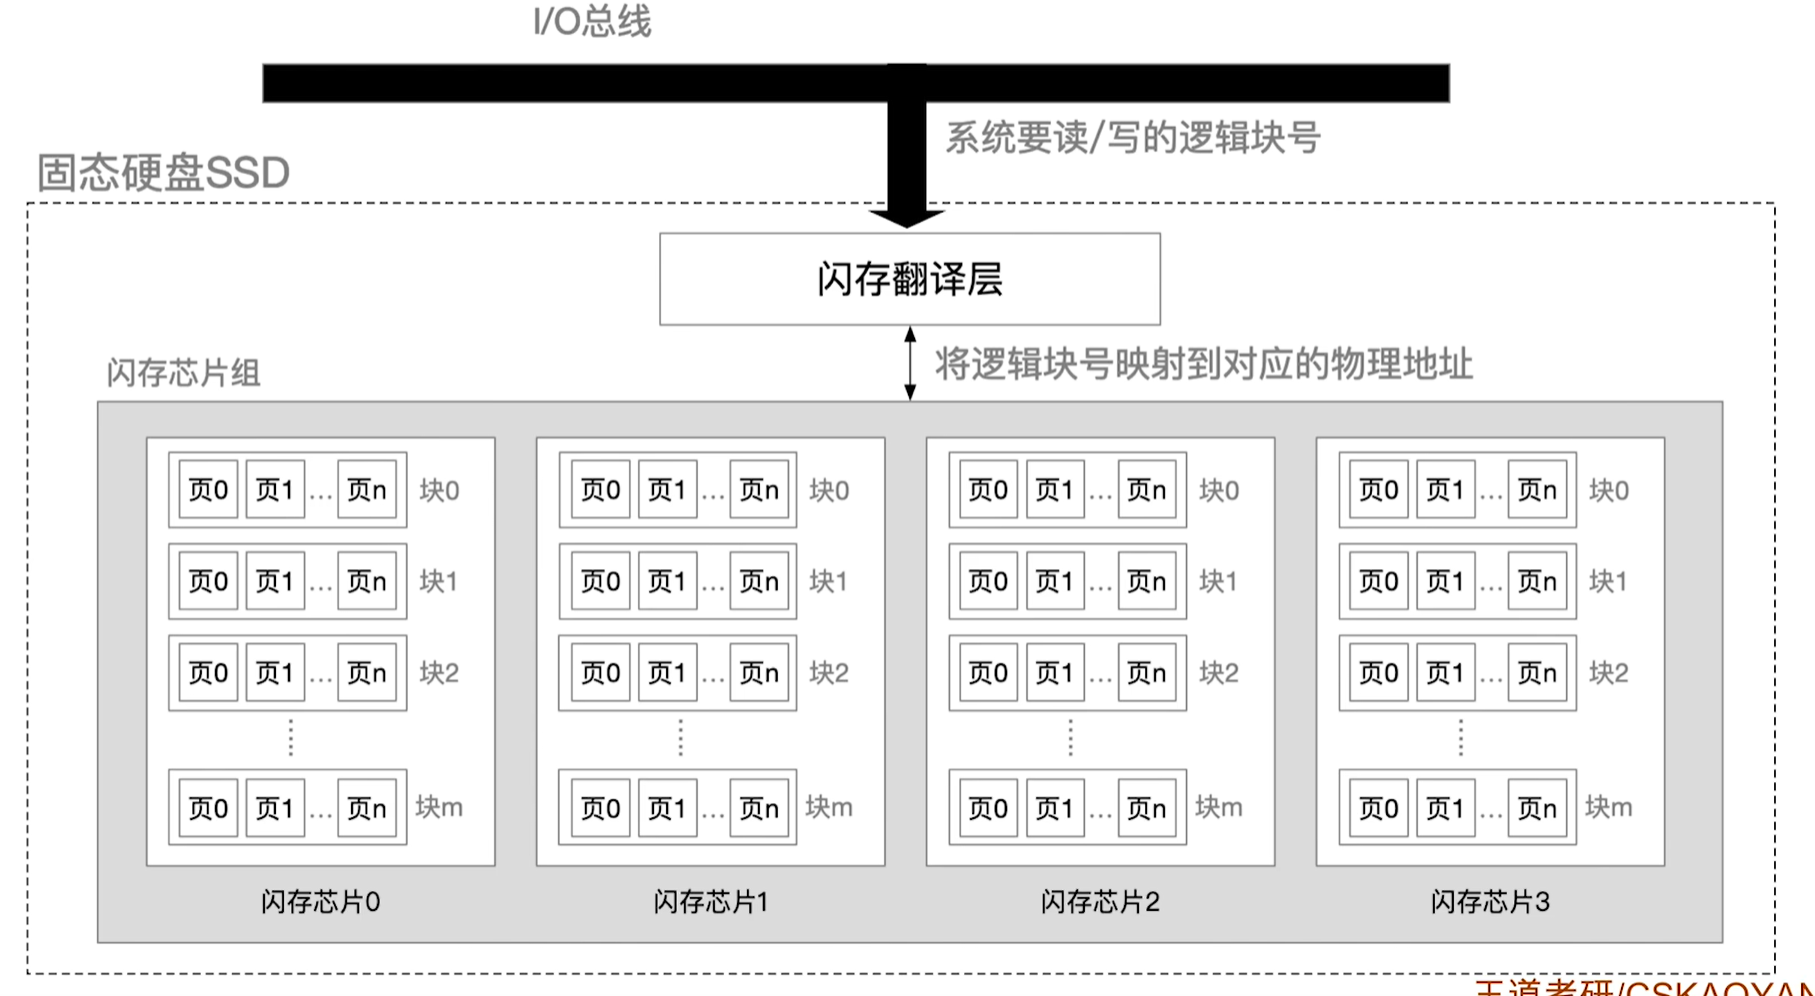

工作流程
- 系统要读/写逻辑块号,经闪存翻译层,将逻辑块号映射到对应的物理地址。
- 存在“磨损均衡”需求:
- 若一直写同一物理块,该块易坏,所以要把数据迁移到其他闪存芯片(新位置也需是“擦干净”状态 )。
- 迁移时,块的编号与页的编号要和原来一致,在迁移的对应页中写入数据,再擦除原来块的位置,同时,逻辑块号对应的物理地址也会改变,映射到新的物理地址。
- 这里逻辑块号所映射的物理地址是可变化的,以此实现磨损均衡,延长 SSD 寿命 。
磨损均衡技术
- 动态磨损均衡:写入数据时,优先选累计擦除次数少的块/闪存块 。
- 静态磨损均衡:SSD 空闲时对数据重排、迁移,让老的/访问少的块来承担以读为主的存储任务,让新擦除的块承担更多写任务 ,目的是让各个块的擦写次数尽量均匀,提升整体使用寿命 。
八、Cache
(一)Cache 存在的背景——存储系统问题
在双端口 RAM 应用、多级存储体系架构下,存储系统面临 核心矛盾:CPU 高性能需求 与 存储设备性能短板 不匹配,具体体现为以下问题:
1.带宽供需失衡问题
CPU 运算速度持续提升(如高频多核处理器),但外设与内存间的数据传输通道(带宽)有限。
- 表现:CPU 处理完数据,需等待外设/内存缓慢传输新数据,形成“运算空转”;或大量数据涌入时,通道拥堵导致传输延迟剧增。
- 本质:信息流量(CPU 与外设交互的数据量)和带宽(单位时间传输速率)不匹配,限制系统整体效率。
2.存储容量与速度的“剪刀差”问题
存储设备存在 速度 - 容量负相关 特性:
- 高速存储(如寄存器、SRAM):速度接近 CPU 运算周期(ns 级),但成本高、容量极小(寄存器通常几十 - 几百字节,SRAM 缓存也仅 MB 级)。
- 低速存储(如硬盘、SSD):容量可达 TB 级,但读写延迟高(硬盘 ms 级,SSD 虽低但仍比 SRAM 慢百倍)。
- 矛盾:CPU 需高频访问数据,却受限于高速存储容量;大容量存储又因速度慢,无法及时响应 CPU 需求,形成“容量够的速度不够,速度够的容量不够”的两极分化。
3.程序访问的“局部性浪费”问题
程序运行遵循 局部性原理(时间局部性:近期访问数据可能再次访问;空间局部性:访问数据的邻近区域可能被访问),但传统存储体系未针对性优化:
- 表现:CPU 频繁访问少量“热点数据”,却需从低速存储全量加载,导致大量无关数据占用带宽和高速存储资源,形成“层次热点”。
- 本质:存储体系未对“局部性数据”做高效缓存,浪费高速存储容量,也让 CPU 承受不必要的延迟。
(二)Cache 工作原理
Cache(高速缓存)是 解决存储系统矛盾的核心技术,通过“数据分层缓存 + 局部性利用”,弥合 CPU 与存储设备的性能 gap。
1.基本逻辑
Cache 作为 CPU 与内存(主存)间的高速缓冲层(通常用 SRAM 实现,速度接近 CPU),遵循以下流程:
访问优先查 Cache:CPU 读取数据时,先检查 Cache 中是否存在。
- 命中:直接从 Cache 快速读取(ns 级延迟)。
- 未命中:从内存加载数据块到 Cache,再供 CPU 使用(需处理“替换策略”,后续展开)。
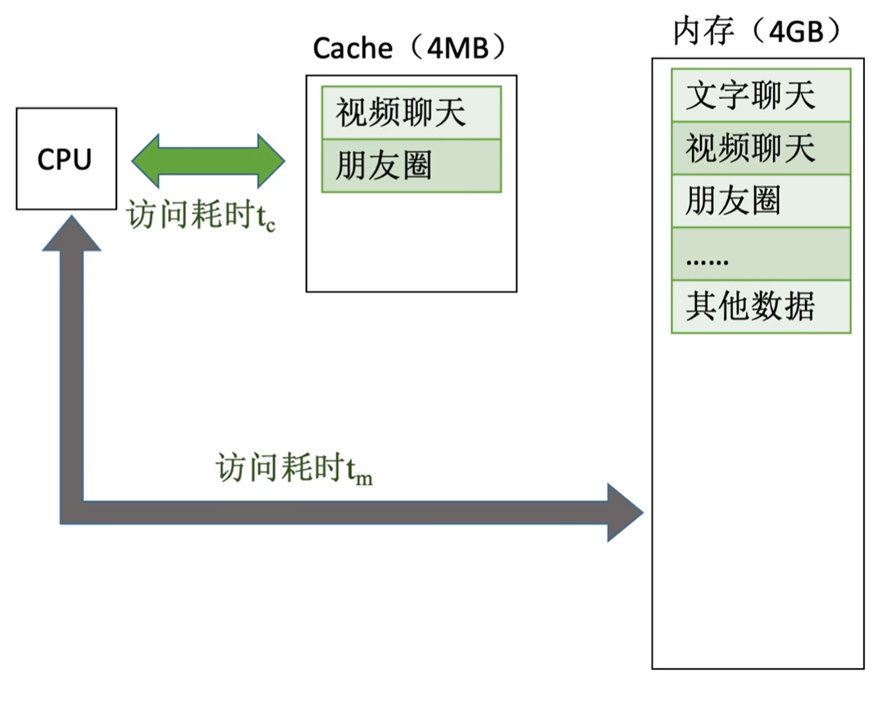
结合示意图理解数据流向:

2.性能分析
-
用 命中率(Hit Rate) 衡量 Cache 效率,公式:
H = N cache命中次数 N cache命中次数 + N 内存访问次数 H = \frac{N_{\text{cache命中次数}}}{N_{\text{cache命中次数}} + N_{\text{内存访问次数}}} H=Ncache命中次数+N内存访问次数Ncache命中次数- 理想状态:命中率越高,CPU 访问数据越接近“无延迟”,系统性能越好。
- 实际影响因素:程序局部性强弱、Cache 容量大小、替换策略优劣、映射方式设计等。
-
平均访问时间( t t t)
根据 访问策略 不同,平均访问时间有两种计算逻辑:-
串行访问(先查 Cache,未命中再查主存):
t = H ⋅ t c + ( 1 − H ) ⋅ ( t c + t m ) t = H \cdot t_c + (1 - H) \cdot (t_c + t_m) t=H⋅tc+(1−H)⋅(tc+tm) -
并行访问模型(同时查 Cache 和主存,命中则终止主存访问):
t = H ⋅ t c + ( 1 − H ) ⋅ t m t = H \cdot t_c + (1 - H) \cdot t_m t=H⋅tc+(1−H)⋅tm
-

(三)Cache——主存
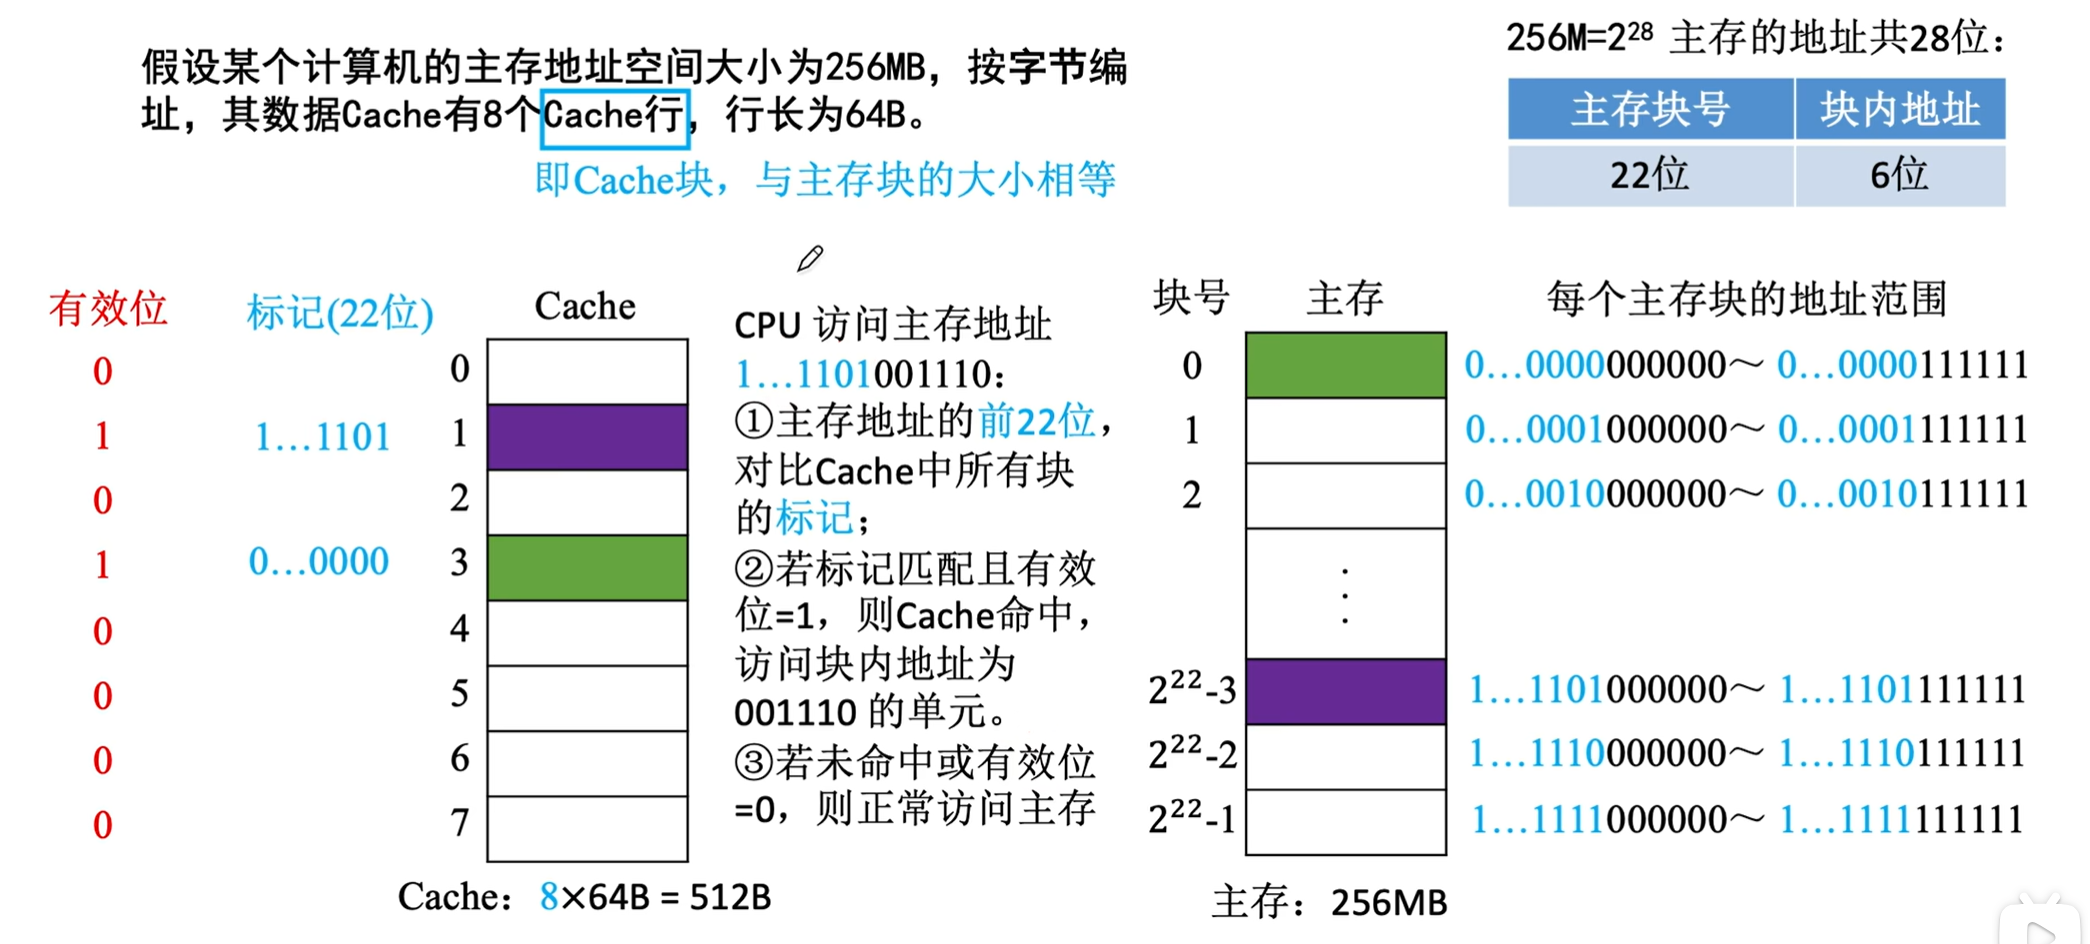
基于局部性原理,为高效利用 Cache 缓存“热点数据”,主存与 Cache 之间以“块”为单位进行数据交换 。
1.块的定义与划分

- 主存分块:将主存存储空间按固定大小“分块”(如示例中每 1KB 为一块 )。
- 若主存地址共 22 位(如4MB 主存, 4 M = 2 22 4M = 2^{22} 4M=222 ),块内地址占 10 位(对应 1 K = 2 10 1K = 2^{10} 1K=210 大小 ),则块号占 12 位( 22 − 10 = 12 22 - 10 = 12 22−10=12 ),主存总块数为 2 12 = 4096 2^{12} = 4096 212=4096 块 。
- Cache 分块:Cache 也按相同大小分块(行),如示例中 Cache 为 8KB,每块 1KB,则 Cache 共 8 K / 1 K = 8 8K / 1K = 8 8K/1K=8 块(行 )。
2.被访问主存块的调入机制
每次被访问的主存块,一定会被立即调入 Cache 。
规则含义
当 CPU 访问主存某地址时,会先定位到对应主存块(根据地址拆解的块号 ):
- 若该块已在 Cache 中(命中 ):直接从 Cache 读写数据。
- 若该块不在 Cache 中(未命中 ):会立即将整个主存块调入 Cache(前提:Cache 有空闲块;若满则触发“替换策略”,淘汰旧块后调入 )。
与局部性原理的关联
程序访问具有时间局部性(近期访问数据可能再次访问 )和空间局部性(访问数据的邻近区域可能被访问 ):
- 调入“被访问主存块”时,相当于把 CPU 近期/邻近可能访问的数据,提前缓存到 Cache,利用局部性原理提升后续访问效率。
(四)Cache与主存的映射方式
为高效利用 Cache 容量,主存与 Cache 以 “块” 为单位交互(如每块 1KB),数据交换时整“块”搬运。常见映射策略如下:
1.全相联映射
- 规则:主存中任意一块,可放入 Cache 任意一块位置。
- 优势:灵活性高,理论命中率最优(只要 Cache 有空间,就能缓存热点块)。
- 劣势:硬件实现复杂(需遍历所有 Cache 块查找数据),访存延迟高(实际难用于大 Cache)。

2.直接映射
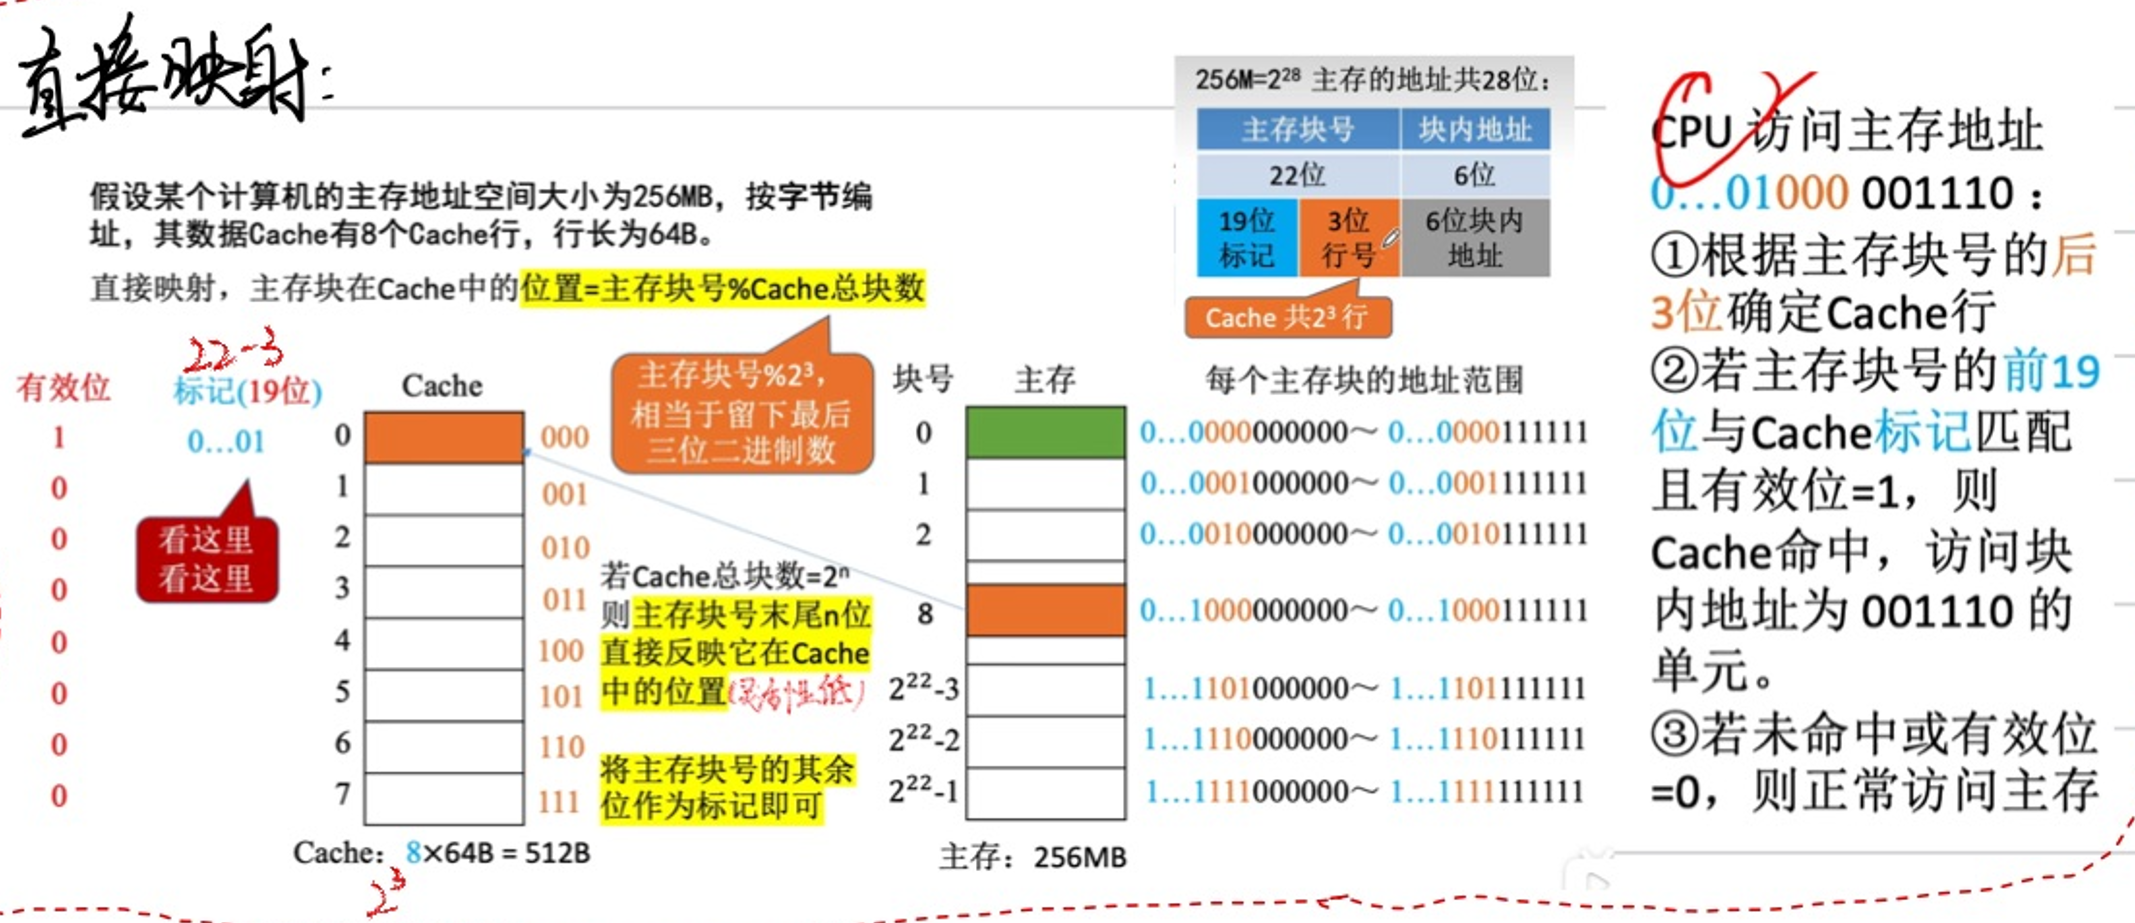
- 规则:主存块号对 Cache 块数取模,强制对应唯一 Cache 块(如主存块号 i i i,Cache 块数 n n n,则 Cache 块号 = i % n i \% n i%n)。
- 优势:硬件实现简单(无需遍历,直接计算地址),访存延迟低。
- 劣势:易冲突(同余数的主存块竞争同一块 Cache),可能降低命中率(如循环访问不同主存块,却共享同一 Cache 块)。

3.组相联映射
- 规则:先将主存和 Cache 分组,主存块按“组号”映射到 Cache 对应组,组内块可全相联(块能放组内任意位置)。
流程:主存块号 → 组号(主存块号对“组数”取模)→ 组内全相联查找。 - 优势:平衡直接映射(硬件简单)与全相联(命中率高)的优点,实际系统中应用最广(如 CPU 缓存多为组相联)。
- 示例逻辑:
- CPU 访问地址拆解:
主存块号(找组) + 组内块号 + 块内地址 - 先定位 Cache 组,再在组内遍历查找数据。
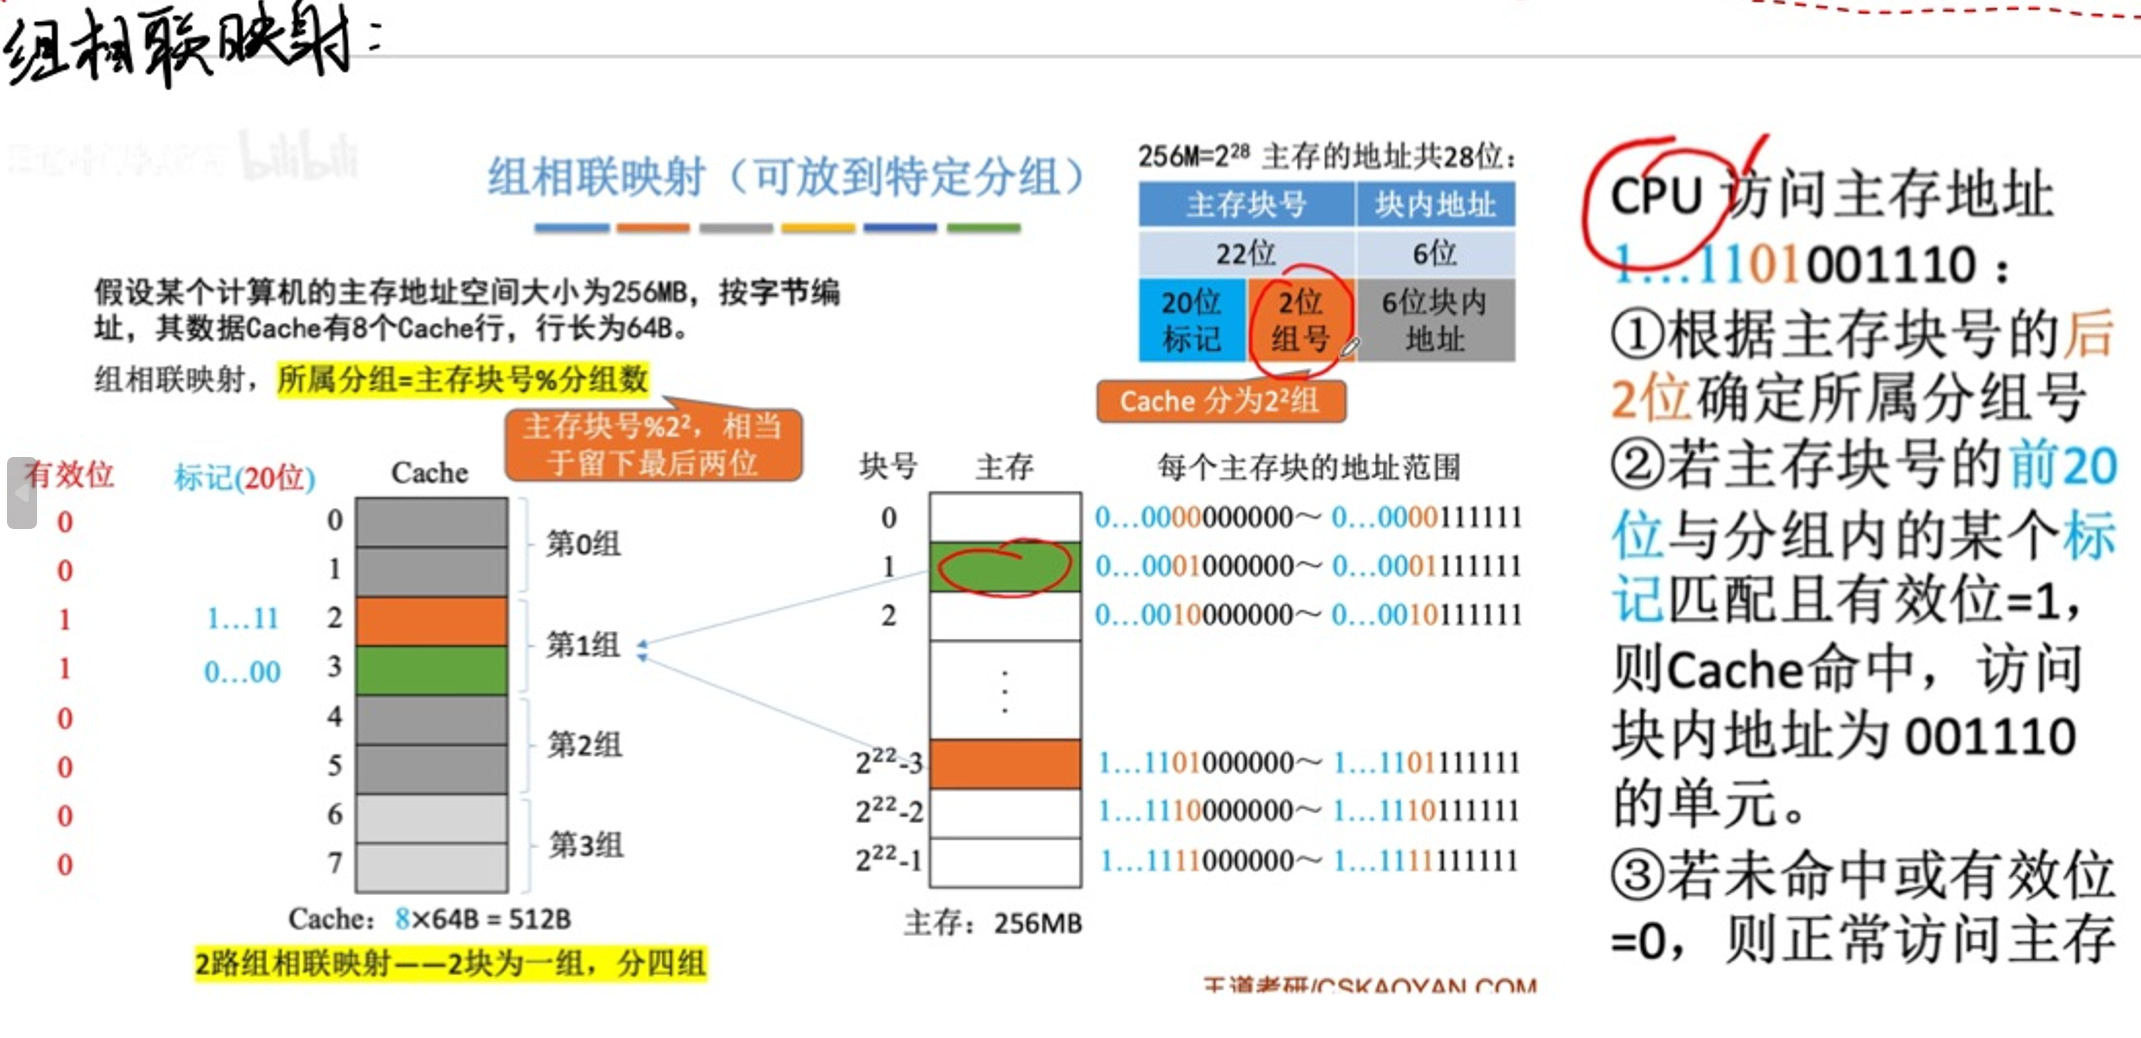
- CPU 访问地址拆解:

(五)Cache替换算法
Cache 替换算法是解决 Cache 满时,如何选择淘汰块的策略,直接影响 Cache 命中率和系统性能。核心目标是利用程序局部性原理,优先保留“未来可能被访问”的块,减少未命中次数。
1.算法分类与原理
随机算法(RAND, Random)
- 规则:Cache 满时,随机选一块替换。
- 特点:
- 实现最简单,无需记录访问历史。
- 缺点:完全不考虑局部性原理,可能淘汰“高频访问块”,命中率低、性能不稳定。
先进先出算法(FIFO, First In First Out)
- 规则:Cache 满时,淘汰最先被调入的块(按调入顺序,“队首”块被淘汰 )。
- 特点:
- 实现简单(维护调入顺序队列即可 )。
- 缺点:未利用局部性原理,最早调入的块可能仍是“高频访问块”(如循环访问数据 )。
- 抖动现象:频繁出现“刚被替换的块又被调入”的情况(因未区分访问频率 )。
近期最少使用算法(LRU, Least Recently Used)
- 规则:为每个 Cache 块设计数器,记录“多久未被访问”;Cache 满时,淘汰计数器最大(最久未用 ) 的块。
- 原理:基于局部性原理,认为“近期被访问的块,未来更可能被访问”。
- 示例流程(4 个 Cache 块,访问序列
1,2,3,4,1,2,5,1,2,3,4,5):
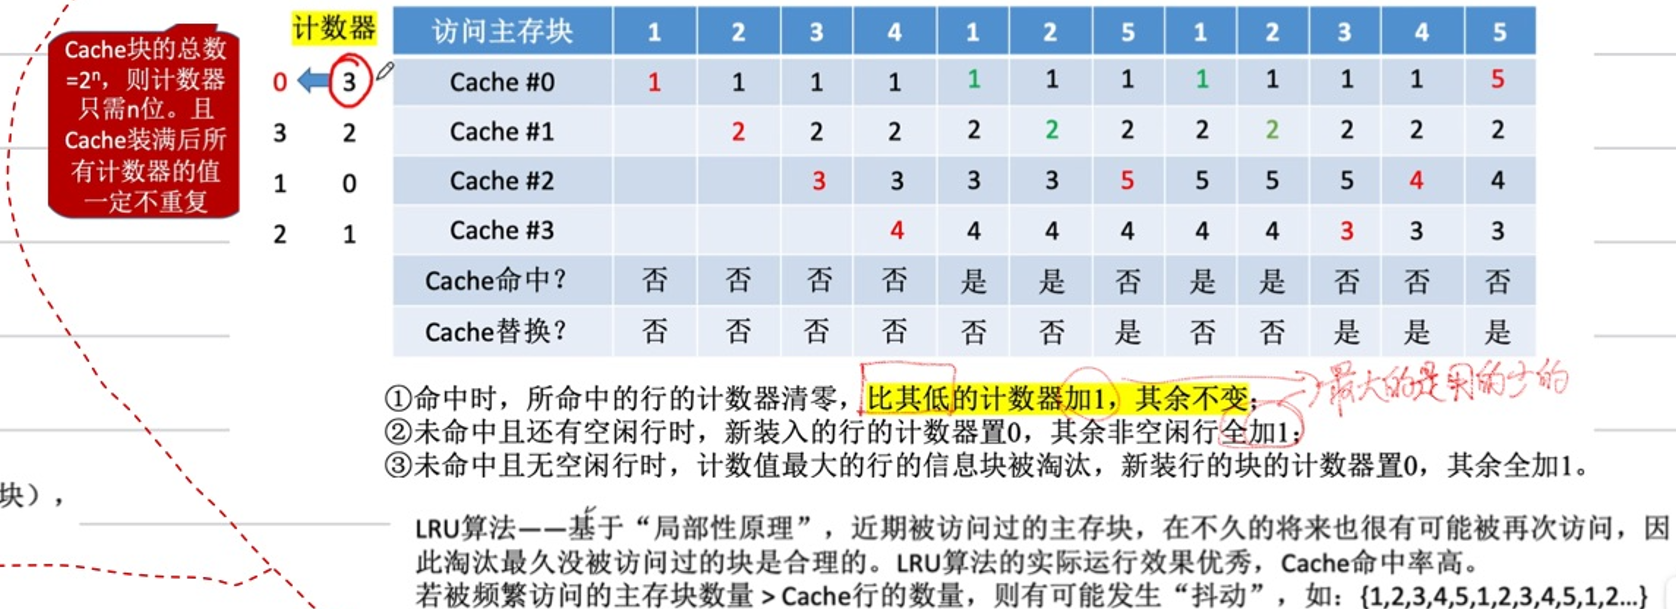
- 特点:命中率高,贴合局部性原理,但需硬件维护计数器(复杂度较高 )。

最不经常使用算法(LFU, Least Frequently Used)
- 规则:为每个 Cache 块设计数器,记录“被访问总次数”;Cache 满时,淘汰计数器最小(访问次数最少 ) 的块。
- 示例流程(4 个 Cache 块,访问序列
1,2,3,4,1,2,5,1,2,3,4,5):
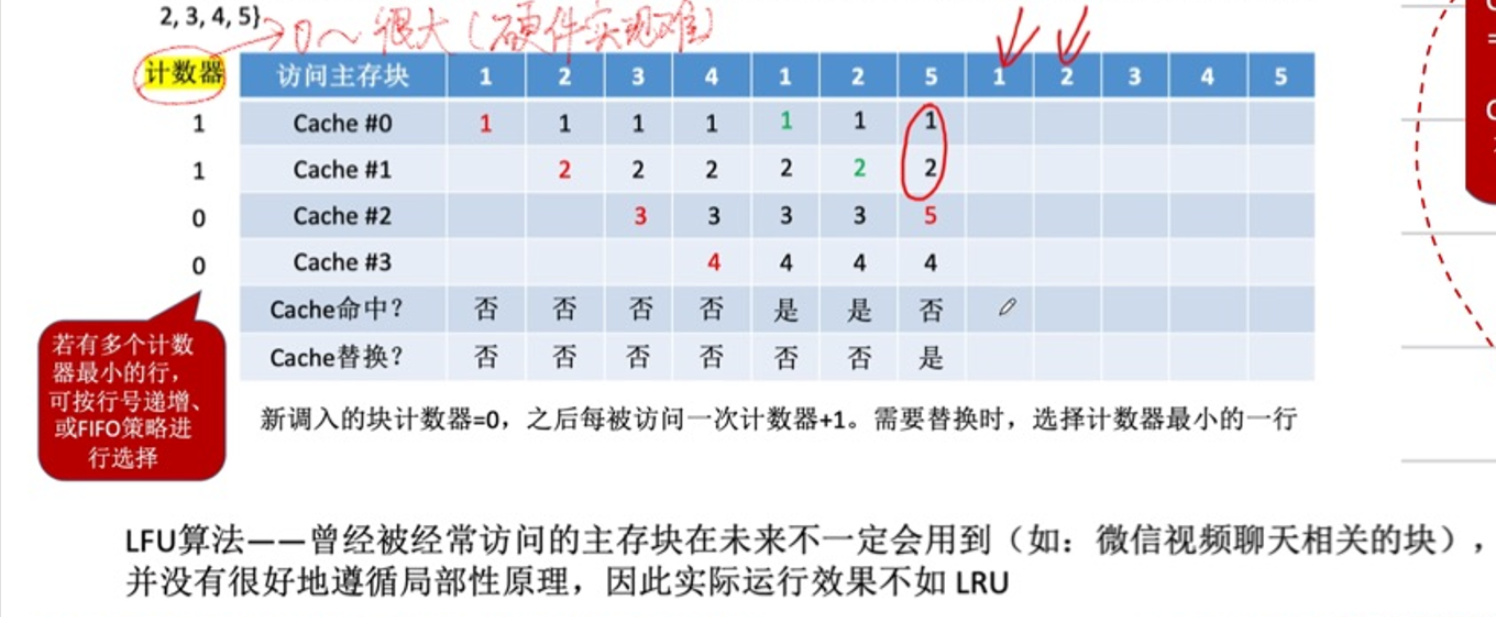
- 缺点:未区分“近期访问”和“历史访问”,可能淘汰“曾经少用但近期需要”的块(如微信视频聊天块长期少用,但突然需要时被误删 ),实际效果不如 LRU。

(六)Cache写策略
Cache 写策略分为 写命中(CPU 写 Cache 中已有的数据)和 写不命中(CPU 写 Cache 中没有的数据),不同场景对应不同策略。
1.写命中策略
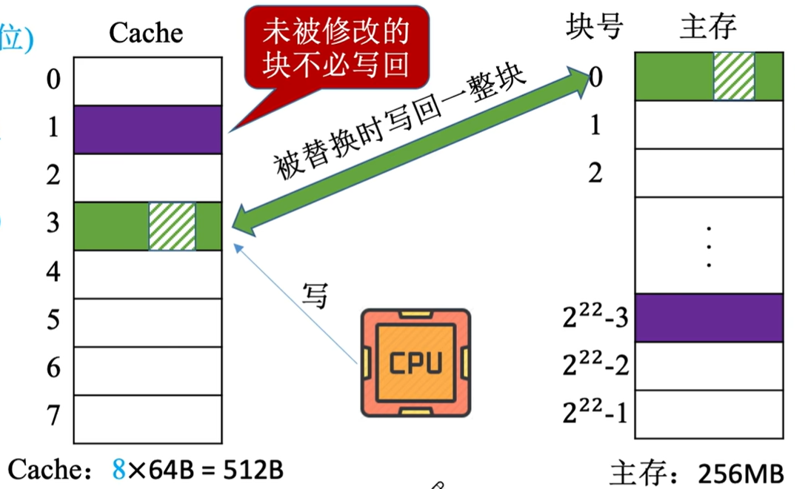
写回法(Write-Back)
- 规则:CPU 写 Cache 命中时,只修改 Cache 内容,不立即写回主存;当该块被替换(从 Cache 淘汰)时,才写回主存。
- 关键标记:需为 Cache 块设置 脏位(Dirty Bit),标记“是否被 CPU 修改过”(脏位=1 表示需写回主存 )。
- 优点:减少主存写操作(仅替换时写回 ),提升写速度,降低主存带宽压力。
- 缺点:存在“Cache 与主存数据不一致”风险(若系统崩溃,未写回的数据会丢失 )。
- 示意图:

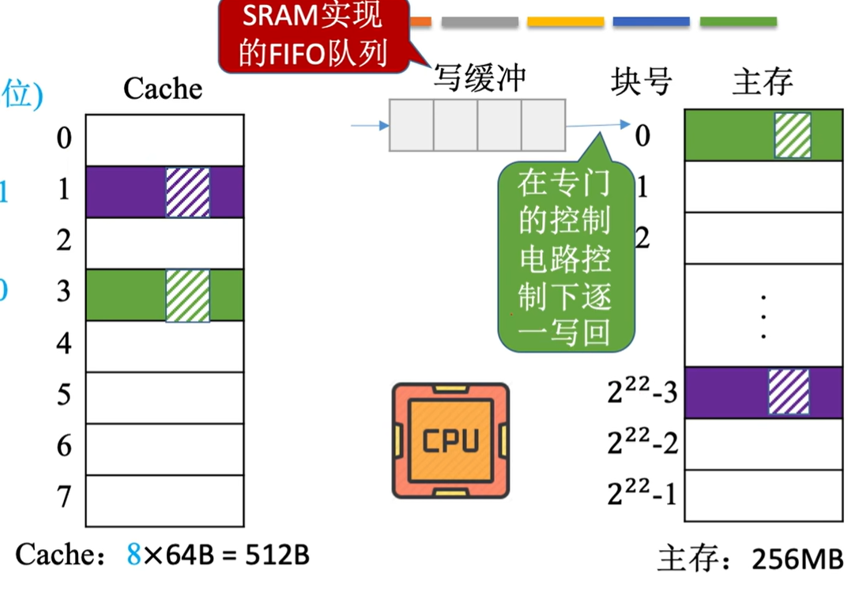
全写法/写直通法(Write-Through)
- 规则:CPU 写 Cache 命中时,同时修改 Cache 和主存(数据立即同步到主存 )。
- 优化:通常配合 写缓冲(Write Buffer),CPU 把数据写入 Cache 和写缓冲后即可继续执行,写缓冲异步写回主存,减少 CPU 等待时间。
- 优点:保证 Cache 与主存数据实时一致,无需脏位,硬件实现简单。
- 缺点:增加主存写操作(每次写命中都触发 ),若写操作频繁,可能会因为写缓冲饱和而发生阻塞
- 示意图:

2.写不命中策略
写分配法(Write-Allocate)
- 规则:CPU 写 Cache 不命中时,先把主存对应块调入 Cache,再执行写操作(后续按“写命中策略”处理,通常搭配写回法 )。
- 原理:利用空间局部性,调入主存块后,未来可能再次访问该块,提升后续命中率。
- 适用场景:搭配写回法时,可减少主存写次数(因写操作先缓存到 Cache )。
非写分配法/不按写分配(Not-Write-Allocate)
- 规则:CPU 写 Cache 不命中时,直接写回主存,不调入 Cache。
- 原理:避免因“写操作”频繁调入不常用块,占用 Cache 空间(适合写操作多、局部性弱的场景 )。
- 适用场景:通常搭配全写法使用(因全写法本身需同步主存,调入 Cache 无明显收益 )。
(七)多级Cache


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)