【人工智能训练师3级】考试准备(2026)三、实操题1.1.3-3.2.5
·
函数速查表
注意标记仅理解,不是考试需要填写的内容,供理解代码
| 章节 | 函数 | 代码 |
|---|---|---|
| 1.1.3 | isnull()创建一个和数据表结构相同的表,值为是否缺失,这里sum()为按列求和 | data.isnull().sum() |
| 1.1.3 | .duplicated()创建和数据表行数相同的列表,记录每一行是否和它前面任意行,整行值都相等 | data.duplicated().sum() |
| 1.1.3 | .between()返回bool值,判断对应值是否符合指定开区间 | data[‘Age’].between(18, 70) |
| 1.1.3-仅理解 | .all()用来判断是否所有值均为True,返回bool值,axis=1表示判断范围是按行判断 | data[[‘is_age_valid’, ‘is_income_valid’, ‘is_loan_amount_valid’, ‘is_credit_score_valid’]].all(axis=1) |
| 1.1.3-仅理解 | 用于统计数据表的通用指标 | .describe() |
| 1.1.3-仅理解 | 筛选出data[‘is_valid’]的补集组成新表,~表示取反 | data[~data[‘is_valid’]] |
| 1.1.3-仅理解 | 筛选出data[‘is_valid’]值为True的行组成新表 | cleaned_data = data[data[‘is_valid’]] |
| 1.1.4 | .dropna()如果这一行有任意空值,则删除该行,默认传参axis=0删除行,如传1删除列 | data = data.dropna() |
| 1.1.4 | .astype()类型转换为指定类型 | data[‘Age’] = data[‘Age’].astype(int) |
| 1.1.4 | .sort_index()按索引排序,本段代码中按年龄从小到大展示各年龄段总人数 | age_group_counts = data[‘AgeGroup’].value_counts().sort_index() |
| 1.1.4 | z-score公式详见公式部分 | data[‘PurchaseAmount’] = (data[‘PurchaseAmount’] - data[‘PurchaseAmount’].mean()) / data[‘PurchaseAmount’].std() |
| 1.1.5 | groupby取出多个字段时,需要用中括号括起来,需要双层括号 | gender_stats = data.groupby(‘Gender’)[[‘Speed’,‘TravelDistance’,‘TravelTime’]].mean() |
| 2.1.1 | pd.to_numeric把对象列转为数值,error转为Nan,astype如果遇到特殊字符会报错,to_numeric不会 | data[‘horsepower’] = pd.to_numeric(data[‘horsepower’], errors=‘coerce’) |
| 2.1.1‼️ | subset指定了具体需要移除空值的列 | data = data.dropna(subset=[‘horsepower’]) |
| 2.1.1 | scaler.fit_transform可以计算均值 / 标准差(fit),再标准化数据(transform | data[numerical_features] = scaler.fit_transform(data[numerical_features]) |
| 2.1.1 | 划分测试集和训练集,训练集8成 | X_train, X_test, y_train, y_test = train_test_split(x,y,test_size=0.2, random_state=42) |
| 2.1.2 | data.shape返回元组,shape[0]行数,shape[1]列数 | initial_row_count = data.shape[0] #处理前的数据行数 |
| 2.1.2 | drop_duplicates移除重复行,需区分duplicated() | data = data.drop_duplicates() |
| 2.1.2‼️ | concat函数合并dataframe,axis=1说明合并所有列,横向增加,注意Xy需要包中括号 | cleaned_data = pd.concat([X, y], axis=1) |
| 2.1.3 | 计算第一分位值,有25%的数据小于这个值 | Q1 = data[numeric_cols].quantile(0.25) |
| 2.1.3‼️ | 计算四分位距,即50%数据所在的区间 | IQR = Q3 - Q1 |
| 2.1.3 | 筛选并删除所有数值列中超出正常范围(小于 Q1−1.5×IQR 或大于 Q3+1.5×IQR)的异常行 | data_cleaned = data[~((data[numeric_cols] < (Q1 - 1.5 * IQR)) |
| 2.1.4 | encoding指定编码 | data = pd.read_csv(‘medical_data.csv’,encoding=‘gbk’) |
| 2.1.4‼️ | 修改列名 | data.rename(columns={‘病人ID’:‘患者ID’}, inplace=True) |
| 2.1.4 | 新增列计算两个日期相差天数 | data[‘诊断延迟’] = (data[‘诊断日期’] - data[‘就诊日期’]).dt.days |
| 2.1.4 | 处理异常数据 | data = data[(data[‘诊断延迟’] >= 0) & (data[‘年龄’] > 0) & (data[‘年龄’] < 120)] |
| 2.1.4-仅理解 | mac电脑使用,替换从C盘查找字体的代码 | font_path = ‘/Library/Fonts/Arial Unicode.ttf’ |
| 2.1.4‼️ | 绘制柱状图 | treatment_outcome_distribution.plot(kind=‘bar’, stacked=True) |
| 2.1.4‼️ | 绘制散点图 | plt.scatter(data[‘年龄’], data[‘疾病严重程度’]) |
| 2.1.5 | loc中冒号表示所有行,所有行均更新为整数 | data_cleaned.loc[:, ‘Your age’] = pd.to_numeric(data_cleaned[‘Your age’], errors=‘coerce’) |
| 2.1.5‼️ | data.plot.pie使用data的数据绘制饼图,bar是绘制柱状图 | exercise_frequency_counts.plot.pie(autopct=‘%1.1f%%’, startangle=90, colors=plt.cm.Paired.colors) |
| 2.1.5 | to_numeric转为float后再转位整数 | data_cleaned.loc[:, ‘Your age’] = data_cleaned[‘Your age’].astype(int) |
| 2.2.1‼️ | 新建一个学习次数1000次的模型 | model = LogisticRegression(max_iter=1000) |
| 对模型进行训练 | model.fit(X_train, y_train) | |
| 2.2.1‼️ | 新建文件,保存模型,w表示写入文本用,b表示二进制图片模型用 | with open(‘2.2.1_model.pkl’, ‘wb’) as file:pickle.dump(model,file) |
| 2.2.1 | 预测结果 | y_pred = model.predict(X_test) |
| 2.2.1 | score会调用predict并比较预测结果和y_test并打分 | accuracy = model.score(X_test, y_test) |
| 2.2.1‼️ | 违约数据太少,使用smote方法处理数据不平衡 | X_resampled, y_resampled = smote.fit_resample(X_train, y_train) |
| 2.2.2‼️ | 排除了文本类型值,这里取多列要用两层方括号 | X = df[[‘cylinders’, ‘displacement’, ‘horsepower’, ‘weight’, ‘acceleration’, ‘model year’, ‘origin’]] |
| 2.2.2 | 创建管道做归一化和模型训练 | pipeline = Pipeline([(‘scaler’, StandardScaler()),(‘linreg’, LinearRegression())]) |
| 2.2.2 | 使用管道训练模型 | pipeline.fit(X_train, y_train) |
| 2.2.3‼️ | 随机森林-100颗决策树 | rf_model = RandomForestRegressor(n_estimators=100, random_state=42) |
| 🔥2.2.3 | 将X中的标签内容,按值拆成 | X = pd.get_dummies(X) # 将分类变量转为数值变量 |
| 2.2.3 | lamba表达式 | y = df[‘Your Age’].apply(lambda x: int(x.split(’ ')[0])) # 假设年龄段为整数 |
| 2.2.3 | 删除指定列 | data_cleaned = data.drop(columns=[‘序号’, ‘所用时间’]) |
| 2.2.3 | 删除target列 | X = data_cleaned.drop(columns=[target]) |
| 2.2.3 | 保存模型 | joblib.dump(model, model_filename) |
| 2.2.4 | 计算均分方差,(真实-预测)的平方 | mse = mean_squared_error(y_test, y_pred) |
| 2.2.4🔥 | 计算决定系数,衡量模型预测能力,注意真实值在前 | r2 = r2_score(y_test, y_pred) |
| 2.2.4🔥 | 初始化XGBoost模型,学习率,最大深度 | xgb_model = xgb.XGBRegressor(n_estimators=1000,learning_rate=0.05,max_depth=5, random_state=42) |
| 2.2.4 | # 使用制表符分隔值保存到文本文件 | results.to_csv(results_filename, index=False, sep=‘\t’) |
| 3.2.1🔥 | 图片模型推理会话加载 | session = ort.InferenceSession(“resnet.onnx”) |
| 3.2.1🔥 | 获取排名前五概率的索引值 | top5_idx = np.argsort(probabilities[0]) [-5:][::-1] |
| 3.2.1 | 获取概率 | top5_prob = probabilities[0][top5_idx] |
| 3.2.2 | 调整图片大小 | image = image.resize ((28, 28)) # 调整大小为MNIST模型的输入尺寸 2分 |
| 3.2.2 | 图片转换为数组 | image_array = np.array ( image , dtype=np.float32) |
| 3.2.2🔥 | 添加维度 | image_array = np.expand_dims ( image_array , axis=0) # 添加batch维度 2分 |
| 3.2.2 | 获取输入 | ort_inputs = { ort_session.get_inputs ()[0].name: image_array} |
| 3.2.2🔥 | 获取概率最大输出 | predicted_class = np.argmax(ort_outs[0]) |
| 3.2.3🔥 | 从情感表中取出预测的对应标签 | predicted_emotion ={v:k for k,v in emotion_table.items() }[predicted_label],另一种写法predicted_emotion = list(emotion_table.keys()) [predicted_label] |
| 3.2.3🔥 | 打开标签文件,r表示读取 | with open(‘labels.txt’,‘r’) as f: |
| 3.2.4🔥 | 以RGB方式打开图片 | image = Image.open(“flower_test.png”).convert(‘RGB’) |
| 3.2.4🔥 | 获取准确率 | accuracy = scipy.special.softmax(output, axis=-1) |
| 3.2.4🔥 | 获取最大概率项 | predicted_idx = np.argmax(accuracy) |
| 3.2.4🔥 | 根据索引值获取准确率 | prob_percentage = prob_percentage = accuracy[0,predicted_idx]*100 |
| 3.2.4 | 从模型预置的标签表中根据索引获取标签 | predicted_label = labels[predicted_idx] |
| 3.2.5🔥 | 从标签表中读取所有标签 | class_names = [name.strip() for name in open(‘voc-model-labels.txt’).readlines()] |
| 3.2.5🔥 | 调用系统命令创建文件夹 | os.makedirs(result_path) |
| 3.2.5🔥 | 使用cv2读取图片 | orig_image = cv2.imread(img_path) |
| 3.2.5🔥 | 缩放图片 | image = cv2.resize(image, (320, 240)) |
| 3.2.5 | 定义用来压缩像素点的均值,127是255的一半 | image_mean = np.array([127, 127, 127]) |
| 3.2.5 | 把数据类型转换成浮点 | image = image.astype(np.float32) |
| 3.2.5 | 图片数据扩展1个维度 | image = np.expand_dims(image, axis=0) |
概念速查表
| 概念名 | 公式内容 | 代码实现 | 公式含义 |
|---|---|---|---|
| Z-score | 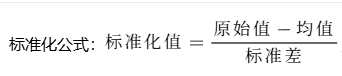 | .mean() 求列均值,.std() 求列标准差 | 统计和均值的离散程度(几个标准差) |
| 准确率评估 | TP:猜对了正类(真・pass) TN:猜对了负类(真・notpass) FP:猜错正类(把notpass说成pass) FN:猜错负类(把pass说成notpass) | ||
| 准确率指标计算 | 准确率 = (TP + TN) / (TP + TN + FP + FN) 精确率 = TP / (TP+FP) 召回率 = TP / (TP+FN) F1 = 2×P×R/(P+R) AUC = 所有 正样本得分 > 负样本得分 的概率(0.5 = 乱猜,1 = 完美) | 准确率:所有预测结果的正确率,精确率:预测为真的准确率,召回率:所有应该为真的样本中,成功预测为真的比例 ,F1:整体表现 |

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献10条内容

所有评论(0)