基于spark的大数据分析预测地震受灾情况的系统设计_基于spark的预测分析

### 2、数据预处理和特征工程
在数据预处理和特征工程阶段,我们将对数据进行清洗、转换和特征提取等操作。具体步骤如下:
数据预处理和特征工程
string_cols = [‘gender_individual’, ‘presence_in_household’, ‘disability_individual’,
‘education_level_individual’,‘marital_status_individual’, ‘legal_ownership_status’,
‘land_surface_condition’, ‘foundation_type’,‘roof_type’, ‘ground_floor_type’,
‘other_floor_type’, ‘position’, ‘plan_configuration’,‘condition_post_eq’,
‘damage_grade_x’, ‘technical_solution_proposed_x’, ‘area_assesed’,
‘technical_solution_proposed_y’,‘vdcmun_name’, ‘district_name’]
创建 StringIndexer 和 OneHotEncoder 对象
indexers = [StringIndexer(inputCol=column, outputCol=column+“_index”,handleInvalid=“skip”) for column in string_cols]
encoder = OneHotEncoder(inputCols=[column+“_index” for column in string_cols],
outputCols=[column+“_encoded” for column in string_cols])
创建特征向量
assembler = VectorAssembler(inputCols=encoder.getOutputCols(), outputCol=“features”)
创建Pipeline
pipeline = Pipeline(stages=indexers + [encoder, assembler])
data_final = pipeline.fit(data).transform(data)
data_final.show()

### 3、异常数据处理
在异常数据处理阶段,我们将处理可能存在的异常情况,确保数据的完整性和准确性:
使用正则表达式提取数字部分
data_final = data_final.withColumn(“damage_grade_y_numeric”, regexp_extract(data_final[“damage_grade_y”], r’\d+', 0))
将列转换为 numeric 类型
data_final = data_final.withColumn(“damage_grade_y_numeric”, data_final[“damage_grade_y_numeric”].cast(“int”))
显示转换后的结果
data_final.select(“damage_grade_y”, “damage_grade_y_numeric”).show()

### 4、标题模型训练和评估
在模型训练和评估阶段,我们将使用随机森林分类器进行模型训练,并评估模型在测试集上的表现:
划分数据集为训练集和测试集
(train_data, test_data) = data_final.randomSplit([0.8, 0.2], seed=1234)
初始化随机森林分类器
rf = RandomForestClassifier(labelCol=“damage_grade_y_numeric”, featuresCol=“features”, numTrees=10)
训练模型
model = rf.fit(train_data)
在测试集上进行预测
predictions = model.transform(test_data)
模型评估
evaluator = MulticlassClassificationEvaluator(labelCol=“damage_grade_y_numeric”, predictionCol=“prediction”, metricName=“accuracy”)
accuracy = evaluator.evaluate(predictions)
print(“Test Accuracy = {:.2f}%”.format(accuracy * 100))

### 标题5、可视化大屏实现与展示
为了更直观地展示预测结果,我们设计了一个可视化大屏。该大屏将包括地图展示、受灾情况分布图以及预测结果展示等内容,以帮助用户更好地理解地震造成的破坏程度。
height: 100%;
background-image: -webkit-radial-gradient(ellipse farthest-corner at center center, #1b44e4 0%, #020f3a 100%);
background-image: radial-gradient(ellipse farthest-corner at center center, #1b44e4 0%, #020f3a 100%);
cursor: move;
}
body {
自我介绍一下,小编13年上海交大毕业,曾经在小公司待过,也去过华为、OPPO等大厂,18年进入阿里一直到现在。
深知大多数Python工程师,想要提升技能,往往是自己摸索成长或者是报班学习,但对于培训机构动则几千的学费,着实压力不小。自己不成体系的自学效果低效又漫长,而且极易碰到天花板技术停滞不前!
因此收集整理了一份《2024年Python开发全套学习资料》,初衷也很简单,就是希望能够帮助到想自学提升又不知道该从何学起的朋友,同时减轻大家的负担。


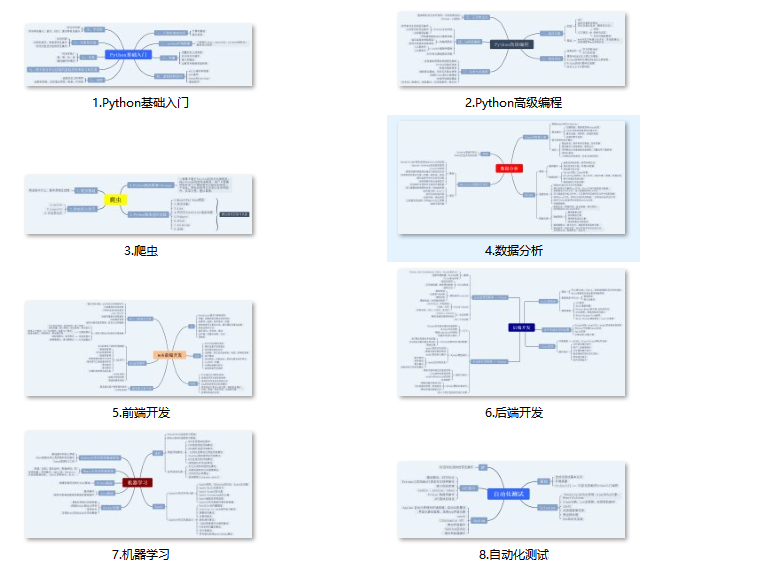
既有适合小白学习的零基础资料,也有适合3年以上经验的小伙伴深入学习提升的进阶课程,基本涵盖了95%以上前端开发知识点,真正体系化!
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以扫码获取!!!(备注Python)
%以上前端开发知识点,真正体系化!**
由于文件比较大,这里只是将部分目录大纲截图出来,每个节点里面都包含大厂面经、学习笔记、源码讲义、实战项目、讲解视频,并且后续会持续更新
如果你觉得这些内容对你有帮助,可以扫码获取!!!(备注Python)


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)