Redis数据结构——zset
目录
zset是有序集合,有序指的是升序或者降序,zset内部是升序的。
那么zset是怎么排序的?我们给zset中的memer同时引入了一个属性分数(score),浮点数,每个member都会安排一个分数,进行排序的时候,就是按照此处的分数大小来进行升序/降序的。
比如下面三国武将和武力值,就是根据武力值进行升序或者降序。
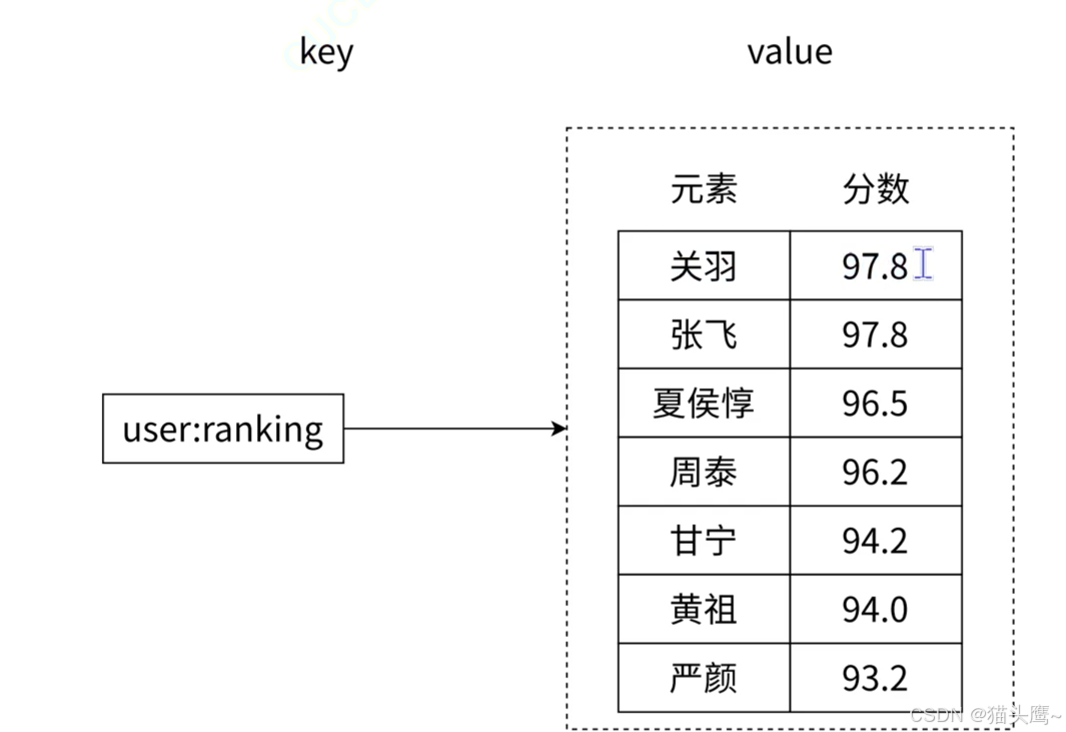
zset虽然是一个有序集合,因此它的member是不能重复的,不能有一个张飞在有一个张飞,但是分数是可以重复的,上述的武将值是可以重复的,如果分数重复了,按照member的字典序排列。
zset主要还是用来存member的,分数只是用来辅助的。
zset命令
zadd
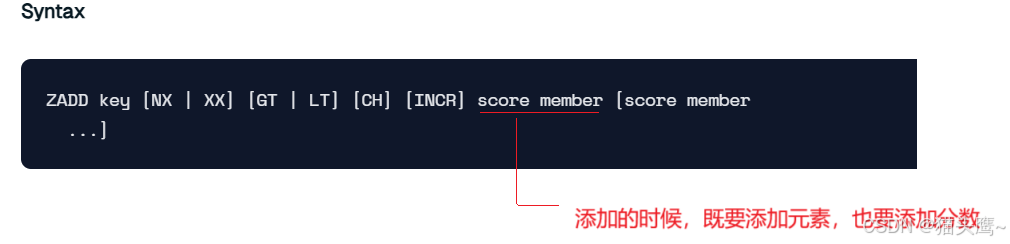
往zset中添加元素和分数,一次可以添加一对也可以添加多对,对于有序集合我们既可以通过member找到score也可以通过score找到member。
语法:
返回值:默认情况是新增成功的元素个数。
如果不加 NX|XX选项的时候,并且当前member不存在,此时就会达到"添加新 member"的效果,如果存在则更新分数。
XX:表示只是更新已经存在的元素,不会添加新的元素。如果不存在操作失败。
NX:表示只是添加新的元素,不会更新已经存在的元素。
LT:更新分数,如果给定新的分数比之前给定的分数小,就更新成功,否则不更新。如果要更新的member不存在则直接添加。
GT:更新分数,如果给定新的分数比之前给定的分数大,就更新成功,否则不更新。如果要更新的member不存在则直接添加。
CH:影响zadd的返回值,普通情况下zadd的返回值是新增元素个数,如果加入CH,返回的值就是新增和修改的和。
INCR:针对现有元素的分数进行运算。
时间复杂度:O(log(N)) 由于zset是有序结构,要求新增的元素要放到合适的位置上(找位置),因此复杂度是O(log(N))。
添加的时候注意一下分数写再前,member写在后。
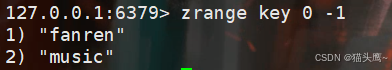
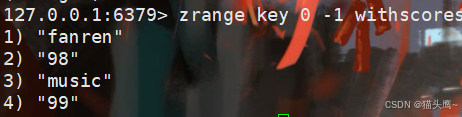
下面就是添加了music 和fanren两个元素,分数分别是99和98。

zrange
查看zset的元素详情。非常类似于lrange,可以指定一对下标构成的区间,把区间内的元素全都搞出来。有序集合,元素本身就是有先后顺序的,谁在前谁在后,都是明确的,因此可以给有序集合下标的概念。
语法:
zrange key start end [withscores]
我们可以看到查询结果是有序的,虽然把成员查出来了,但是没有分数呀,因此可以给zrange添加一个选项withscores。
zadd修改分数:如果member已经存在,再次添加会修改其分数。
下面已经存在了music,之前分数是99,此次直接将music分数修改为了182。

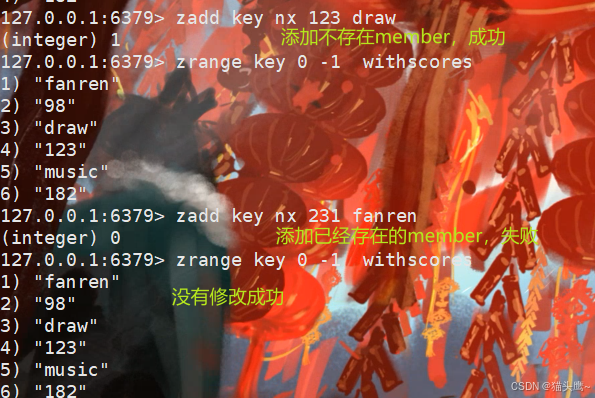
zadd带上NX选项:只能新增,不能修改。
下面draw不存在添加成功,fanren已经存在添加失败。
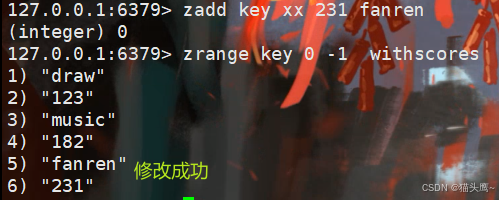
zadd带上XX:只能修改,不能新增
注意zadd返回值默认是新增元素个数,下面是更新操作不是修改,因此返回0是顺理成章的。
下面将fanren从98修改为了231。
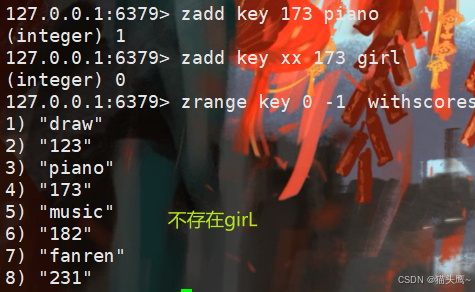
下面操作一个不存在的元素girl,可以看到没有新增成功。
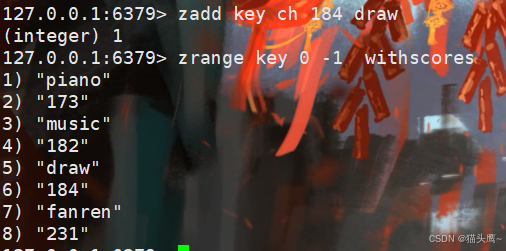
zadd带上CH选项:
此时zadd返回的结果就是新增和修改的总和。
下面返回了1,因为draw存在本次是修改操作,如果不加ch修改的操作是不会计算次数返回的。
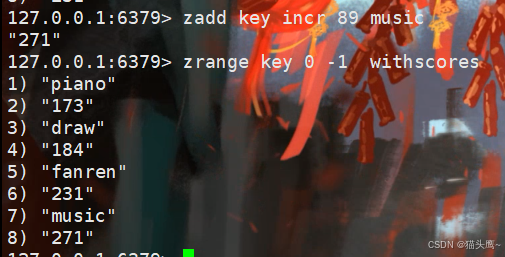
zadd带上INCR选项:
incr后面跟上要加上的分数,返回结果是加上之后的分数。
下面是给music增加了89。
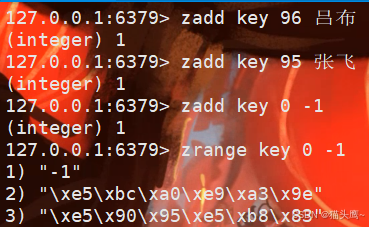
当我们添加的是中文时,我们发现是一堆我们看不懂的,这是因为redis是按照二进制存储的,需要客户端自行识别。
下面我们是按中文名添加的member,此时查看发现全是16进制。
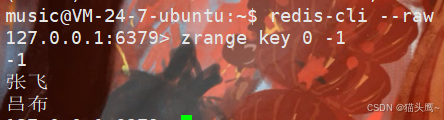
此时我们退出客户端,启动redis的时候后面跟上--raw选项,此时客户端即可解析成功。
zcard
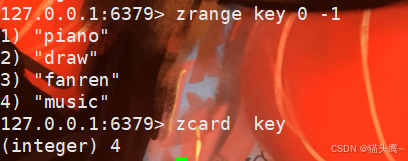
获取zset中的元素个数。
语法:
zcard key
zcount
返回在一个分数区间里的元素个数。
语法:
zcount key min max
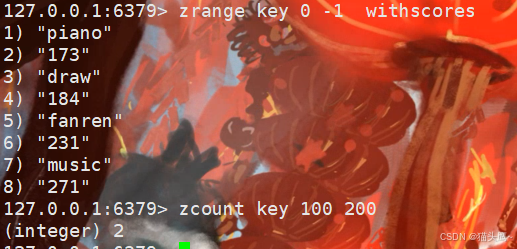
min和max默认是闭区间,包含边界值,如果要排除边界值可以加上括号。min和max都是分数,并且都是可以写成浮点数的,zset的分数也可以是浮点数。
下面就是查看分数在[100,200]之间的有多少个,返回值2,说明有2个,也的确有两个。
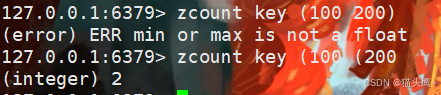
如果要排除100和200呢?在左边加括号即可,(100 (200,如果光排除100,就是(100。
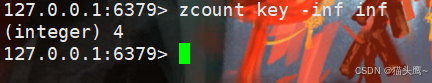
浮点数中存在两个特殊组:inf(无穷大),-inf(负无穷大) 如果min和max给成这两个值,那就是返回所有的元素个数。
时间复杂度:O(logN)
首先肯定需要根据min和max找到对应的元素,然后zset内部会记录每个元素当前的"次序" ,此时就可以把max对应的元素次数和min对应的元素次序做减法接口。
zrevrange
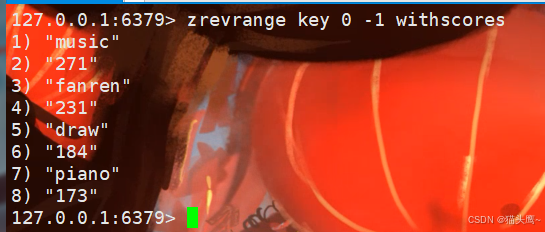
该命令也是返回一段区间的值,只不过是按照分数降序的方式打印的。rev是reverse逆序的意思。
语法:
zrevrange key start stop [withscores]
此处的start和stop都是下标。下面可以看到是按照分数从高到低显示的。
zrangebyscore
按照分数来找元素,给定一组分数作为区间,返回符合区间内的所有member和分数。
语法:
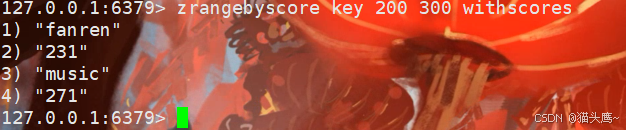
zrangebyscore key min max [withscores]
下面可以看到分数在[200,300]之间的fanren和music以及各自的分数都显示了出来。
zpopmax
删除并返回分数最高的count个元素
语法:
zpopmax key [count]

如果存在多个元素分数相同同时为最大值,popmax怎么删?只删除其中一个元素。 别忘了,它们如果分数相同,会按照字典序排序。
下面张飞和吕布分数相同,删除张飞。
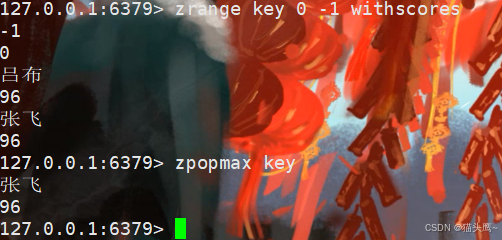
因为zset默认是按照升序排序的,zpopmax是删除zset里的最大元素,这个不就相当于是一个大根堆?因此如果我们有需要可以使用zset来实现大根堆的功能。
bzpopmax
这里的有序集合可以视为一个优先级队列,有的时候也需要一个带有"阻塞功能"的优先级队列,此时我们就可以使用bzpopmax。
语法:
bzpopmax key [key ...] timeout
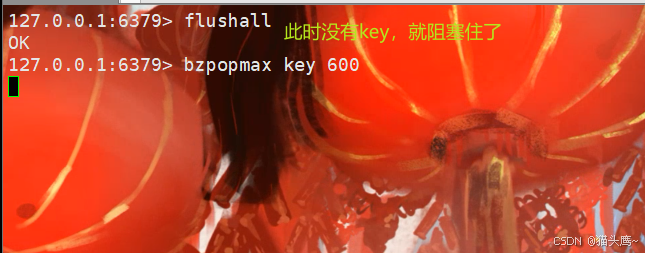
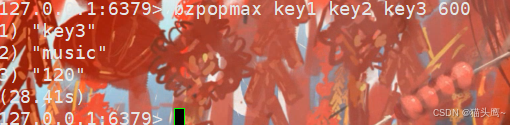
这里的每个key都是一个有序集合,阻塞是在有序集合为空的时候触发阻塞,阻塞到其它客户端插入元素,timeout表示超时时间,最多阻塞多久。这里超时时间的单位是秒,并且是个double类型,因此可以写成0.1这样的形式,写成0.1就是100毫秒。
下面,我们清空数据库,此时bzpopmax肯定会被阻塞。
当我们开启另外一个客户端添加元素之后,立即解除阻塞,删除并返回了score最大的元素。
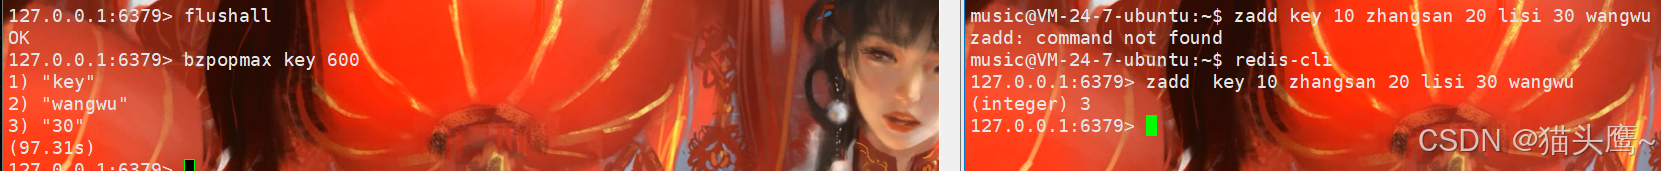
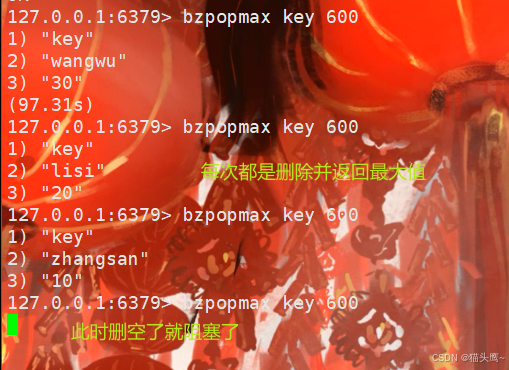
此时如果监控多个key,并不会对这多个key都进行删除,只要有一个key里面有元素了,就删除它并返回。
时间复杂度:O(log(N))
zpopmin
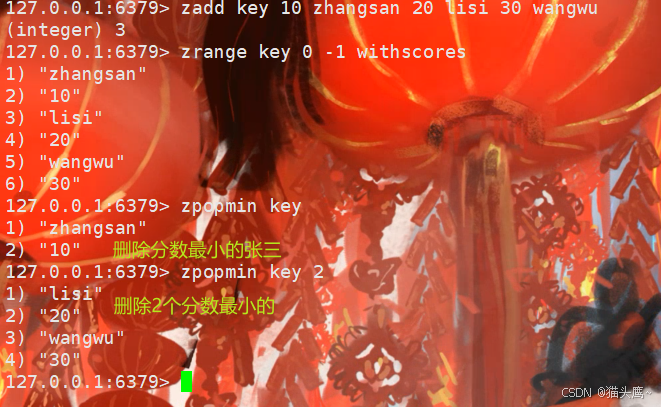
与zpopmax用法相对,删除有序集合中最小的元素。
语法:
zpopmin key [count]
count是指定删除多少个。
时间复杂度:O(longN*M)
bzpopmin
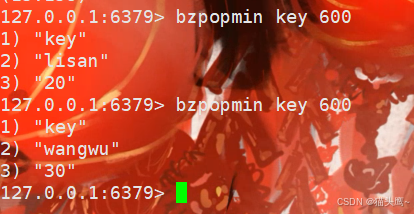
用法和bzpopmax一样。
bzpopmin key [key ...] timeout
针对空的集合会阻塞等待,直到另外一个客户端添加元素。
 如果集合不为空,直接返回。
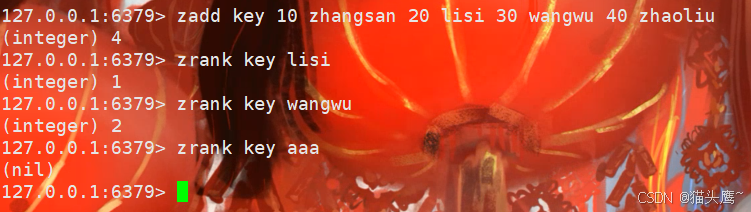
zrank
获取到指定元素的下标
语法:
zrank key member
如果查询一个不存在的,返回nil。
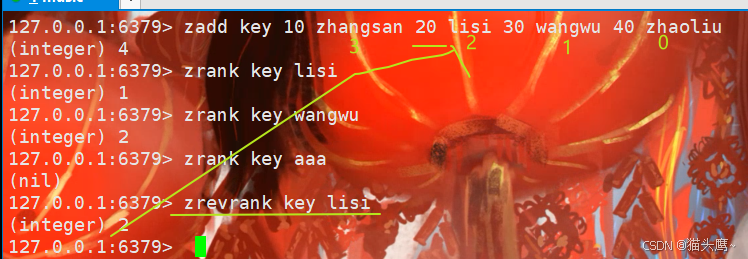
zrevrank
获取到指定元素的下标,不过它获取到的下标是反着的。用法和zrank一样。
zscore
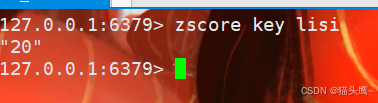
获取到member的分数。
语法:
zscore key member
时间复杂度:O(1)
这里redis对于这样的查询操作进行了特殊优化,付出了额外空间的代价,针对这里进行优化到了O(1)。
zrem
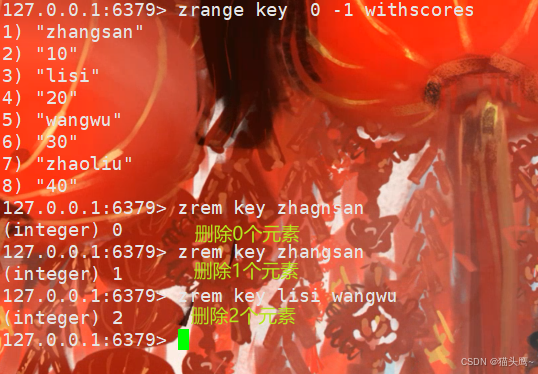
删除指定元素。
zrem key member [member ...]
时间复杂度:O(logN * M) N是有序集合的元素个数,参数是member中的个数。
返回值:删除元素的个数
zremrangebyrank
删除start到end之间的元素。根据下标删除
语法:
zremrangebyrank key start end
时间复杂度:O(logN + M) N是有序集合的元素个数,M是start-stop区间中的元素个数。
返回值:删除元素的个数
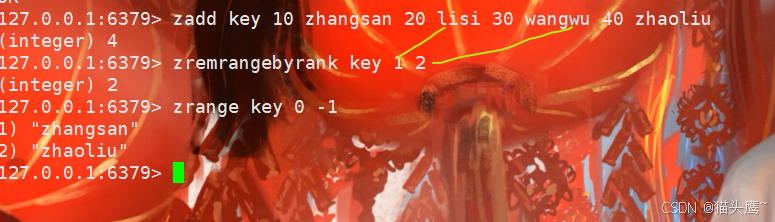
下面将[1,2]下标内的元素全都删除了,也就是lisi和wangwu被删除。
zremrangeyscore
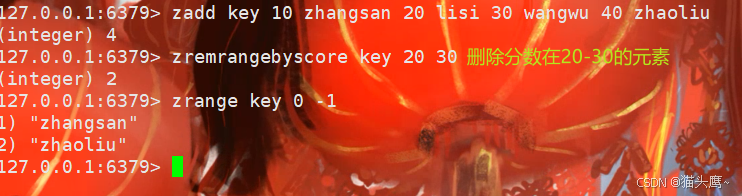
删除一段区间内的元素
这个区间是通过分数来描述的区间, 可以使用括号排除边界值。
语法:
zremrangebyscore key min max
时间复杂度:O(logN + M) N是有序集合的元素个数,M是分数区间中的元素个数。
返回值:删除元素的个数。
zincrby
给有集合中元素的分数进行增加。
语法:
zincrby key increment member
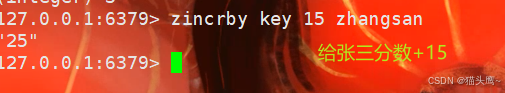
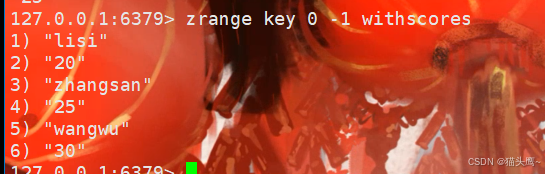
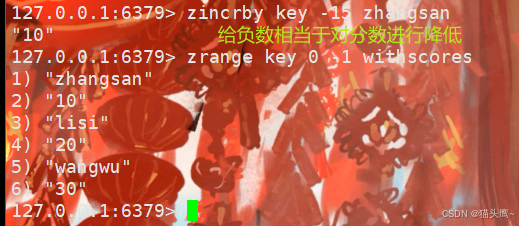
分数进行修改之后它的所在位置也会发生变化。
如果给负数相当于降低分数。
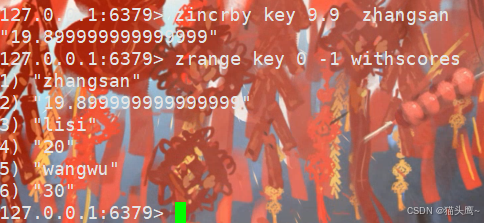
如果给小数呢? 小数也是可以的,因为分数本来就是小数,这个地方出现了精度丢失的问题。
zinterstore
语法:
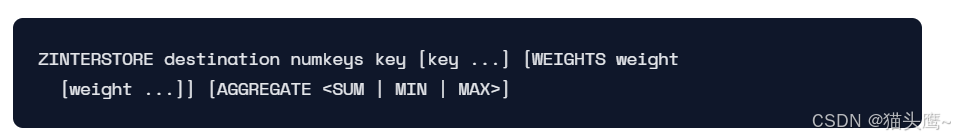
destination:要把结果存储到哪个key对应的zset中。
numkeys:描述了后续有几个key参与交集运算。
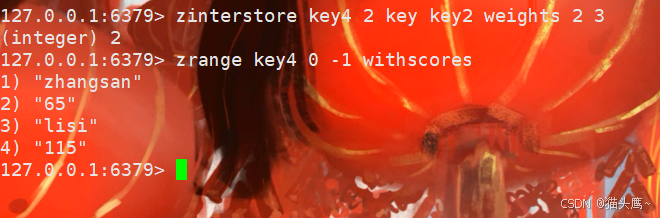
weights:权重,现在的集合是个有序集合,带有分数,好几个集合要求交集,这些集合的地位都是对等的吗?当然不是,此处的权重相当于一个系数,会乘以元素的分数。
aggregate:分数按照什么样的规则进行合并。
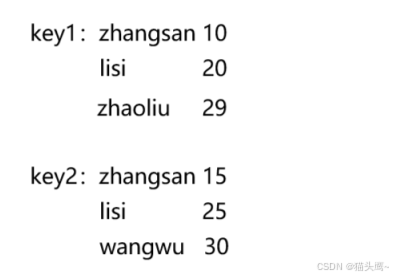
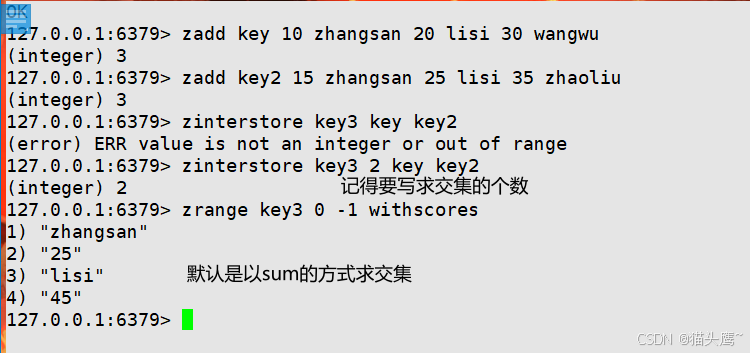
当有两个有序集合,它们有的member一样的时候,此时求交集,分数怎么算呢?比如下面的key1和key2。下面zhangsan,lisi在key1和key2都出现了,此时咋办呢?
此时aggregate这个选项的功能就体现出来了。
如果aggregate是sum,相当于把相同member的分数加起来。
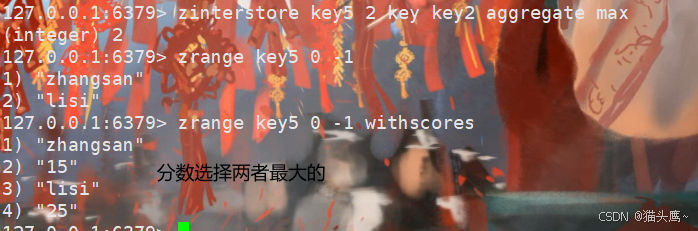
如果aggregate是max,则取member大的。
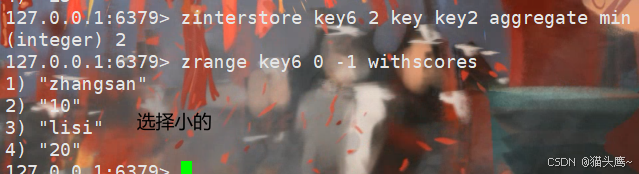
如果aggregate是min,则取member小的。

如果我们什么选项都不带,默认是以sum的方式来对分数进行计算。
下面key张三分数10,李四分数20,key2张三分数15,李四分数25,求交集后,分数就变为了25和45。
携带权重
这里要写weights然后跟上权重,下面跟上了2和3,意思是对key的所有分数乘以2,对key2的分数乘以3,因此下面的分数才是65和115。
以min的方式求交集
以max的方式求交集
zunionstore
求并集
语法:
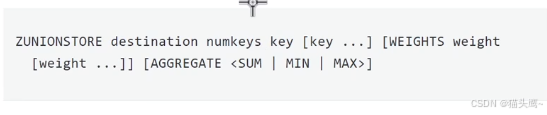
它的用法和zinterstore一样,就不多说了。
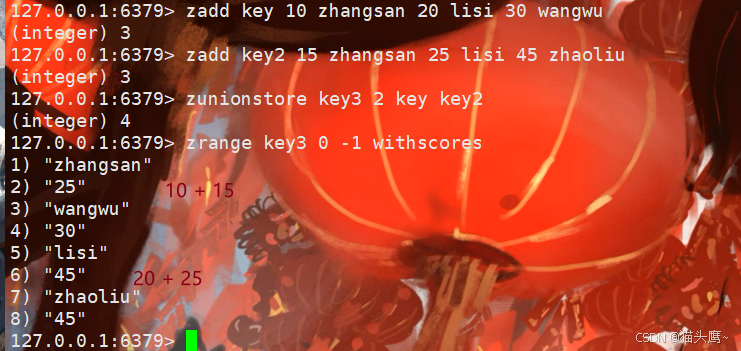
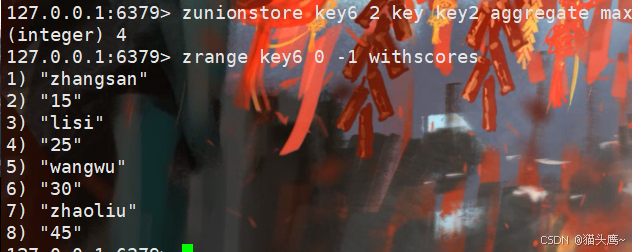
如果我们什么选项都不带,默认是以sum的方式来对分数进行计算。
由于是合并操作,因此key3里面就有4个元素,并且对相同的元素分数进行了累加。
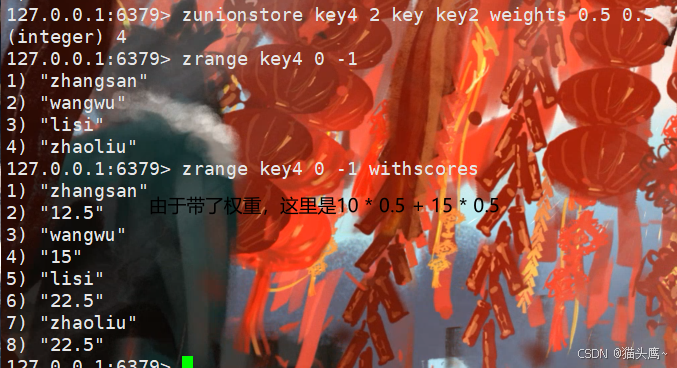
携带权重
下面的权重是0.5和0.5,因此key 和 key2的分数都要乘以0.5,然后元素相同的分数在进行一个合并操作。因此得到的就是如下打印的结果,大家可以自己算一下。
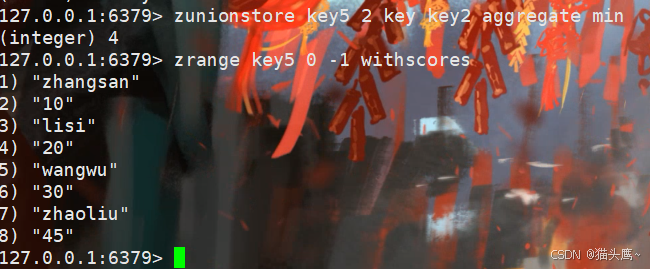
以min的方式进行合并,当元素相同时分数就会选取较小的。
以max的方式进行合并,当元素相同时分数就会选取较大的。
命令总结
| 命令 | 作用 |
| zadd key score member [score member...] | 给集合添加元素 |
| zcard key | 获取元素的长度 |
| zscore key member | 获取到member的分数 |
| zrank key member zrevrank key member | 获取元素下标 |
| zrem key member [member ...] | 删除集合中元素 |
| zincrby key increment member | 修改元素分数 |
| zrange by score keystart end [withscores] zrevrange key start end [withscores] | 查看一段区间元素 |
| zcount key min max | 返回在一个分数区间里的元素个数。 |
| zrangebyscore key min max [withscores] zrevrangebyscore key max min [withscores] | 根据分数划分区间获取指定元素 |
| zremrangebyrank key start end | 删除start到end之间的元素。根据下标删除 |
| zremrangebyscore key min max | 指定一个删除的区间,这个区间是通过分数来描述的区间。 |
| zinterstore destination numkeys key[key ...] | 对多个集合求交集 |
| zunionstore destination numkeys key[key ...] | 对多个集合求并集 |
编码格式
如果有序集合中的元素个数较少,或者单个元素体积较少,使用ziplist来存储。
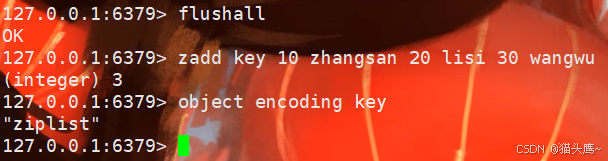
如果当前元素个数比较多,或者单个元素体积非常大,使用skiplist来存储。


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 12
 0
- 0


 已为社区贡献2条内容

所有评论(0)