李宏毅2022机器学习笔记(6)——RNN
1、RNN基本概念
对于一些复杂的文本或语言,需要获取文本中的关键部分,例如目的地,时间等
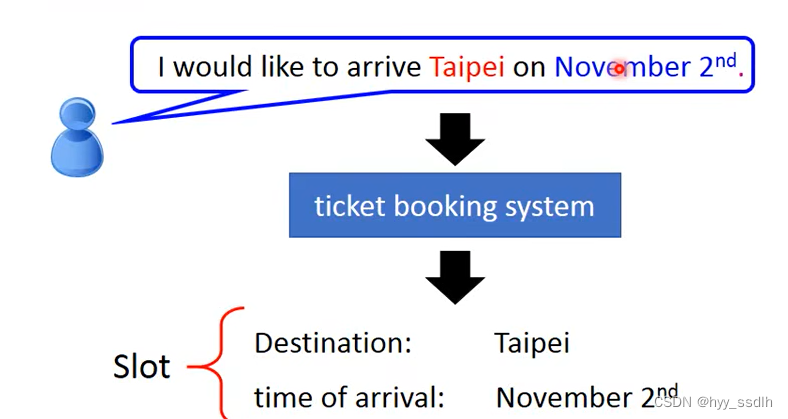
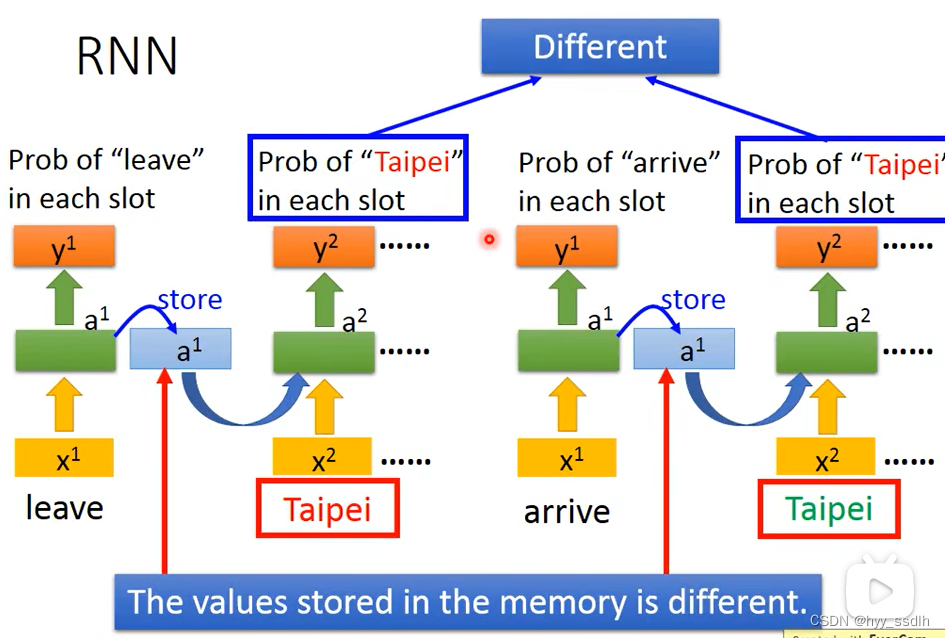
对于下面的文本,我们可以用模型训练出每一个单词的类型,但是对于Taipei这个单词,我们希望他可以准确到,taipei是出发地还是目的地,若文本前面含有arrive单词,则taipei是目的地,若文本前面单词是leave,则taipei是出发地。因此我们需要神经网络具有记忆的功能。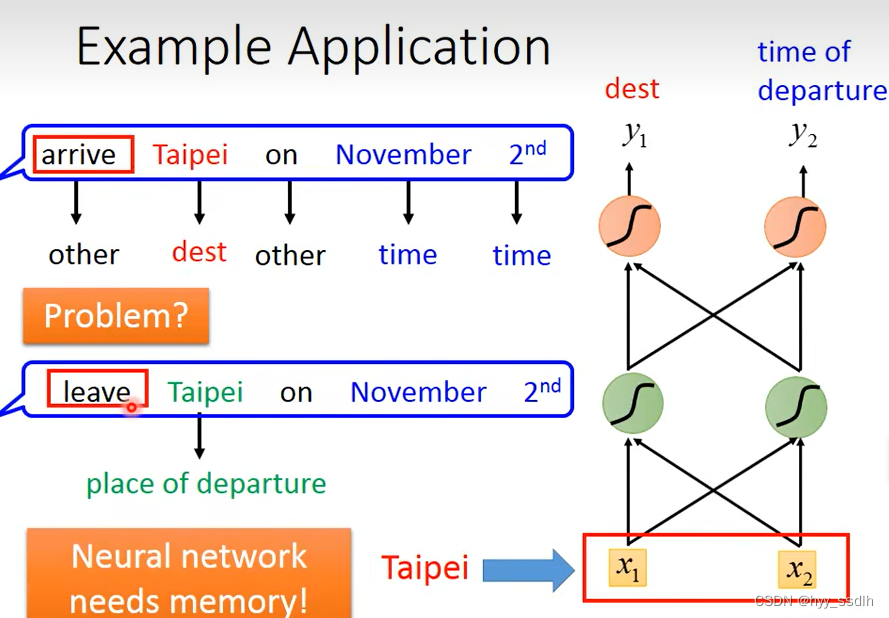
而RNN就是一种有记忆的神经网络。如下图所示,当neuro有output时,会单独存一份数据在a中。而下一次要输入数据时,不单单只考虑输入x,还会把保存的记忆a一起考虑。
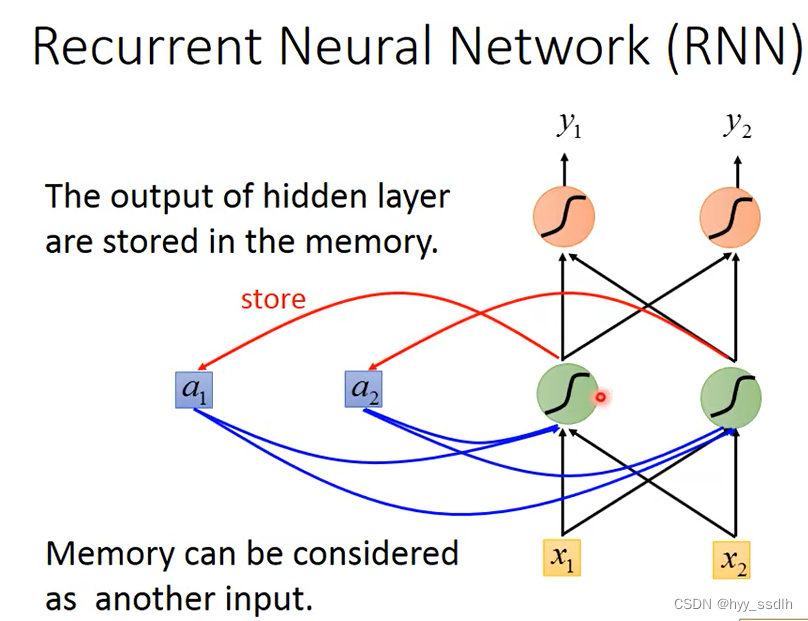
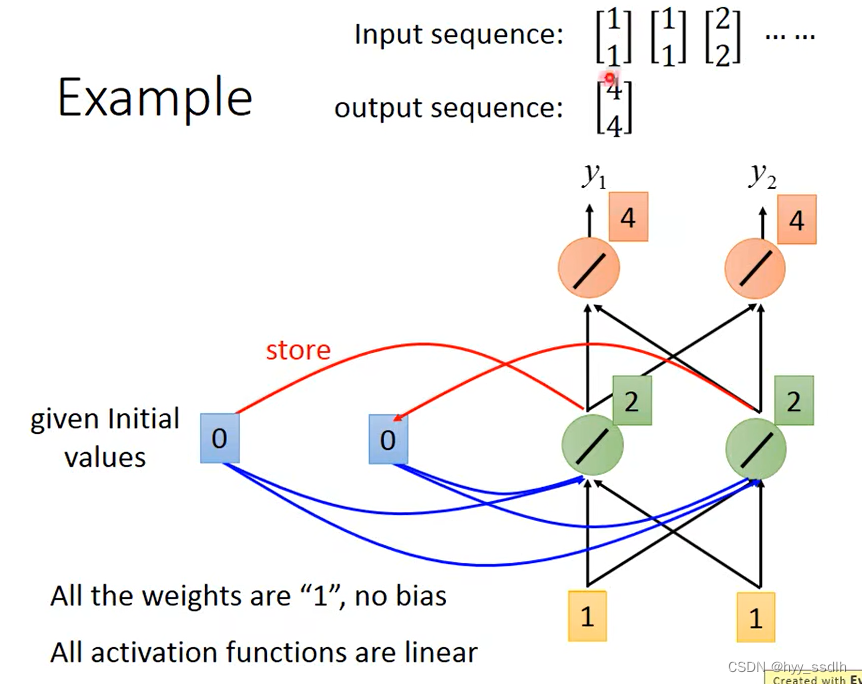
举个例子,假设w全为1,激活函数是Linear,输入神经网络的值为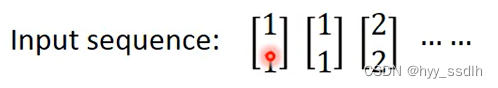
初始memory为0。当输入为[1,1]时。绿色neuro输出为2,橙色neuro输出为4,因为RNN的记忆性。所有memory改为2。
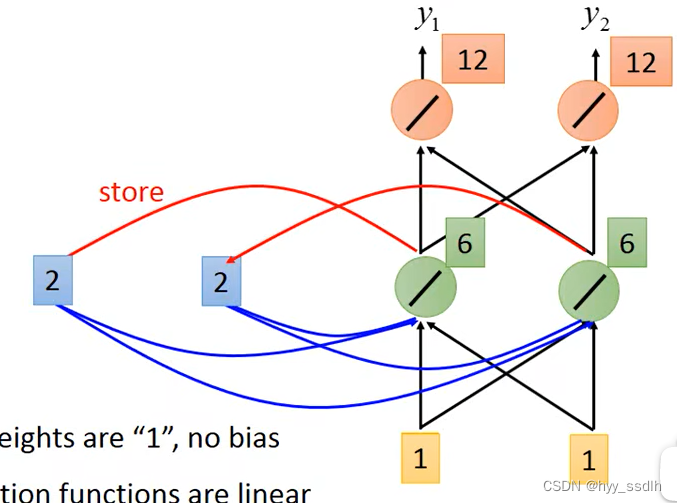
memory改为2后,输入值改为[1,1],得到绿色neuro值为6,橙色neuro为12,所以该次的输出值为[12,12],memory改为6
当输入值为[2,2]时情况如下,memory为6,
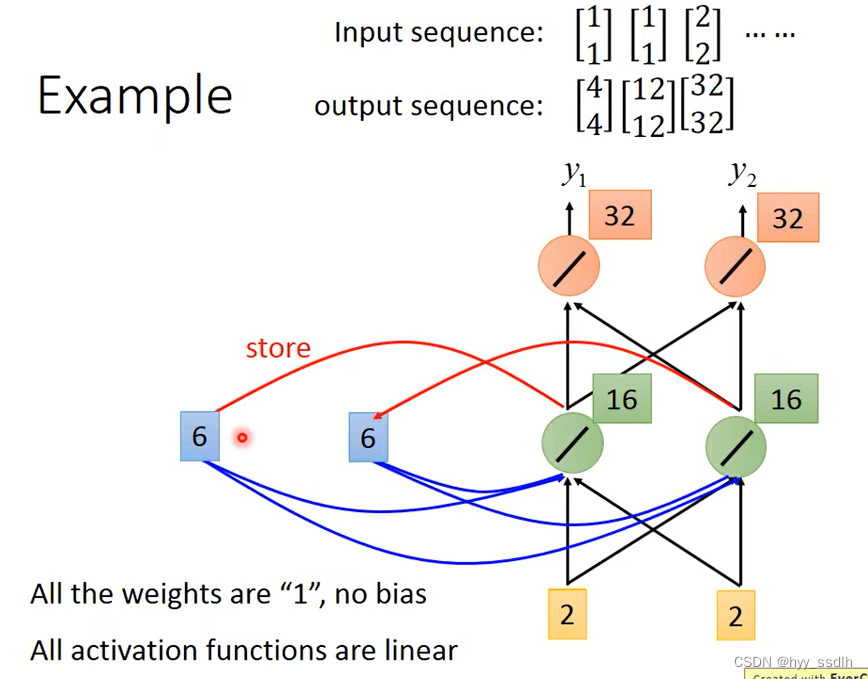
由上可知,若输入数值的顺序改变,则输出值也可能改变。
下图是RNN对文本训练的过程
将arrive单词进行训练,得到a1和y1,y1作为输出表示了arrive单词属于某类型的可能性,a1作为memory存储在a1中,当下一个单词Taipei需要训练时,会将输入x2和a1同时考虑,得到了a2和y2,y2作为输出表示了单词类型的可能性,a2作为memory存储在a2中供下一个单词使用。后面的每个单词以此类推。
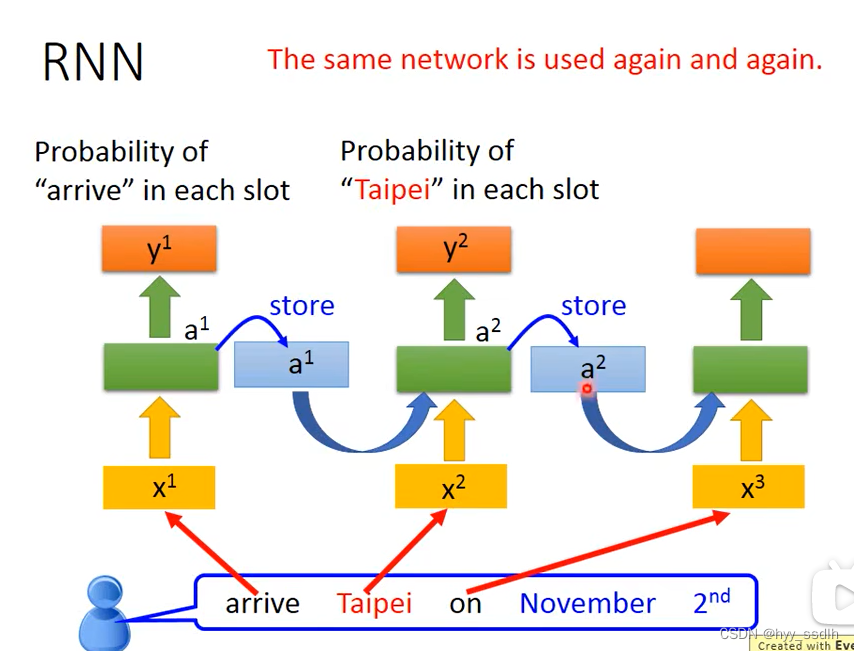
有了memory后,输入同一词汇输出不同类型的问题就会得到解决。下图中由于leave和arrive是不同的词汇,所得到的的memory也是不同的,因此单词 taipei的输出也是不同的。
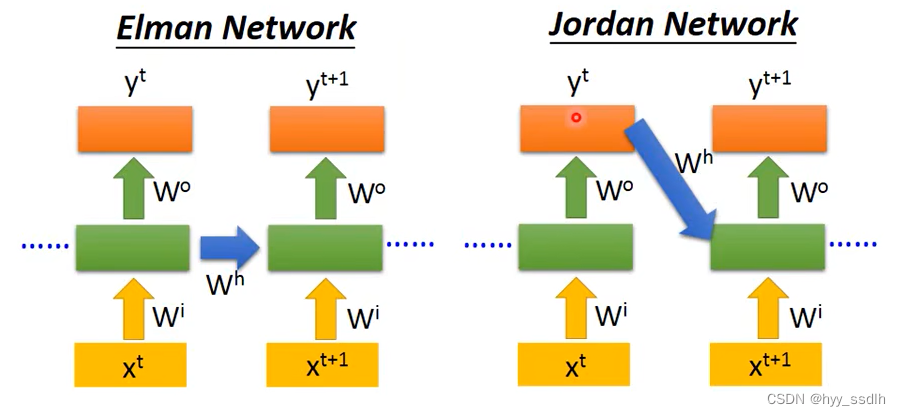
RNN有两种类型分别是Elman network和Jordan Network,Jordan Network是将输出值当做memory存储。
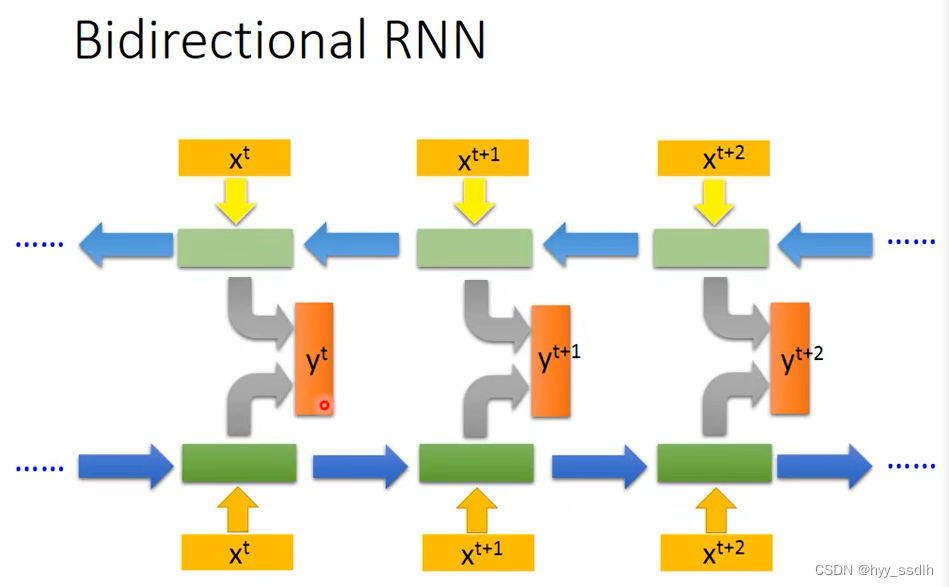
RNN可以是双向的,如下图,正向和反向的输出进行整合得到一个整的输出,双向的RNN可以看的更广。
2、LSTM
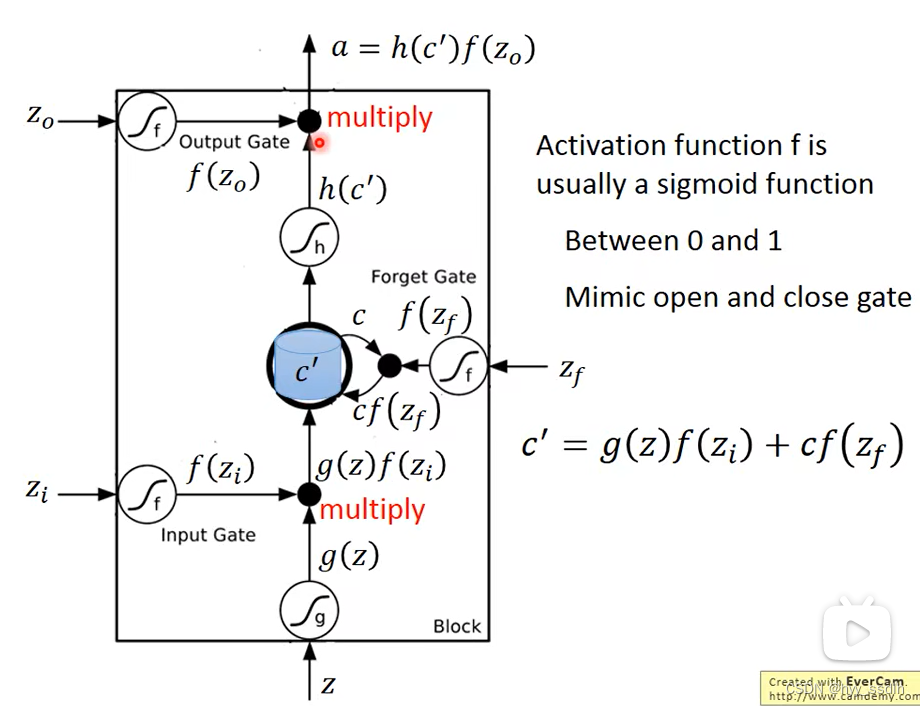
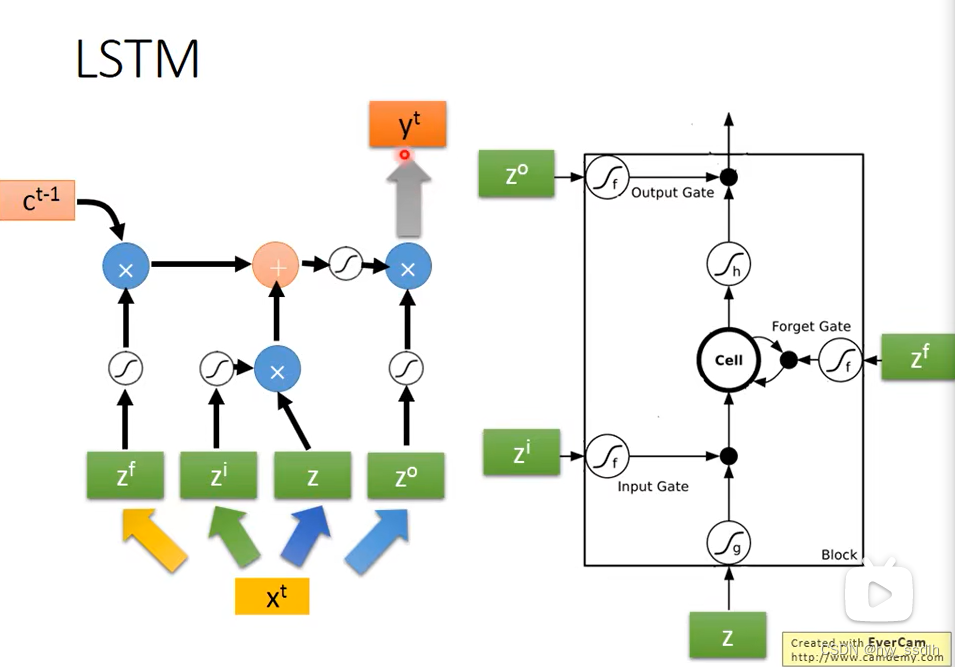
LSTM当neuro的输出想要写入memory时,必须先通过一个闸门input gate。当外界想要使用memory时也需要通过一个闸门output gate。这里闸门的开合由neuro自己学习得到。闸门forget Gate可以将memory中的数据更新。整个LSTM可以看做有四个输入,一个输出,四个输入分别为,进入网络的部分、操纵input闸门的信号、操作output闸门的信号、操作forget闸门的信号。
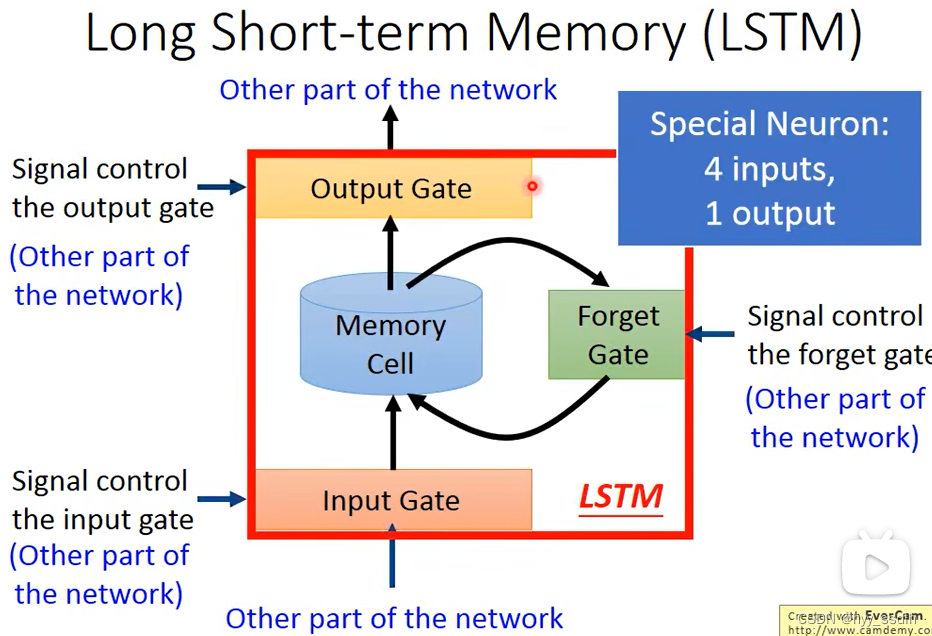
下图中假设输入为Z,memory中存放着C ,则输出应该为多少
下图中f常用sigmoid function,输出值在0-1之间可以较好的判断闸门的打开和闭合。
输入Z,经过g得到g(z),zi经过f得到f(zi),将g(z)和f(zi)相乘得到g(z)f(zi)
zf通过f得到f(zf),c*f(zf),之后将两者加起来得到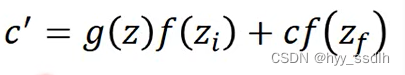 将c更新成
,
是新的存储在memory中的值。
通过h得到h(
),z0通过f得到f(z0),若f(z0)=1,则表示同意拿取该memory,输出h(
)f(z0),若f(z0)=0,则表示不同意拿取,输出值为0
下面举个例子
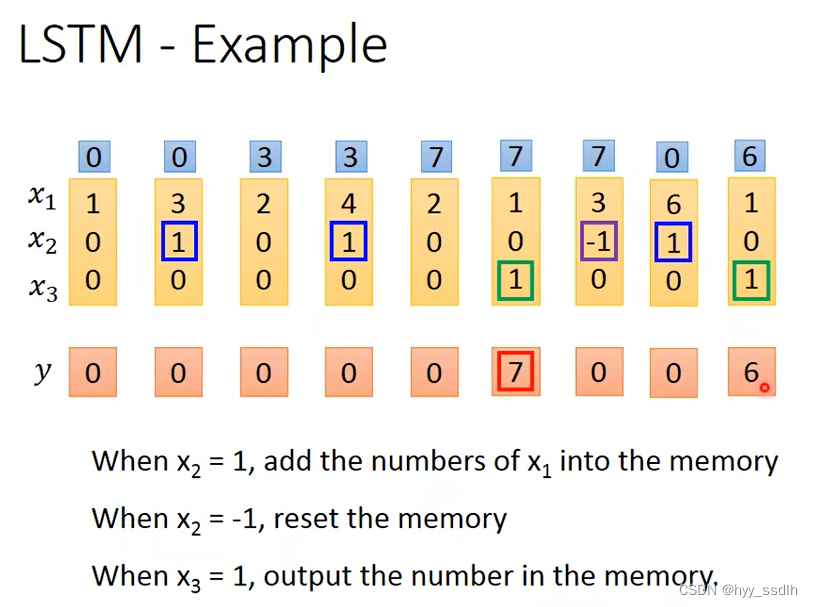
network中有一个LSTM,input是三维的,output是一维的。对于input,当x2=1,则将x1的值写入memory,x2=-1,memory中的值会被遗忘,x3=1,memory数值才可以被使用。初始化memory为0,因为第二列中x2=1,所以memory更新为3,后面的以此类推。
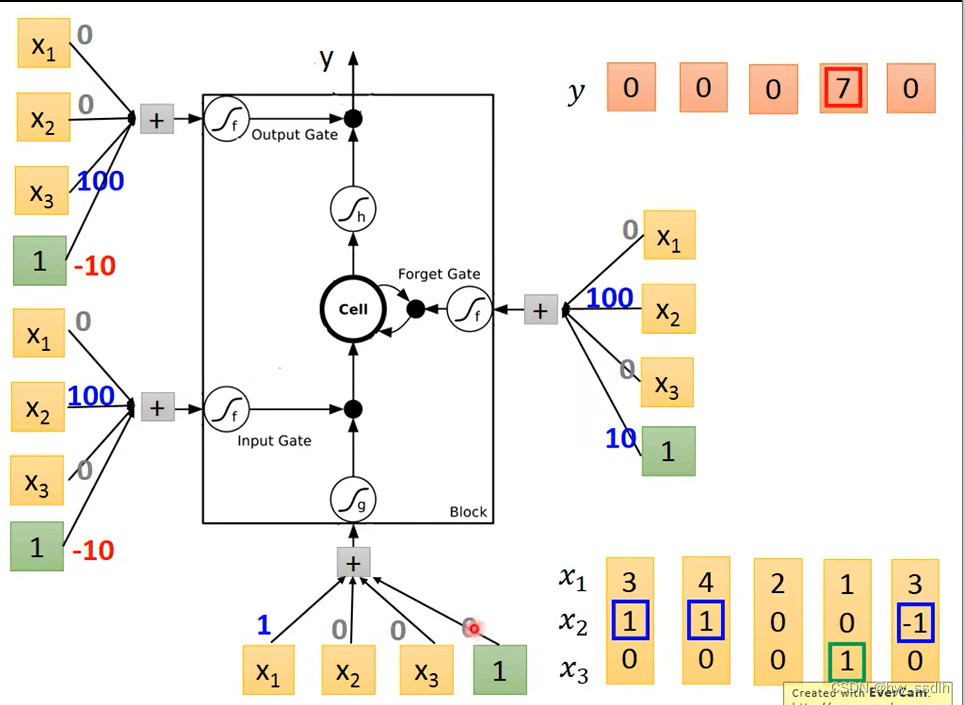
接下来我们实际运算一下,假设初始memory=0。
首先input3,1,0。得到g=3,input gate≈1,forget gate≈1,output gate≈0 因此输出0,memory=3
接下来input4,1,0.得到g=4,input gate≈1,forget gate≈1,output gate≈0 因此输出0,memory=7
接下来input2,0,0.得到g=2,input gate≈0,forget gate≈1,output gate≈0 因此输出0,memory=7
接下来input1,0,1.得到g=1,input gate≈0,forget gate≈1,output gate≈1 因此输出7,memory=7
接下来input3,-1,0.得到g=3,input gate≈0,forget gate≈0,output gate≈0 因此输出0,memory=0
假设有两个neuro,相同的输入通过不同的weight来使 neuro的每个input都不一样。
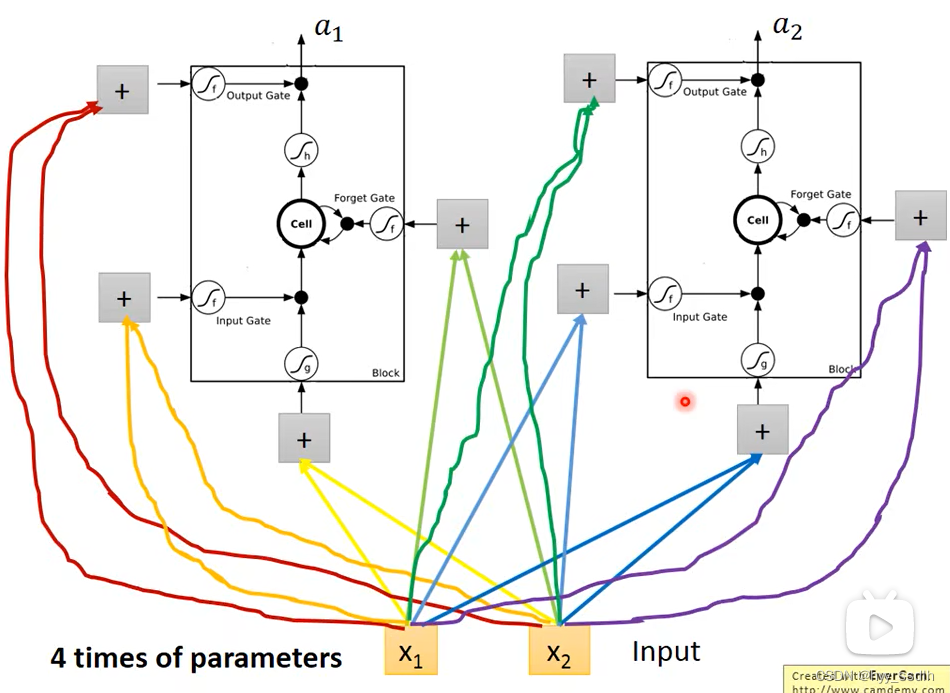
一下是LSTM的计算步骤
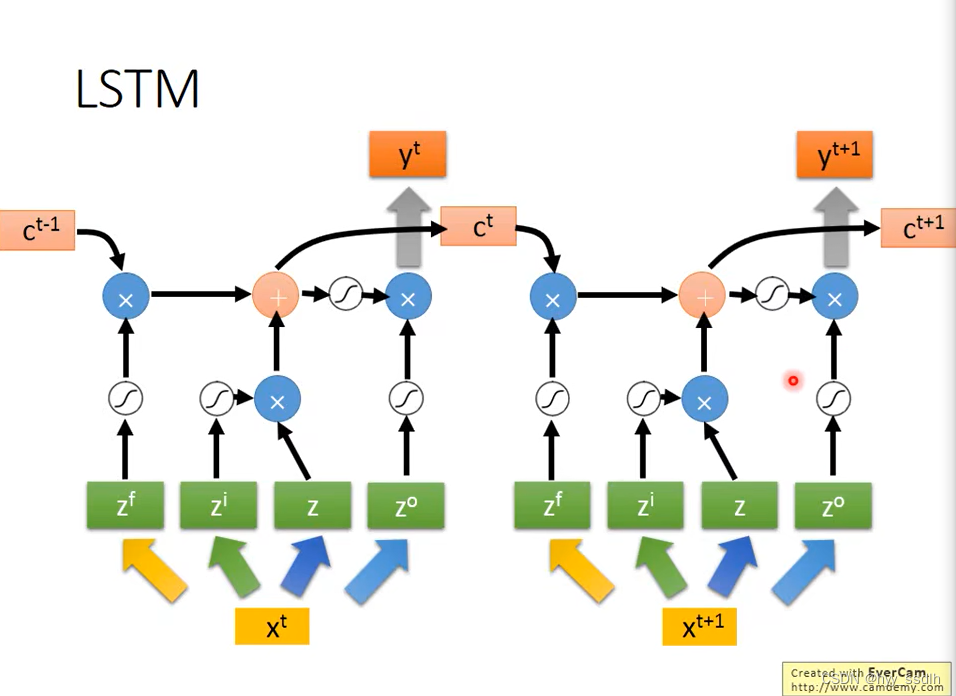
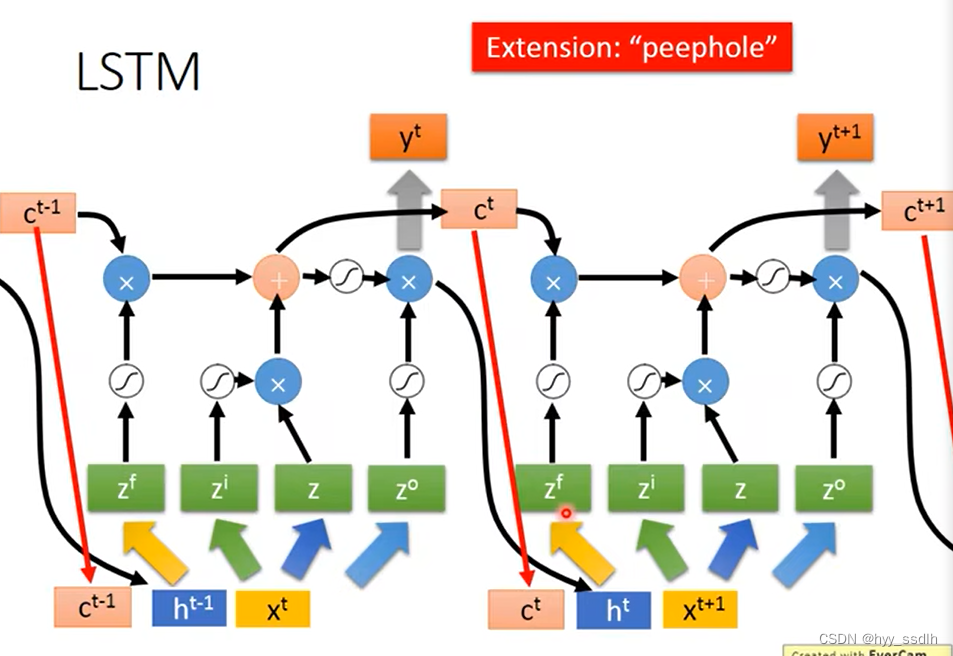
LSTM的最终形态,会将hidden layer的输出接入。以及memory的值也拉进来

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)